
ทำไมแบ็คลิงก์ของคุณไม่แสดงใน Moz? เพราะ Link Explorer รายงานเฉพาะสิ่งที่ครอว์เลอร์ของตัวเองพบและเก็บไว้ในดัชนีของ Moz คู่มือนี้สำหรับ SEO และผู้สร้างลิงก์ที่เห็นลิงก์บนหน้าเพจจริงแต่ไม่เห็นในเครื่องมือ: สาเหตุปกติแปดข้อ การเช็คเจ็ดขั้นตอนสำหรับหนึ่ง URL และวิธีหาแบ็คลิงก์ที่เหลือด้วยแบ็คลิงก์เช็คเกอร์อื่น
สารบัญ
- สารบัญ
- คำตอบสั้นๆ
- 8 เหตุผลที่แบ็คลิงก์ของคุณไม่แสดงใน Moz
- วิธีเช็คว่า Moz เห็นแบ็คลิงก์เฉพาะเจาะจงได้หรือไม่
- Moz อัปเดตดัชนีลิงก์บ่อยแค่ไหน?
- ทำไม Moz, Ahrefs, Majestic และ Semrush แสดงจำนวนแบ็คลิงก์ต่างกัน
- ที่หาแบ็คลิงก์ที่เหลือของคุณ
- วิธีหาแบ็คลิงก์คุณภาพต่ำด้วย Moz
- FAQ
- หนึ่งดัชนีคือภาพบางส่วน
คำตอบสั้นๆ
Moz แสดงเฉพาะแบ็คลิงก์ที่ครอว์เลอร์ Dotbot ค้นพบ ครอวล์ และเพิ่มเข้าดัชนี หากหน้า referring ใหม่ ถูกบล็อก ชี้ canonical ไปที่อื่น มี noindex เรนเดอร์ลิงก์ด้วย JavaScript หรือลิงก์ถูกลบแล้ว มันจะไม่ปรากฏ ไม่มีแบ็คลิงก์เช็คเกอร์ใดเห็นเว็บทั้งหมด ดังนั้นให้เทียบหลายแหล่ง ลิงก์ที่เครื่องมือยังไม่พบยังอาจนับกับ Google ได้ ข้อมูลที่หายจึงไม่เท่ากับมูลค่า SEO ที่สูญเสีย
แม้จะมี ลิงก์กว่า 40 ล้านล้าน ดัชนีก็ “doesn't cover the whole web” (How we index the web)
8 เหตุผลที่แบ็คลิงก์ของคุณไม่แสดงใน Moz
- ลิงก์ใหม่เกินไป
- Moz ยังไม่ได้ครอวล์หน้าเพจที่ลิงก์มา
- robots.txt หรือเซิร์ฟเวอร์บล็อก Dotbot
- ลิงก์ถูกเรนเดอร์ด้วย JavaScript
- canonical ของหน้าชี้ไปที่อื่น
- หน้าเพจที่ลิงก์มาเป็น noindex
- ลิงก์ถูกลบ เปลี่ยน หรือรีไดเรกต์
- คุณกำลังดู view ตัวกรอง หรือการส่งออกผิด
1. ลิงก์ใหม่เกินไป
ลิงก์ที่เพิ่งค้นพบอาจปรากฏ “in about 3 days” (Why links aren't appearing) จุดสำคัญคือคำว่า discovered: การค้นพบเองอาจใช้เวลานานกว่านั้นมาก วันที่ค้นพบก็ไม่ใช่วันที่สร้างลิงก์ ดังนั้นลิงก์ “ใหม่” อาจเก่าบนเว็บแล้ว
แล้วแบ็คลิงก์ใช้เวลานานแค่ไหนถึงจะโชว์? เป็นวันสำหรับหน้าที่ลิงก์มามาก เป็นสัปดาห์หรือนานกว่านั้นสำหรับหน้าที่เงียบ เพิ่ม referring URL เข้า Link Tracking List แล้วเฝ้าดู
2. Moz ยังไม่ได้ครอวล์หน้าเพจที่ลิงก์มา
นี่คือคำตอบปกติของ “ทำไมบางลิงก์โชว์บน Moz แต่บางอันไม่” Dotbot ใช้โมเดล machine learning ที่ฝึกให้เลือกหน้าเหมือนที่เสิร์ชเอนจินโชว์ในผล Google มันชั่งน้ำหนัก inbound link ของหน้าเอง คุณภาพของไซต์ที่ชี้มา ความยาว URL และความลึกของโฟลเดอร์ (How we index the web) โฮมเพจที่ลิงก์มามากถูกเยี่ยมเร็ว หน้าที่ฝังลึกสี่โฟลเดอร์บนบล็อกเล็กที่ไม่มี inbound link อาจไม่ถูกเยี่ยมเลย
เพื่อเช็ค ให้ใส่ URL ของหน้า referring ใน Link Explorer หากไม่มีข้อมูลสำหรับหน้านั้น ลิงก์ของคุณก็ไม่อยู่ในดัชนีของ Moz เช่นกัน
3. robots.txt หรือเซิร์ฟเวอร์บล็อก Dotbot
เปิด /robots.txt ของไซต์ referring Disallow ภายใต้ User-agent: * หรือ User-agent: dotbot จะกันบอตไว้ (Dotbot) Dotbot อ่าน robots.txt หนึ่งครั้งต่อไซต์ต่อ index crawl ดังนั้นการแก้ต้องใช้เวลา
ไฟร์วอลล์ การป้องกันบอต และรหัสสถานะ 4xx หรือ 5xx ก็หยุดมันได้ และมีเพียงเจ้าของไซต์ที่ยกบล็อกนั้นได้
4. ลิงก์ถูกเรนเดอร์ด้วย JavaScript
Dotbot ตาม HTML ธรรมดา คือ <a href="..."> ในซอร์สของหน้า สิ่งใดที่วิดเจ็ตหรือสคริปต์แทรกหลังโหลดอาจไม่เคยถูกเห็น ทดสอบด้วย View Source (Ctrl+U) Inspect โชว์หน้าที่เรนเดอร์แล้ว ซึ่งลิงก์ JavaScript ดูปกติแม้บอตจะไม่เคยได้มัน
5. canonical ของหน้าชี้ไปที่อื่น
Dotbot อ่านหน้าเพื่อหาลิงก์เฉพาะเมื่อแท็ก canonical ชี้มาที่ตัวเอง และการจับคู่ต้องตรงทีละตัวอักษร รวมโปรโตคอลและตัวพิมพ์ (Why links aren't appearing) หน้าที่ canonicalize ไป URL อื่นอาจถูกจัดทำดัชนีแต่ไม่ถูกอ่านเนื้อหา
6. หน้าเพจที่ลิงก์มาเป็น noindex
หน้าที่มี noindex, follow หรือ noindex, nofollow จะไม่บันทึก outbound link เช็คแท็ก <meta name="robots"> ในซอร์สและเฮดเดอร์ HTTP X-Robots-Tag
7. ลิงก์ถูกลบ เปลี่ยน หรือรีไดเรกต์
แบ็คลิงก์ที่มาร์กว่า lost หมายความว่า Dotbot กลับไปที่หน้าแล้วหาไม่เจอ หน้าช่วยเหลือบอกว่านั่น “doesn't necessarily mean the link has been removed” (Troubleshooting lost links) 404 การล่ม 5xx ชั่วคราว แท็ก noindex ใหม่ หรือ URL ที่เปลี่ยนหรือ 301-redirect ล้วนให้ป้ายเดียวกัน และข้อผิดพลาดเป็นช่วงๆ จะถูกมาร์ก active อีกครั้งในการเยี่ยมที่ดีครั้งถัดไป นั่นคือทำไมเครื่องมือบางครั้งเรียกลิงก์ที่ยังมีอยู่จริงว่า lost
แบ็คลิงก์เก่าไม่หายจากดัชนีตามเวลา พวกมันโชว์ใน Discovered และ Lost และไซต์ referring นับเป็น lost เฉพาะเมื่อไม่มีลิงก์ใดไปหาคุณที่ยัง active
8. คุณกำลังดู view ตัวกรอง หรือการส่งออกผิด
หากรายงานขาดลิงก์ที่คุณรู้ว่ามีอยู่ ให้เช็คการตั้งค่าก่อน นี่คือวิธีเช็คแบ็คลิงก์ด้วย Moz Link Explorer: ใส่เป้าหมายแล้วเลือก root domain, subdomain หรือ exact page (Inbound Links) ลิงก์ไป blog.example.com จะไม่ปรากฏในการค้นหา exact-page สำหรับ example.com/ Link Type แยก follow, nofollow และ redirected; Link State แยก active จาก lost; และตัวกรองที่ลืมไว้สามารถซ่อนโปรไฟล์แบ็คลิงก์ครึ่งหนึ่ง ด้วยตัวกรอง Link Source คุณเห็นแค่ top 10 จากแหล่งนั้น และการเรียงหรือกรองใดๆ มอง top 100,000 ลิงก์ทั้งหมด
การดาวน์โหลดก็มีขีดจำกัด บัญชีฟรีได้ 10 คิวรีต่อเดือน (Link Explorer) และแพ็กเกจ Moz Pro จำกัด “Results per Backlink Query” (pricing) CSV ที่มีตัวกรองเปิดอยู่คืนเฉพาะแถวที่กรองแล้ว
ลิงก์ภายในเป็นเครื่องมือแยก การตรวจสอบไซต์มาจาก Rogerbot บอตหลัง Moz Pro Site Crawl (Rogerbot) หากเครื่องมือ “ไม่อ่านลิงก์ภายในของคุณ” หรือตัวเลขในออดิทดูเพี้ยน ให้ดูใน Site Crawl ไม่ใช่ Link Explorer
วิธีเช็คว่า Moz เห็นแบ็คลิงก์เฉพาะเจาะจงได้หรือไม่
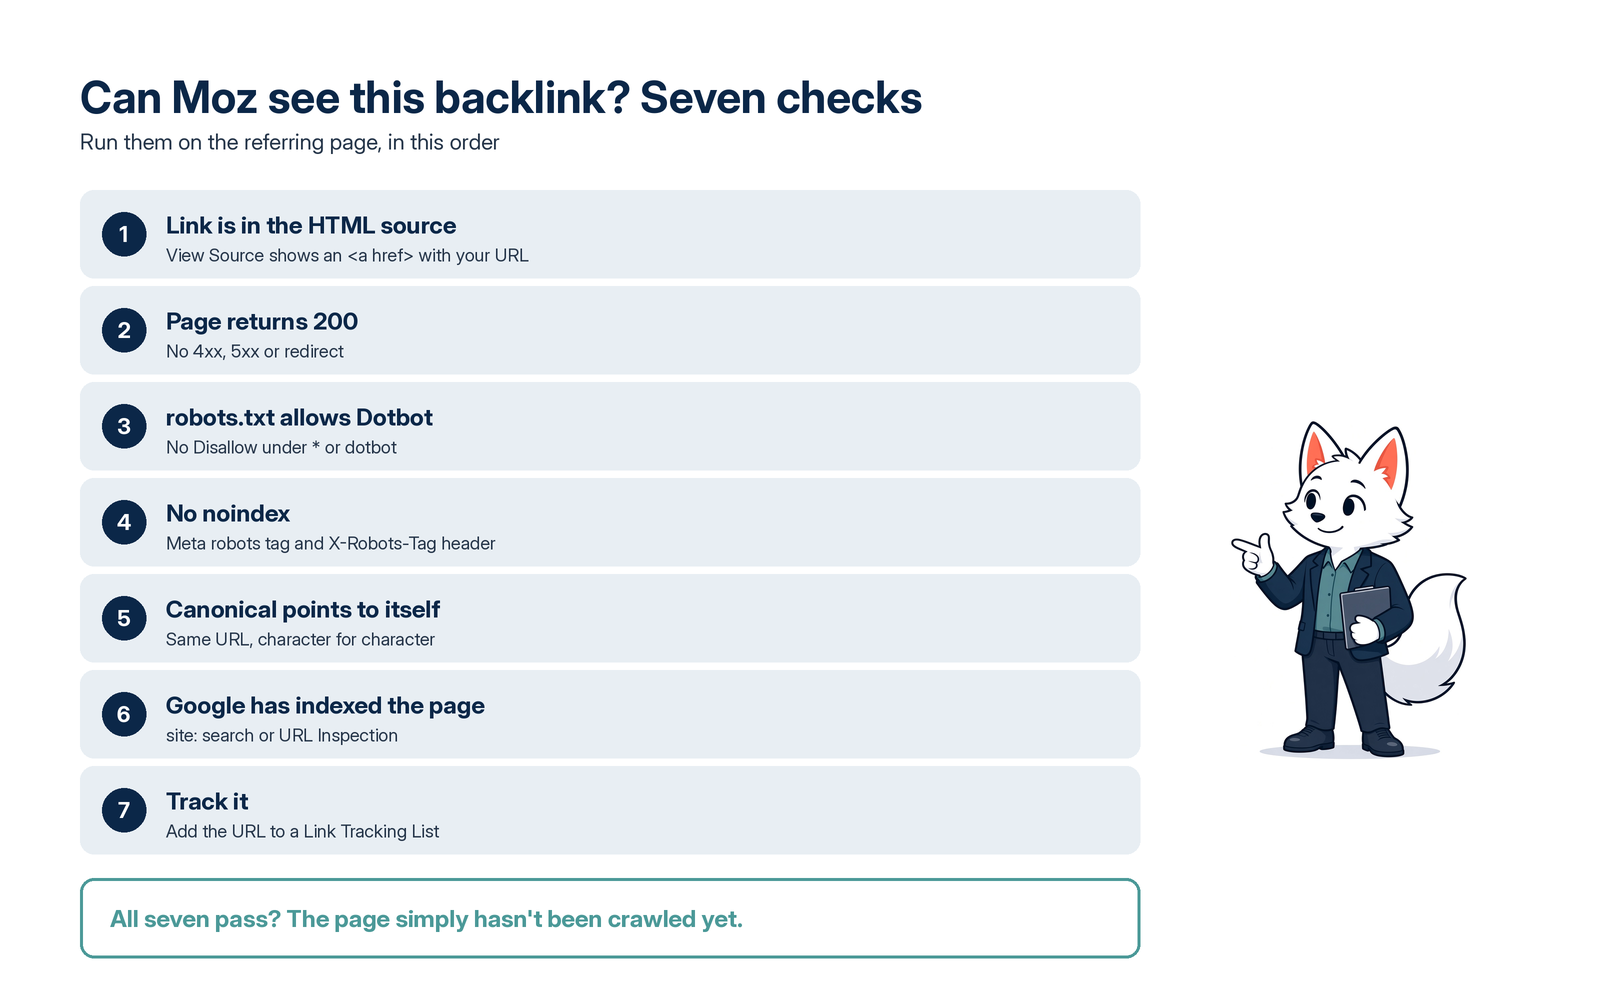
รันเจ็ดขั้นตอนนี้บนหน้า referring:
- หาลิงก์ของคุณใน View Source และยืนยันว่าอยู่ใน
href - เช็คว่าหน้าคืนสถานะ 200 และไม่รีไดเรกต์
- เปิด robots.txt ของไซต์แล้วมองกฎภายใต้
User-agent: *และUser-agent: dotbot - มองหา
noindexในเมตา robots หรือเฮดเดอร์X-Robots-Tagดูrelของลิงก์ด้วย: nofollow, ugc และ sponsored เปลี่ยนวิธีนับลิงก์ ไม่ใช่ว่าหาเจอได้หรือไม่ - เทียบแท็ก canonical กับ URL ของหน้าทีละตัวอักษร
- ยืนยันว่า Google จัดทำดัชนีหน้าแล้วด้วยการค้นหา
site:หรือ URL Inspection หากเป็นไซต์ของคุณ - เพิ่ม URL เข้า Link Tracking List แล้วกลับมาเช็คในอีกไม่กี่วัน
หากทั้งเจ็ดผ่าน แสดงว่าหน้าเพจยังไม่ถูกครอวล์เท่านั้น
Moz อัปเดตดัชนีลิงก์บ่อยแค่ไหน?
ดัชนีถูกอธิบายว่า “constantly updating” (How we index the web) ลิงก์ใหม่ปรากฏประมาณสามวันหลังค้นพบ หน้าคุณภาพสูงถูกเยี่ยมซ้ำอย่างน้อยทุก 90 วัน และสิ่งส่วนใหญ่ในดัชนีมาจากหน้าที่ครอวล์ในหกเดือนล่าสุด Domain Authority และ Page Authority เปลี่ยนเฉพาะเมื่อพบลิงก์ใหม่หรือ lost สำหรับไซต์นั้น MozBar โชว์ DA และ PA เดียวกัน หากอยากขยับตัวเลขเหล่านั้น นี่คือ วิธีเพิ่ม Moz Domain Authority
คุณบังคับ recrawl ไม่ได้; Link Tracking List เฝ้าการค้นพบโดยไม่รับประกันวันที่
ทำไม Moz, Ahrefs, Majestic และ Semrush แสดงจำนวนแบ็คลิงก์ต่างกัน
ทุกฐานข้อมูลแบ็คลิงก์รันบอตของตัวเอง เลือกหน้าที่จะเยี่ยม และนับด้วยวิธีของตัวเอง FAQ ของ Moz บอกว่าแต่ละดัชนี “will build up a slightly different picture of the web” จึงเป็นเหตุที่ SEO หลายคนรวมหลายเครื่องมือ SEO
| เครื่องมือ | Crawler | การนับหลัก | ที่ดู |
|---|---|---|---|
| Moz | Dotbot | Linking Domains, Domain Authority | Link Explorer |
| Ahrefs | AhrefsBot | Referring domains, Domain Rating | Site Explorer |
| Majestic | MJ12bot | Referring domains, Trust Flow | Site Explorer |
| Semrush | SemrushBot | Referring domains, Authority Score | Backlink Analytics |
ช่องว่างมาจากลำดับความสำคัญของครอวล์ ความสดใหม่ ระยะเวลาที่ลิงก์ที่ถูกลบยังถูกนับ และว่า nofollow กับ redirected รวมหรือไม่ ใหญ่กว่าไม่ใช่ดีกว่าโดยอัตโนมัติ ดังตัวอย่างด้านล่าง
ที่หาแบ็คลิงก์ที่เหลือของคุณ
Google Search Console: รายงาน Links
สำหรับไซต์ของคุณเอง นี่คือข้อมูลของ Google แต่ยังเป็นตัวอย่าง: รายงาน “isn't a comprehensive list of every link” ตารางหยุดที่ 1,000 แถว ไม่มาร์ก nofollow และลิงก์ที่ถูกลบอาจค้างอยู่ (Search Console Help: Links report) การดาวน์โหลดได้ถึง 100,000 แถว
Bing Webmaster Tools: Backlinks
รายงานของ Bing ฟรีและโชว์ referring domains หน้า และแองเคอร์สำหรับไซต์ที่ยืนยันแล้ว และ “Backlinks to any site” เทียบคุณกับคู่แข่งสูงสุดสองไซต์ที่คุณไม่ได้เป็นเจ้าของ (Bing Webmaster Tools Help: Backlinks) Bing เรียกข้อมูลว่า “a representative set” ไม่ใช่โปรไฟล์เต็ม
แบ็คลิงก์เช็คเกอร์อื่น
Ahrefs Free เดิม Ahrefs Webmaster Tools โชว์แบ็คลิงก์สูงสุด 1,000 ต่อครั้งสำหรับไซต์ที่ยืนยัน Majestic และ Semrush รันฐานของตัวเอง; เช็คขีดจำกัดฟรีปัจจุบัน สำหรับคู่แข่งหรือชื่อที่อาจซื้อ คุณต้องเข้าถึงแบบเสียเงินหรือเครื่องมือที่เก็บเมตริกของพวกเขาอยู่แล้ว
เทียบฐานข้อมูลลิงก์ทั้งหมดในรายงานเดียว
Karma.Domains เก็บเมตริก Moz, Ahrefs, Majestic และ Semrush เคียงข้างกันสำหรับโดเมนกว่า 13M ดังนั้นฉันเห็นช่องว่างเหล่านี้ทุกวัน นี่คืออันที่ฉันดึงเมื่อ 3 พฤศจิกายน: ky-ebricks.com ไซต์ที่หมดอายุซึ่งขายคู่มือประกอบที่เข้ากันกับ LEGO
| แหล่ง (เช็ค 3 พฤศจิกายน) | Referring domains | Backlinks |
|---|---|---|
| Moz, รายงาน Karma.Domains | 600 | 997 |
| Moz, เช็คสดวันเดียวกัน | 635 | 1,026 |
| Semrush, รายงาน Karma.Domains | 358 | 510 |
| Majestic, รายงาน Karma.Domains | 101 | 128 |
| DataForSEO API, ลิงก์สด | 138 | 205 |
นั่นคือช่วงหกเท่าบนโดเมนเดียว และ Ahrefs ให้ DR 0.5
ดังนั้นฉันเปิดดู ในตัวอย่าง 38 ลิงก์ของ Moz มี 33 มาจากหน้าไดเรกทอรี “domain-list” ที่เกือบเหมือนกัน ฉันเช็คเจ็ดอัน: สองโฮสต์ไม่ตอบ สองคืน 404 หนึ่งรีไดเรกต์ และสองที่โหลดได้ไม่มีลิงก์แล้ว แบ็คลิงก์คุณภาพ จากฟอรัมแฟน LEGO และบล็อกงานอดิเรกสองอัน ยังมีอยู่ ใน HTML ธรรมดา บนหน้า self-canonical ความนำของ Moz ส่วนใหญ่มาจากหน้าไดเรกทอรีที่ ในตัวอย่างที่ฉันเปิด ไม่ชี้ไปที่ไซต์นั้นอีกแล้ว
จำนวนสูงอาจเป็นแค่การเติม ดังนั้นอ่านหน้า referring ในมากกว่าหนึ่งเครื่องมือก่อนเชื่อตัวเลขใดตัวเดียว หากจะเทียบแหล่งเอง ดูว่าเรโชว์ ข้อมูล Moz ในรายงาน Karma.Domains อย่างไร พร้อม ข้อมูล Ahrefs ข้อมูล Majestic และ ข้อมูล Semrush หรือ รวมตัวกรอง Moz, Ahrefs และ Majestic ในการค้นหาเดียว
วิธีหาแบ็คลิงก์คุณภาพต่ำด้วย Moz
เริ่มจาก referring sites (Moz เรียก Linking Domains): เปิดรายงานนั้นแล้วเรียงตาม Spam Score Spam Score คือเปอร์เซ็นต์ของไซต์ที่มีฟีเจอร์คล้ายกันที่พบว่าถูกลงโทษหรือแบนโดย Google และ 1% ถึง 30% นับว่าต่ำ (Moz: Spam Score) คะแนนสูงเป็นเหตุให้ดูใกล้ ไม่ใช่หลักฐานสแปม คุณสามารถ เช็ค Spam Score ฟรี บนไซต์ใดก็ได้
แล้วอ่านข้อความแองเคอร์ แองเคอร์ส่วนใหญ่เป็นโดเมนเปล่า คีย์เวิร์ด exact-match หรือแบบโฆษณา ชี้ไปที่ลิงก์สแปมจากไดเรกทอรีและหน้าสร้างอัตโนมัติ ในตัวอย่าง ky-ebricks.com 86.84% ของแองเคอร์เป็นแค่ “ky-ebricks.com” และอันหนึ่งอ่านว่า “Boost ky-ebricks.com For Ahrefs DR, Moz DA, & Majestic TF with Quality Dofollow Backlinks.” คุณสามารถ เช็คข้อความแองเคอร์แบ็คลิงก์ แบบเดียวกัน
สุดท้าย เช็คว่า referring sites เกี่ยวกับอะไร ฟอรัม LEGO ที่ชี้ไปไซต์ LEGO เป็นโปรไฟล์แบ็คลิงก์ปกติ; ไดเรกทอรีไม่เกี่ยวข้อง 33 อันไม่ใช่ ก่อน disavow อะไร ให้เปิดหน้าเหล่านั้น: จำนวนที่ดู toxic มักเป็นหน้าไดเรกทอรีที่ตายแล้ว
FAQ
ทำไม Moz ไม่แสดงแบ็คลิงก์ทั้งหมดของฉัน?
หากคุณถามว่า “ทำไม Moz ไม่ดึงแบ็คลิงก์ของฉันขึ้นมา?” คำตอบคือมันแสดงเฉพาะสิ่งที่ Dotbot ค้นพบ ครอวล์ และจัดทำดัชนี ลิงก์บนหน้าใหม่ ลึก ถูกบล็อก noindex หรือไม่ canonical และที่เพิ่มด้วย JavaScript มักไม่ถึงเลย ช่องว่างบางอย่างเป็นเรื่องปกติสำหรับเครื่องมือ SEO ใดๆ
ทำไม Moz มาร์กแบ็คลิงก์เป็น lost ทั้งที่ยังมีอยู่?
มักเพราะ Dotbot เจอข้อผิดพลาดเมื่อกลับไป: timeout, 5xx, 404, 301 หรือแท็ก noindex ใหม่ ดังที่กล่าวข้างต้น lost “doesn't necessarily mean the link has been removed” หากหน้าโหลดและลิงก์อยู่ในซอร์ส ควรกลับเป็น active หลังครอวล์ที่ดีครั้งถัดไป
หากแบ็คลิงก์ยังไม่โชว์หลังหลายสัปดาห์ล่ะ?
รันการเช็คเจ็ดขั้นตอนบนหน้า referring หากผ่าน หน้าเพจอาจมี inbound link ของตัวเองน้อยเกินไปที่จะถูกครอวล์เร็วๆ นี้ และการรออาจเป็นทางเลือกเดียว
ฉันหาแบ็คลิงก์ที่พังได้อย่างไร?
ใน Link Explorer ตั้ง Link State เป็น Lost แล้วเปิดหน้า referring 404 หรือ 301 ไปหน้าไม่เกี่ยวข้องหมายความว่าลิงก์หาย สำหรับลิงก์ที่คุ้มค่าที่จะเก็บ อีเมล outreach สั้นๆ ถึงเจ้าของไซต์พร้อม URL ที่ถูกต้องอาจซ่อมได้ เช็คลิงก์พังของตัวเองด้วย: ชี้หน้าถูกลบบนไซต์คุณไปยังหน้าที่ยังมีด้วย 301
ทำไม Moz ไม่ส่งออกลิงก์ทั้งหมด?
มักเป็นตัวกรองหรือเพดานแถว CSV คืนเฉพาะแถวที่ตรงกับตัวกรองที่เปิดอยู่ และเพดานแถวขึ้นกับแพ็กเกจของคุณ ล้างตัวกรอง เช็คการตั้งค่า root domain หรือ exact page แล้วดาวน์โหลดอีกครั้ง
ฉันบังคับให้ Moz ครอวล์แบ็คลิงก์ของฉันได้ไหม?
ไม่ได้ คุณขอครอวล์หรือ ping อะไรไม่ได้ เพิ่ม referring URL เข้า Link Tracking List เพื่อเฝ้าการค้นพบ และให้แน่ใจว่าแต่ละหน้าคืน 200 ไม่ใช่ noindex canonicalize มาที่ตัวเอง และมีลิงก์ใน HTML ธรรมดา
ทำไม Moz แสดงแบ็คลิงก์น้อยกว่า Semrush หรือ Ahrefs?
บ่อยครั้งใช่ แต่ไม่เสมอไป: แต่ละเครื่องมือรันครอว์เลอร์ของตัวเองด้วยลำดับความสำคัญและกฎการนับของตัวเอง ดังนั้น Moz อาจโชว์น้อยกว่าหรือมากกว่า ในตัวอย่างของเรา มันรายงาน referring sites มากที่สุดจากทุกแหล่ง ส่วนใหญ่จากหน้าไดเรกทอรี
หนึ่งดัชนีคือภาพบางส่วน
แบ็คลิงก์ที่ไม่โชว์ใน Moz มักเป็นคำถามเรื่องครอวล์หรือการนับ ไม่ใช่ปัญหา SEO ของไซต์คุณ รันเจ็ดขั้นตอนบนหน้า referring เทียบ Search Console, Bing และแบ็คลิงก์เช็คเกอร์อีกตัว และตัดสินแต่ละลิงก์จากหน้า ไม่ใช่จากตัวเลข จะซื้อโดเมนเพื่อลิงก์? เปิดตัวอย่างหน้า referring ก่อนประมูล และอ่านคู่มือของเราเรื่อง โดเมนหมดอายุที่มีแบ็คลิงก์ดี ก่อน เมื่อพร้อม คุณสามารถ หาโดเมนหมดอายุที่มีแบ็คลิงก์ที่ยืนยันแล้ว บน Karma.Domains หรือเรียกดู รายการโดเมนหมดอายุที่มีแบ็คลิงก์