
La plupart des workflows « IA pour le SEO » commencent et se terminent encore dans une fenêtre de chat. Vous demandez une liste de mots-clés, un plan ou un résumé d’audit. Le modèle répond, et une personne porte le résultat dans l’outil suivant. Le SEO agentique, l’usage pratique d’agents IA pour le travail SEO, déplace une partie de ce travail hors de la boîte de réponse. L’agent peut choisir un outil, récupérer des données actuelles, appliquer une règle, inspecter le résultat et décider quelle étape doit venir ensuite. Ahrefs décrit le SEO agentique comme l’application d’agents IA aux workflows pour qu’ils puissent agir, s’adapter et se rétablir plutôt que seulement générer du texte. Cette distinction est particulièrement utile en recherche de domaines, où le travail est répétitif mais la décision finale ne l’est pas. (Ahrefs: What Is Agentic SEO?)
Je trouve que la recherche de domaines est l’un des endroits les plus propres pour utiliser ce modèle. Les preuves sont structurées, la séquence peut être décrite, et chaque action coûteuse peut rester derrière une validation humaine.
Sommaire
- Sommaire
- Ce que change le SEO agentique : chatbot, automatisation et agent
- Pourquoi la recherche de domaines convient à un agent
- La stack derrière la recherche agentique de domaines
- Un workflow agentique complet de recherche de domaines
- 1. Traduire le brief en critères structurés
- 2. Chercher dans l’inventaire actuel
- 3. Filtrer l’identité précédente du domaine
- 4. Traiter les données manquantes délibérément
- 5. Comparer les survivants et préserver l’état
- 6. Dépenser les données premium sur une liste courte
- 7. Surveiller les enregistrements qui comptent
- 8. Demander à un humain de décider
- MCP, API et webhooks ont des rôles séparés
- Les garde-fous rendent l’agent utile
- Comment commencer sans construire un grand système d’agents
- FAQ
Ce que change le SEO agentique : chatbot, automatisation et agent
| Approche | Ce qui pilote l’étape suivante | Bon usage en recherche de domaines | Limite principale |
|---|---|---|---|
| Chatbot | Le prochain message de l’utilisateur | Expliquer un rapport ou aider à concevoir des filtres | Il s’arrête quand la conversation s’arrête |
| Automatisation fixe | Des conditions préécrites | Lancer une recherche sauvegardée chaque matin et ajouter des lignes à une base | Elle gère mal les exceptions |
| Agent IA | Un objectif, des outils, un état et des règles d’exploitation | Chercher, inspecter, comparer, annoter, surveiller et préparer une shortlist | Il a besoin de contrats de données solides et de limites d’autorité claires |
Un agent mérite sa place lorsqu’il peut opérer sur le système de recherche : appeler l’outil de recherche, ouvrir des rapports, sauvegarder l’état et renvoyer des preuves qu’une autre personne peut vérifier. Ahrefs fait le même point dans son guide SEO agentique : un agent ne raisonne pas mieux que le modèle dans une fenêtre de chat, donc le gain vient des outils, du contexte et de la capacité à se rétablir après une étape échouée.
Le SEO agentique se confond aussi facilement avec le GEO. Le SEO agentique concerne la façon dont le travail est réalisé ; le GEO concerne la visibilité dans les expériences de recherche générées par l’IA. Les termes se chevauchent en conversation, mais décrivent des problèmes différents.
Pourquoi la recherche de domaines convient à un agent
La recherche de domaines expirés a quatre propriétés que les agents gèrent bien.
Premièrement, le vivier de candidats change en permanence. De nouveaux domaines arrivent, les prix d’enchères bougent, les offres changent et les annonces se terminent. Le processus bénéficie d’exécutions planifiées ou déclenchées par des événements.
Deuxièmement, le premier passage de filtrage est fondé sur des règles. Une équipe peut préciser les TLD, les langues, les sujets, les plafonds de prix, l’âge minimum, les signaux d’autorité, les sujets interdits, les sources d’enchères et le temps avant la clôture.
Troisièmement, les preuves viennent de plusieurs couches. Un domaine peut paraître fort en Domain Rating et avoir pourtant un historique sans rapport ou toxique. Un autre peut avoir une archive propre et un nom commercial, mais trop peu de valeur de liens pour le projet prévu.
Enfin, le processus a un point de transfert évident. Un agent peut réduire des milliers d’enregistrements à cinq candidats. Une personne décide encore si l’un de ces cinq doit être acheté.
La stack derrière la recherche agentique de domaines
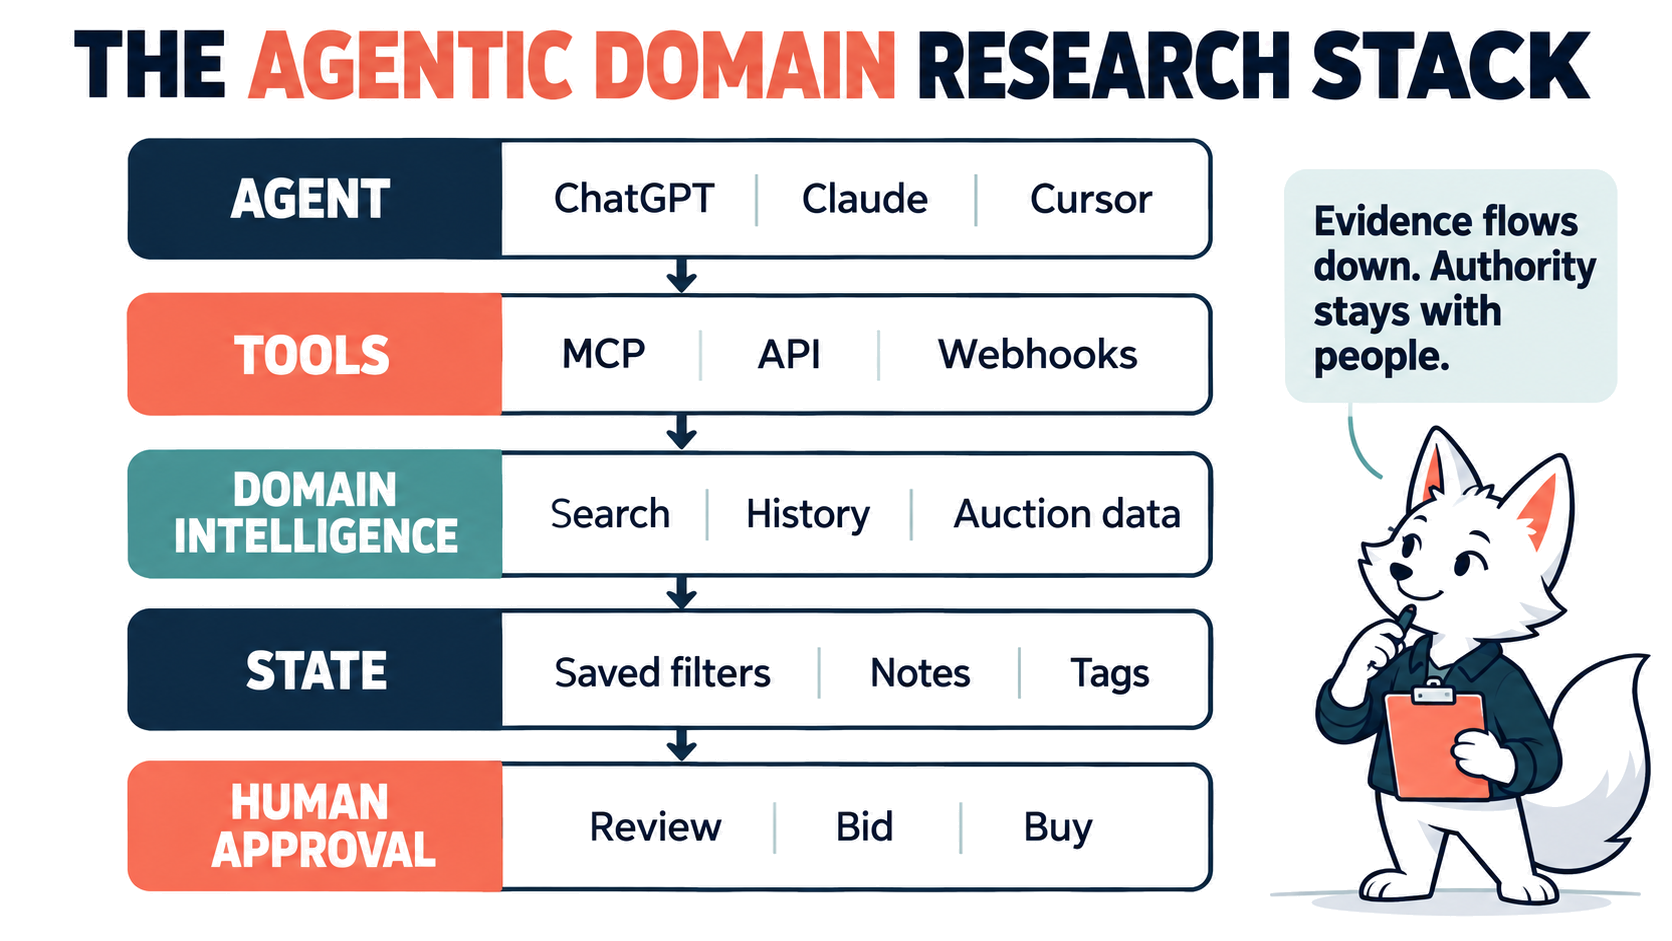
Une stack pratique a cinq parties.
- Un environnement d’agent. Ce peut être ChatGPT, Claude, Cursor, une plateforme d’orchestration ou un agent hébergé capable de tourner selon un planning.
- Des outils de données professionnels. Les serveurs MCP (Model Context Protocol) et les API connectent l’agent aux données actuelles de domaines, backlinks, trafic, enchères et recherche.
- Des instructions d’exploitation réutilisables. Un skill ou un workflow définit les critères de l’équipe, le format de sortie, les règles de budget et les conditions d’escalade. Le guide de Search Engine Land sur les skills d’agents SEO plaide la même chose : donner à l’agent des outils, des modèles et un relecteur plutôt qu’un prompt plus long. (Search Engine Land: How to build SEO agent skills that actually work)
- L’état. Filtres sauvegardés, ID de rapports, notes, tags et une file de revue externe empêchent l’agent de tout recommencer chaque jour.
- La validation humaine. Une personne nommée possède l’offre, l’achat, la revue de marque et toute exception aux règles.
Karma.Domains occupe la couche d’intelligence de domaines dans cette stack. Ce n’est pas un agent SEO IA universel pour le contenu, les correctifs techniques ou la publication. Le produit donne aux agents l’accès à la partie dont ils ont besoin pour l’acquisition de domaines : découverte, filtrage historique, données d’enchères actuelles et un workflow de revue.
La base contient 13M+ domaines issus de 40 sources d’enchères et ajoute en moyenne plus de 400 000 nouveaux domaines par jour. La recherche a 90+ filtres sur l’inventaire enchères, expirés, backorder et buy-now, et le serveur MCP expose 31 outils pour la recherche, les rapports complets, les filtres sauvegardés, les notes et tags, les liens de partage, SEO Enrich et les contrôles live. Les rapports combinent l’analyse d’historique basée sur Wayback avec les données disponibles d’Ahrefs, Majestic, Moz, Semrush, Similarweb et d’autres sources. (Karma.Domains)
La taille compte parce qu’un agent ne peut pas récupérer des candidats qui n’entrent jamais dans ses outils. Les filtres comptent parce que « trouve de bons domaines » n’est pas une règle d’exploitation.
Un workflow agentique complet de recherche de domaines
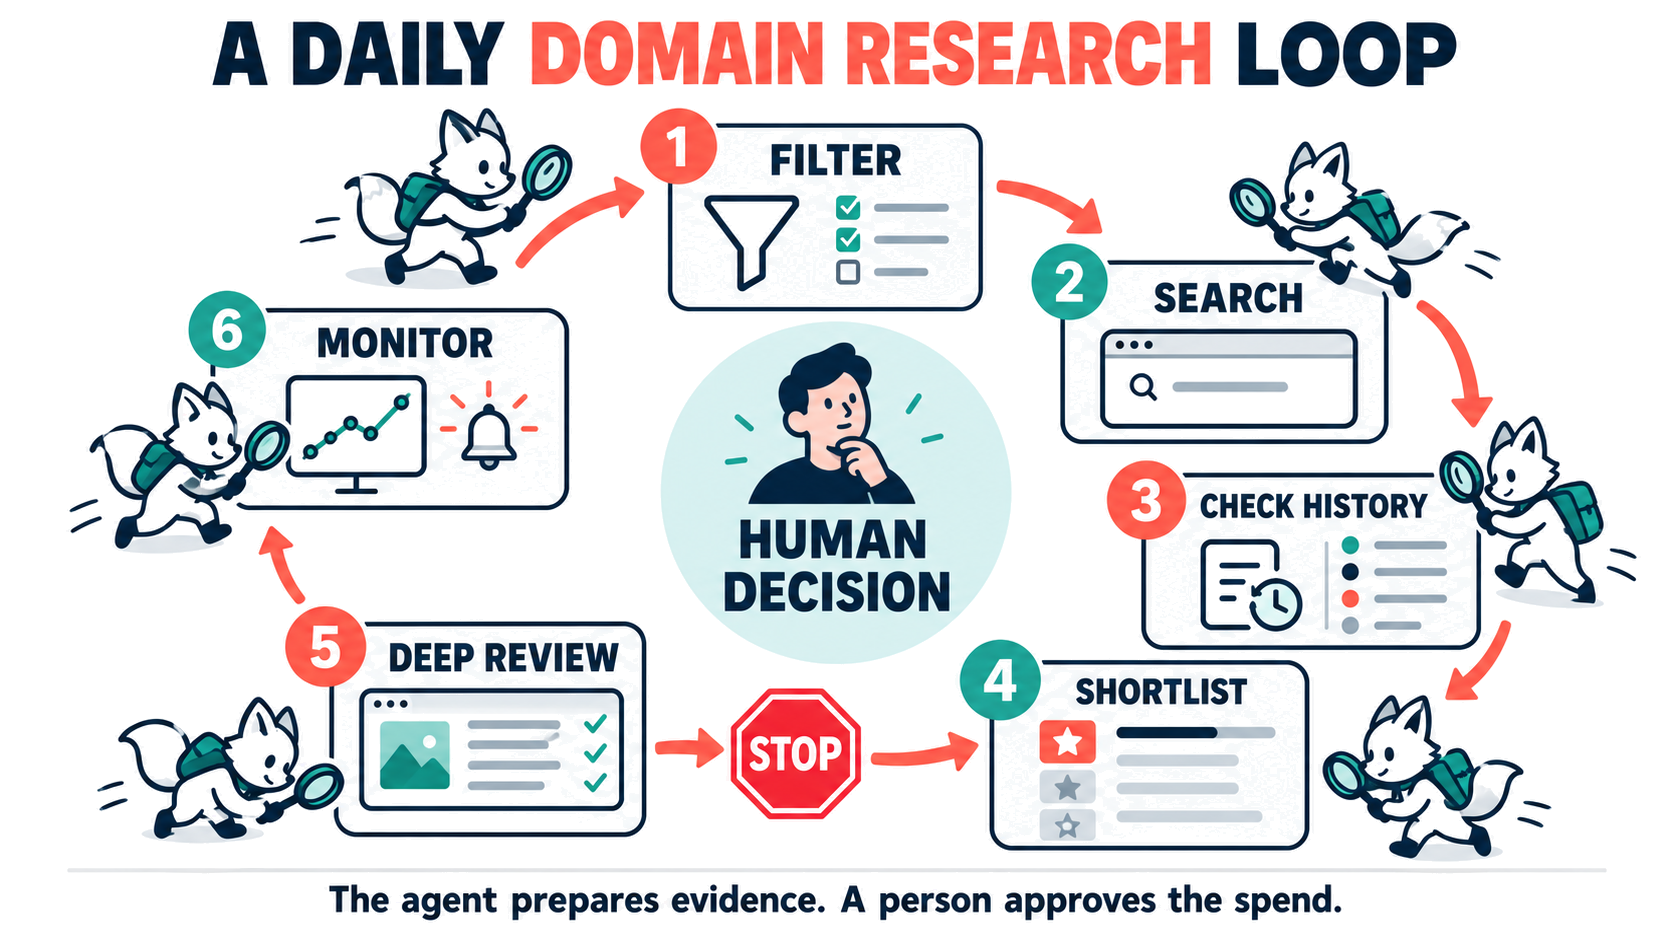
Imaginez une agence SEO qui source des domaines en anglais pour ses clients SaaS B2B. Son brief quotidien pourrait être :
Chaque matin, trouve de nouveaux domaines d’enchères
.comet.iodont le contenu archivé couvrait le logiciel B2B, les outils SaaS ou la technologie business. Garde le prix actuel sous 1 000 $ et au moins 24 heures avant la clôture. Exclus l’adulte, le gambling, la pharma, le piratage et les changements de sujet évidents. Renvoie au plus cinq candidats avec liens de rapport, thème historique, signaux SEO les plus forts, préoccupation principale et état actuel de l’enchère. Ne mise pas et n’achète pas.
Voici ce qui se passe derrière ce prompt.
1. Traduire le brief en critères structurés
L’agent convertit la niche, les TLD, la langue, le prix, le timing et les règles de risque en filtres supportés. Il doit exposer ces choix dans la sortie. Des critères cachés sont difficiles à déboguer.
L’agent peut ensuite enregistrer le filtre sous un nom stable comme b2b-saas-agency-v1 avec save_saved_filter. Si l’équipe change son âge minimum la semaine suivante, l’agent met à jour cette définition sauvegardée au lieu d’inventer une nouvelle recherche à chaque exécution.
2. Chercher dans l’inventaire actuel
L’agent appelle search_reports sur les enregistrements d’enchères et expirés au lieu de chercher sur le web ouvert. Chaque résultat porte un report_id stable et un lien vers le rapport complet, pour que chaque étape ultérieure puisse pointer vers les mêmes preuves.
À ce stade, j’utiliserais des seuils larges. Une exigence stricte sur chaque métrique possible peut retarder ou effacer de bons candidats parce que des champs différents arrivent à des moments différents.
3. Filtrer l’identité précédente du domaine
Pour chaque candidat, l’agent appelle get_domain, qui renvoie le lien du rapport, les métriques et un résumé Wayback, et vérifie les thèmes archivés, les langues, les redirections, le comportement serveur, les changements de contenu et les catégories de risque. Un relecteur ouvre le lien du rapport pour l’historique snapshot par snapshot. C’est là qu’un nom de domaine plausible échoue souvent.
Les métriques SEO restent utiles, mais ne répondent pas à la question d’identité. L’ancien site peut avoir commencé comme blog SaaS ou tech, puis devenir une ferme de coupons ou un site d’affiliation casino. Un score actuel unique compresse cet historique trop agressivement.
4. Traiter les données manquantes délibérément
La plupart des rapports Karma.Domains contiennent déjà des données SEO. Si un rapport shortlisté manque un champ exigé par la décision, l’agent peut lancer SEO Enrich avec enrich_report_seo et interroger get_enrich_report_seo_job jusqu’à la fin du job. Enrich est un chemin d’exception pour les données manquantes, pas un rafraîchissement de routine pour chaque enregistrement.
5. Comparer les survivants et préserver l’état
L’agent tague les rapports survivants avec le projet et l’étape de revue via set_report_annotation, puis ajoute une courte note avec la raison principale d’inspecter ou de rejeter chaque domaine. create_share_link donne à un relecteur senior ou à un client un lien invité vers le même rapport.
Cette étape est facile à sous-estimer. Sans état sauvegardé, le même domaine réapparaît dans l’exécution du lendemain et consomme un autre cycle de revue.
6. Dépenser les données premium sur une liste courte
Ahrefs, Semrush et DataForSEO proposent tous des serveurs MCP SEO, donc le même agent peut tirer des données backlinks et mots-clés plus profondes. Utilisez-les après le filtrage history-first, quand il reste peut-être cinq ou dix domaines. L’agent peut alors inspecter les anchors, la concentration de domaines référents, les liens perdus, l’historique de ranking, la demande ou l’adéquation concurrentielle plus en profondeur.
L’ordre contrôle le coût et l’attention. Tirer des rapports coûteux pour chaque correspondance brute gaspille les deux. Les contrôles live de Karma.Domains suivent la même logique : spam_score_checker, whois_lookup ou check_domain_expiry renvoient une valeur actuelle pour un nom fourni et utilisent des crédits (les hits de cache sont gratuits), donc ils appartiennent aussi à la shortlist.
7. Surveiller les enregistrements qui comptent
Les webhooks Karma.Domains peuvent envoyer du JSON signé à n8n, Zapier, Make, IFTTT ou un autre endpoint HTTPS lorsqu’un rapport commence à correspondre aux conditions de filtre envoyées avec l’abonnement, de sorte que le workflow ne dépende pas d’un filtre sauvegardé dans l’UI. Un second type d’abonnement surveille jusqu’à 100 rapports spécifiques pour le prix, le nombre d’offres, les événements ending-soon et ended. Un compte peut détenir 30 abonnements et recevoir 5 000 livraisons par jour. (Webhooks de domaines expirés)
Un agent peut utiliser ces événements pour mettre à jour la file de revue, écrire une ligne dans une feuille partagée ou préparer un nouveau brief de décision pour Slack, Telegram ou e-mail. Il ne doit pas notifier l’équipe à chaque changement d’un champ de faible valeur. Le budget d’attention appartient au workflow : cinq nouveaux candidats, une alerte ending-soon ou un mouvement de prix matériel.
8. Demander à un humain de décider
Le brief final doit inclure les liens de rapport, les règles appliquées, les données d’enchères actuelles, les preuves qui soutiennent la recommandation, les champs manquants et la préoccupation principale de l’agent. Une entrée candidat peut lister le domaine et le report_id, la source d’enchère, l’heure de fin et le prix actuel, le thème archivé par période, le signal de lien le plus fort, les catégories de risque et les champs encore manquants.
Le relecteur vérifie ensuite l’archive, les backlinks, l’annonce marketplace, le risque de marque, l’adéquation à la catégorie produit du client et le plafond de prix. Un paragraphe confiant de l’agent n’est pas une validation.
MCP, API et webhooks ont des rôles séparés
Karma.Domains expose le même workflow domaine via plusieurs interfaces.
- MCP convient à la recherche interactive. Un analyste peut changer le brief en langage naturel, demander pourquoi un candidat a survécu, et écrire des notes ou tags dans le rapport.
- L’Expired Domains API convient aux scripts déterministes, aux jobs planifiés, aux tableaux de bord internes et aux intégrations CRM.
- Les webhooks conviennent à la surveillance persistante. Ils poussent une nouvelle correspondance ou un changement d’enchère dans l’automatisation au lieu d’attendre un autre cycle de polling.
Un workflow mature utilise souvent les trois. L’API construit ou synchronise la file. MCP aide un analyste à la revoir. Les webhooks réveillent le processus quand quelque chose change.
Les garde-fous rendent l’agent utile
Les workflows agentiques deviennent peu fiables quand les instructions définissent l’objectif mais ignorent les limites d’exploitation. Je documenterais au moins ces contrôles :
- un nombre maximal de résultats et un budget maximal d’appels d’outils par exécution ;
- des champs de preuve obligatoires pour une recommandation ;
- un traitement clair des valeurs nulles, périmées et conflictuelles ;
- une déduplication par ID de rapport stable ;
- des permissions séparées pour la lecture, l’annotation et les actions externes ;
- une règle selon laquelle les offres, achats et exceptions de budget exigent une confirmation ;
- un enregistrement d’audit des critères et outils utilisés.
L’agent a aussi besoin d’un chemin d’échec. Si une source est indisponible, la sortie correcte est « non vérifié » avec les candidats concernés. Il ne doit pas substituer un chiffre plausible.
Comment commencer sans construire un grand système d’agents
Commencez avec une recherche sauvegardée et un format de sortie.
Connectez le serveur MCP Karma.Domains à ChatGPT ou Claude avec une connexion OAuth, ou utilisez une clé Bearer dans Cursor, Claude Code ou un autre client IDE. Votre propre clé API Karma.Domains nécessite Pro, et la même clé fait tourner l’API et les webhooks ; un compte gratuit démarre avec 5 crédits bonus (10 avec une invitation). Demandez à l’assistant de créer le filtre, de l’exécuter et de renvoyer une shortlist de cinq domaines avec liens de rapport et préoccupations. Relisez cette sortie manuellement pendant une semaine.
Une fois les critères stables, déplacez la collecte répétitive vers l’API ou un agent planifié. Ajoutez un webhook seulement quand une personne ou un système est prêt à agir sur l’événement.
Cet ordre garde la recherche inspectable. Les règles vivent dans le filtre sauvegardé et les instructions d’exploitation, pour que n’importe qui dans l’équipe puisse lire pourquoi un domaine a été gardé ou écarté, et qu’une personne prenne encore chaque décision qui peut dépenser de l’argent ou créer un risque SEO.
FAQ
Qu’est-ce que le SEO agentique ?
Le SEO agentique est l’usage d’agents IA qui peuvent appeler des outils, vérifier des résultats et choisir l’étape suivante dans un workflow SEO, avec une personne qui valide les décisions qui comptent. En recherche de domaines, cela signifie que l’agent cherche, filtre et annote des candidats, et qu’un spécialiste décide quoi acheter.
Le SEO agentique est-il la même chose que le GEO ?
Non. Le SEO agentique décrit comment le travail est fait. Le GEO, ou generative engine optimization, concerne la visibilité dans les réponses générées par l’IA. Une équipe peut utiliser des agents pour du travail GEO, mais les deux termes répondent à des questions différentes.
Un agent IA peut-il acheter des domaines expirés tout seul ?
Il ne devrait pas. Le serveur MCP Karma.Domains n’a pas d’outil d’achat ni d’enchère, et un workflow solide garde les offres, achats et exceptions de budget derrière la validation d’une personne nommée.
De quoi un workflow SEO agentique a-t-il besoin pour la recherche de domaines ?
Des données structurées qu’il peut interroger, comme un serveur MCP ou une API de domaines expirés, des critères écrits pour la niche et les risques, un endroit pour garder l’état comme des filtres sauvegardés, des notes et des tags, et une règle pour ce qu’il faut faire quand des données manquent ou sont périmées.