
La mayoría de flujos de «IA para SEO» siguen empezando y acabando en una ventana de chat. Pides una lista de keywords, un outline o un resumen de auditoría. El modelo responde y una persona lleva el resultado a la siguiente herramienta. El SEO agéntico, el uso práctico de agentes de IA para el trabajo de SEO, mueve parte de ese trabajo fuera de la caja de respuesta. El agente puede elegir una herramienta, recuperar datos actuales, aplicar una regla, inspeccionar el resultado y decidir qué paso debe venir después. Ahrefs describe el SEO agéntico como aplicar agentes de IA a flujos de trabajo para que puedan actuar, adaptarse y recuperarse en lugar de solo generar texto. Esa distinción es especialmente útil en la investigación de dominios, donde el trabajo es repetitivo pero la decisión final no lo es. (Ahrefs: What Is Agentic SEO?)
Creo que la investigación de dominios es uno de los lugares más limpios para usar este modelo. La evidencia está estructurada, la secuencia se puede describir y cada acción costosa puede quedarse detrás de la aprobación humana.
Tabla de contenidos
- Tabla de contenidos
- Qué cambia el SEO agéntico: chatbot, automatización y agente
- Por qué la investigación de dominios encaja con un agente
- El stack detrás de la investigación agéntica de dominios
- Un flujo completo de investigación agéntica de dominios
- 1. Traducir el brief a criterios estructurados
- 2. Buscar el inventario actual
- 3. Cribar la identidad previa del dominio
- 4. Tratar los datos faltantes a propósito
- 5. Comparar supervivientes y preservar el estado
- 6. Gastar datos premium en una lista corta
- 7. Monitorizar los registros que importan
- 8. Pedir a un humano que decida
- MCP, API y webhooks tienen roles separados
- Las salvaguardas hacen útil al agente
- Cómo empezar sin construir un gran sistema de agentes
- FAQ
Qué cambia el SEO agéntico: chatbot, automatización y agente
| Enfoque | Qué impulsa el siguiente paso | Buen uso en investigación de dominios | Limitación principal |
|---|---|---|---|
| Chatbot | El siguiente mensaje del usuario | Explicar un informe o ayudar a diseñar filtros | Se detiene cuando se detiene la conversación |
| Automatización fija | Condiciones preescritas | Ejecutar una búsqueda guardada cada mañana y añadir filas a una base de datos | Maneja mal las excepciones |
| Agente de IA | Un objetivo, herramientas, estado y reglas operativas | Buscar, inspeccionar, comparar, anotar, monitorizar y preparar una shortlist | Necesita contratos de datos sólidos y límites claros de autoridad |
Un agente gana su lugar cuando puede operar sobre el sistema de investigación: llamar a la herramienta de búsqueda, abrir informes, guardar estado y devolver evidencia que otra persona pueda verificar. Ahrefs hace el mismo punto en su guía de SEO agéntico: un agente no razona mejor que el modelo en una ventana de chat, así que la ganancia viene de las herramientas, el contexto y la capacidad de recuperarse de un paso fallido.
El SEO agéntico también se confunde fácilmente con GEO. El SEO agéntico concierne a cómo se realiza el trabajo; GEO concierne a la visibilidad en experiencias de búsqueda generadas por IA. Los términos se solapan en la conversación, pero describen problemas distintos.
Por qué la investigación de dominios encaja con un agente
La investigación de dominios expirados tiene cuatro propiedades que los agentes manejan bien.
Primero, el pool de candidatos cambia constantemente. Llegan dominios nuevos, se mueven los precios de subasta, cambian las pujas y terminan los listados. El proceso se beneficia de ejecuciones programadas o impulsadas por eventos.
Segundo, el primer pase de cribado es basado en reglas. Un equipo puede especificar TLDs, idiomas, temas, techos de precio, edad mínima, señales de autoridad, temas prohibidos, fuentes de subasta y tiempo antes del cierre.
Tercero, la evidencia viene de varias capas. Un dominio puede verse fuerte por Domain Rating y aun así tener una historia no relacionada o tóxica. Otro puede tener un archivo limpio y un nombre comercial, pero demasiado poco valor de enlaces para el proyecto previsto.
Por último, el proceso tiene un punto de traspaso obvio. Un agente puede reducir miles de registros a cinco candidatos. Una persona sigue decidiendo si alguno de esos cinco debería comprarse.
El stack detrás de la investigación agéntica de dominios
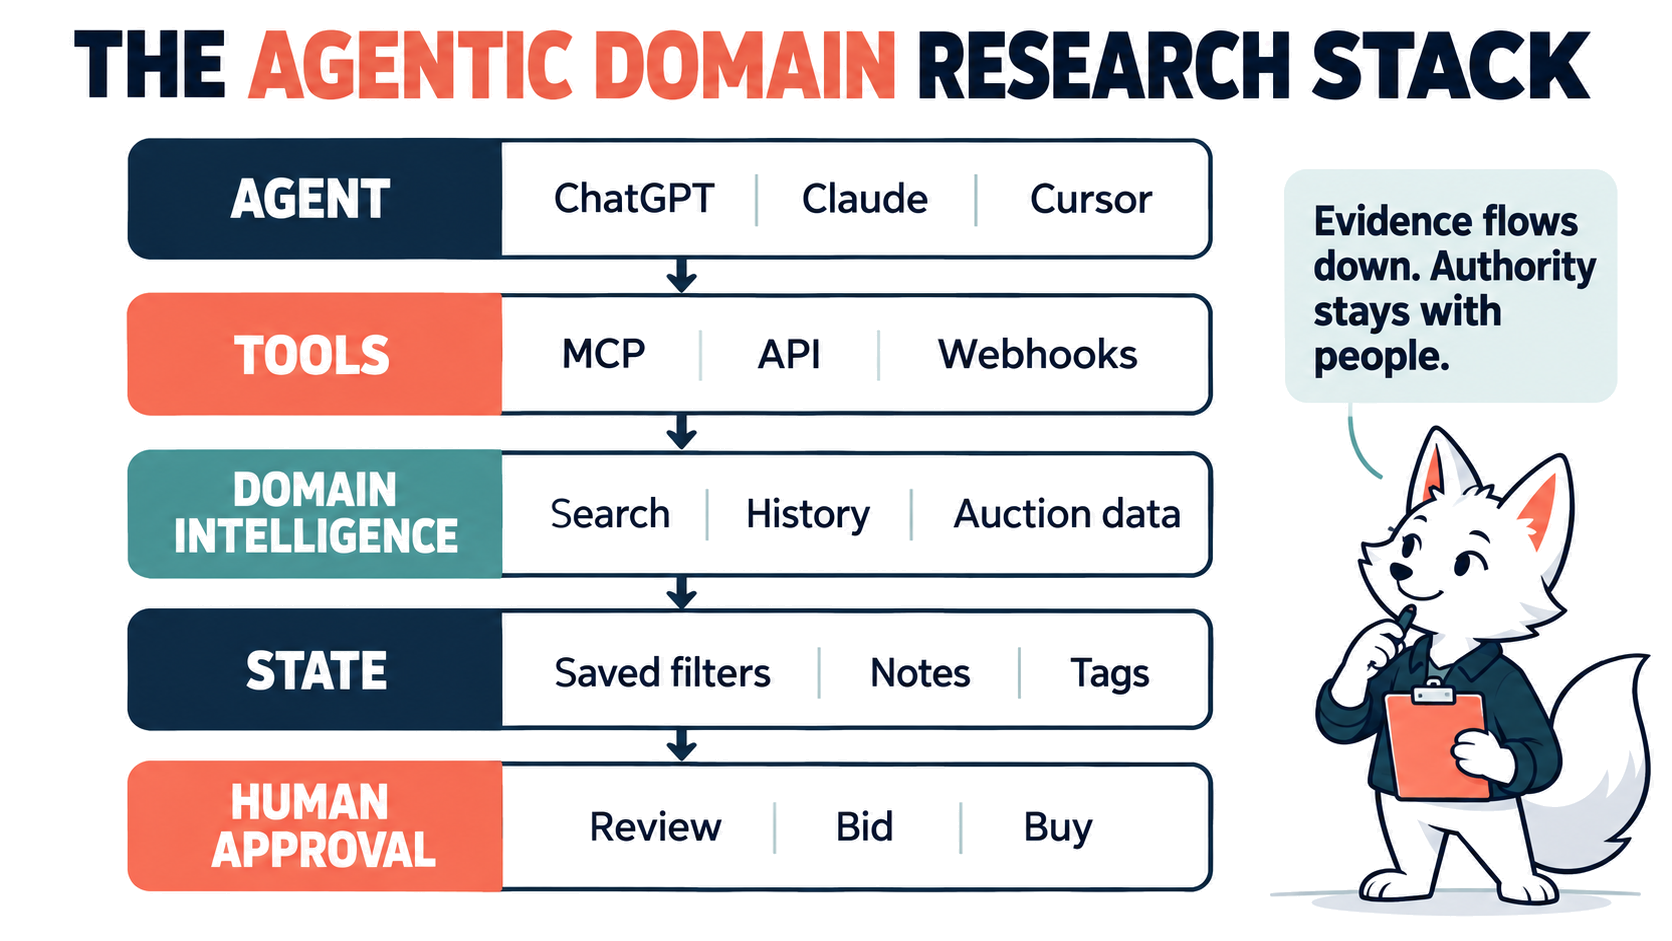
Un stack práctico tiene cinco partes.
- Un entorno de agente. Puede ser ChatGPT, Claude, Cursor, una plataforma de orquestación o un agente alojado que pueda ejecutarse con horario.
- Herramientas de datos profesionales. Los servidores MCP (Model Context Protocol) y las APIs conectan al agente con datos actuales de dominios, backlinks, tráfico, subastas y búsqueda.
- Instrucciones operativas reutilizables. Un skill o flujo define los criterios del equipo, el formato de salida, las reglas de presupuesto y las condiciones de escalado. La guía de Search Engine Land sobre skills de agentes SEO hace el mismo caso: dale al agente herramientas, plantillas y un revisor en lugar de un prompt más largo. (Search Engine Land: How to build SEO agent skills that actually work)
- Estado. Filtros guardados, IDs de informe, notas, etiquetas y una cola de revisión externa impiden que el agente empiece de cero cada día.
- Aprobación humana. Una persona nombrada posee la puja, la compra, la revisión de marca y cualquier excepción a las reglas.
Karma.Domains ocupa la capa de inteligencia de dominios en este stack. No es un agente universal de SEO con IA para contenido, correcciones técnicas o publicación. El producto da a los agentes acceso a la parte que necesitan para la adquisición de dominios: descubrimiento, cribado histórico, datos actuales de subasta y un flujo de revisión.
La base de datos contiene 13M+ dominios de 40 fuentes de subasta y añade de media más de 400.000 dominios nuevos al día. La búsqueda tiene 90+ filtros en inventario de subasta, expirados, backorder y buy-now, y el servidor MCP expone 31 herramientas para búsqueda, informes completos, filtros guardados, notas y etiquetas, enlaces para compartir, SEO Enrich y comprobaciones en vivo. Los informes combinan análisis de historia basado en Wayback con datos disponibles de Ahrefs, Majestic, Moz, Semrush, Similarweb y otras fuentes. (Karma.Domains)
El tamaño importa porque un agente no puede recuperar candidatos que nunca entran en sus herramientas. Los filtros importan porque «encuentra buenos dominios» no es una regla operativa.
Un flujo completo de investigación agéntica de dominios
Imagina una agencia SEO que busca dominios en inglés para sus clientes de SaaS B2B. Su brief diario podría ser:
Cada mañana, encuentra nuevos dominios de subasta
.comy.iocuyo contenido archivado cubriera software B2B, herramientas SaaS o tecnología empresarial. Mantén el precio actual por debajo de $1.000 y al menos 24 horas antes del cierre. Excluye adult, gambling, pharma, piratería y cambios obvios de tema. Devuelve no más de cinco candidatos con enlaces al informe, el tema histórico, las señales SEO más fuertes, la preocupación principal y el estado actual de la subasta. No pujes ni compres.
Esto es lo que ocurre detrás de ese prompt.
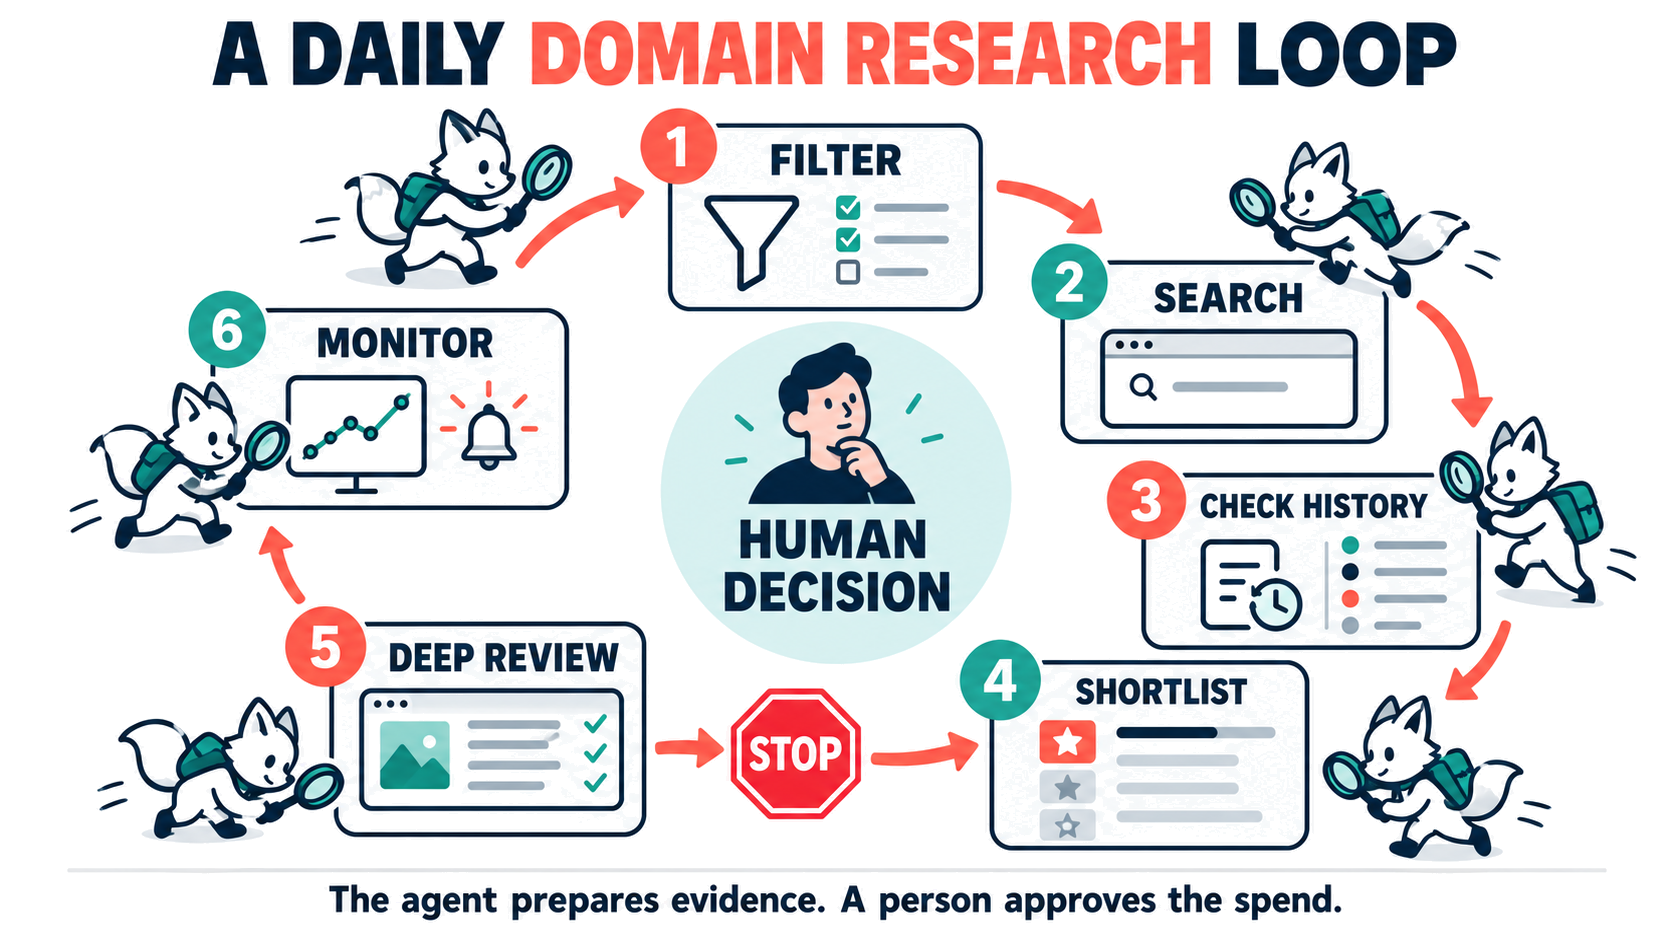
1. Traducir el brief a criterios estructurados
El agente convierte el nicho, TLDs, idioma, precio, timing y reglas de riesgo en filtros soportados. Debe exponer esas elecciones en la salida. Los criterios ocultos son difíciles de depurar.
El agente puede entonces guardar el filtro con un nombre estable como b2b-saas-agency-v1 con save_saved_filter. Si el equipo cambia su edad mínima la semana siguiente, el agente actualiza esa definición guardada en lugar de inventar una búsqueda nueva en cada ejecución.
2. Buscar el inventario actual
El agente llama a search_reports sobre registros de subasta y expirados en lugar de buscar en la web abierta. Cada resultado lleva un report_id estable y un enlace al informe completo, de modo que cada paso posterior pueda apuntar a la misma evidencia.
En esta etapa yo usaría umbrales amplios. Una exigencia estricta de cada métrica posible puede retrasar o borrar buenos candidatos porque distintos campos llegan en momentos distintos.
3. Cribar la identidad previa del dominio
Para cada candidato, el agente llama a get_domain, que devuelve el enlace al informe, métricas y un resumen de Wayback, y comprueba temas archivados, idiomas, redirecciones, comportamiento del servidor, cambios de contenido y categorías de riesgo. Un revisor abre el enlace del informe para la historia snapshot a snapshot. Aquí es donde un nombre de dominio plausible suele fallar.
Las métricas SEO siguen siendo útiles, pero no responden a la pregunta de identidad. El sitio antiguo puede haber empezado como un blog SaaS o tech y luego convertirse en una granja de cupones o un sitio de afiliados de casino. Una sola puntuación actual comprime esa historia con demasiada agresividad.
4. Tratar los datos faltantes a propósito
La mayoría de los informes de Karma.Domains ya contienen datos SEO. Si a un informe de la shortlist le falta un campo que la decisión requiere, el agente puede iniciar SEO Enrich con enrich_report_seo y consultar get_enrich_report_seo_job hasta que el trabajo termine. Enrich es una ruta de excepción para datos faltantes, no un refresco rutinario de cada registro.
5. Comparar supervivientes y preservar el estado
El agente etiqueta los informes supervivientes con el proyecto y la etapa de revisión mediante set_report_annotation, y luego añade una nota breve con la razón principal para inspeccionar o rechazar cada dominio. create_share_link da a un revisor senior o a un cliente un enlace de invitado al mismo informe.
Este paso es fácil de subestimar. Sin estado guardado, el mismo dominio reaparece en la ejecución de mañana y consume otro ciclo de revisión.
6. Gastar datos premium en una lista corta
Ahrefs, Semrush y DataForSEO ofrecen servidores MCP de SEO, así que el mismo agente puede obtener datos más profundos de backlinks y keywords. Úsalos después del cribado history-first, cuando queden quizá cinco o diez dominios. El agente puede entonces inspeccionar anchors, concentración de dominios referentes, enlaces perdidos, historial de rankings, demanda o encaje con competidores con más profundidad.
El orden controla el coste y la atención. Tirar de informes caros para cada coincidencia en bruto desperdicia ambos. Las comprobaciones en vivo de Karma.Domains siguen la misma lógica: spam_score_checker, whois_lookup o check_domain_expiry devuelven un valor actual para un nombre suministrado y usan créditos (los aciertos de caché son gratis), así que también pertenecen a la shortlist.
7. Monitorizar los registros que importan
Los webhooks de Karma.Domains pueden enviar JSON firmado a n8n, Zapier, Make, IFTTT u otro endpoint HTTPS cuando un informe empieza a cumplir las condiciones de filtro enviadas con la suscripción, de modo que el flujo no dependa de un filtro que alguien guardó en la UI. Un segundo tipo de suscripción vigila hasta 100 informes concretos por precio, número de pujas, eventos ending-soon y ended. Una cuenta puede tener 30 suscripciones y recibir 5.000 entregas al día. (Webhooks de dominios expirados)
Un agente puede usar esos eventos para actualizar la cola de revisión, escribir una fila en una hoja compartida o preparar un nuevo brief de decisión para Slack, Telegram o email. No debería notificar al equipo cada vez que cambie un campo de bajo valor. El presupuesto de atención pertenece al flujo: cinco candidatos nuevos, una alerta ending-soon o un movimiento material de precio.
8. Pedir a un humano que decida
El brief final debe incluir los enlaces a los informes, las reglas aplicadas, los datos actuales de subasta, la evidencia que respalda la recomendación, los campos faltantes y la preocupación principal del agente. Una entrada de candidato podría listar el dominio y report_id, la fuente de subasta, la hora de fin y el precio actual, el tema archivado por periodo, la señal de enlace más fuerte, cualquier categoría de riesgo y los campos que aún faltan.
El revisor comprueba entonces el archivo, los backlinks, el listado del marketplace, el riesgo de marca, el encaje con la categoría de producto del cliente y el techo de precio. Un párrafo confiado del agente no es una aprobación.
MCP, API y webhooks tienen roles separados
Karma.Domains expone el mismo flujo de dominios a través de varias interfaces.
- MCP encaja con la investigación interactiva. Un analista puede cambiar el brief en lenguaje natural, preguntar por qué sobrevivió un candidato y escribir notas o etiquetas de vuelta al informe.
- La Expired Domains API encaja con scripts deterministas, trabajos programados, dashboards internos e integraciones CRM.
- Los webhooks encajan con la monitorización persistente. Empujan una nueva coincidencia o un cambio de subasta a la automatización en lugar de esperar otro ciclo de polling.
Un flujo maduro suele usar los tres. La API construye o sincroniza la cola. MCP ayuda a un analista a revisarla. Los webhooks despiertan el proceso cuando algo cambia.
Las salvaguardas hacen útil al agente
Los flujos agénticos se vuelven poco fiables cuando las instrucciones definen el objetivo pero ignoran los límites operativos. Yo documentaría al menos estos controles:
- un recuento máximo de resultados y un presupuesto máximo de llamadas a herramientas por ejecución;
- campos de evidencia obligatorios para una recomendación;
- tratamiento claro de valores nulos, obsoletos y conflictivos;
- deduplicación por ID de informe estable;
- permisos separados para lectura, anotación y acciones externas;
- una regla de que pujas, compras y excepciones de presupuesto requieren confirmación;
- un registro de auditoría de los criterios y herramientas usados.
El agente también necesita una ruta de fallo. Si una fuente no está disponible, la salida correcta es «no verificado» con los candidatos afectados. No debería sustituir un número plausible.
Cómo empezar sin construir un gran sistema de agentes
Empieza con una búsqueda guardada y un formato de salida.
Conecta el servidor MCP de Karma.Domains a ChatGPT o Claude con un inicio de sesión OAuth, o usa una clave Bearer en Cursor, Claude Code u otro cliente IDE. Tu propia clave API de Karma.Domains requiere Pro, y la misma clave ejecuta la API y los webhooks; una cuenta gratuita empieza con 5 créditos de bonificación (10 con invitación). Pide al asistente que cree el filtro, lo ejecute y devuelva una shortlist de cinco dominios con enlaces a informes y preocupaciones. Revisa esa salida manualmente durante una semana.
Cuando los criterios sean estables, mueve la recolección repetitiva a la API o a un agente programado. Añade un webhook solo cuando haya una persona o un sistema listo para actuar sobre el evento.
Ese orden mantiene la investigación inspeccionable. Las reglas viven en el filtro guardado y en las instrucciones operativas, de modo que cualquiera del equipo pueda leer por qué se mantuvo o descartó un dominio, y una persona sigue tomando cada decisión que puede gastar dinero o crear riesgo SEO.
FAQ
¿Qué es el SEO agéntico?
El SEO agéntico es el uso de agentes de IA que pueden llamar a herramientas, comprobar resultados y elegir el siguiente paso en un flujo de SEO, con una persona que aprueba las decisiones que importan. En la investigación de dominios eso significa que el agente busca, criba y anota candidatos, y un especialista decide qué comprar.
¿El SEO agéntico es lo mismo que GEO?
No. El SEO agéntico describe cómo se hace el trabajo. GEO, u optimización para motores generativos, trata de la visibilidad dentro de respuestas generadas por IA. Un equipo puede usar agentes para trabajo de GEO, pero los dos términos responden a preguntas distintas.
¿Puede un agente de IA comprar dominios expirados por su cuenta?
No debería. El servidor MCP de Karma.Domains no tiene herramienta de compra ni de puja, y un flujo sólido mantiene pujas, compras y excepciones de presupuesto detrás de la aprobación de una persona nombrada.
¿Qué necesita un flujo de SEO agéntico para la investigación de dominios?
Datos estructurados que pueda consultar, como un servidor MCP o una API de dominios expirados, criterios escritos para el nicho y los riesgos, un lugar para guardar estado como filtros guardados, notas y etiquetas, y una regla para qué hacer cuando faltan datos o están obsoletos.