
De meeste “AI voor SEO”-workflows beginnen en eindigen nog in een chatvenster. Je vraagt om een keywordlijst, een outline of een auditsamenvatting. Het model antwoordt, en een persoon brengt het resultaat naar de volgende tool. Agentic SEO, het praktische gebruik van AI-agents voor SEO-werk, verplaatst een deel van dat werk buiten het antwoordvak. De agent kan een tool kiezen, actuele data ophalen, een regel toepassen, het resultaat inspecteren en beslissen welke stap daarna moet komen. Ahrefs beschrijft agentic SEO als het toepassen van AI-agents op workflows zodat ze kunnen handelen, zich aanpassen en herstellen in plaats van alleen tekst te genereren. Dat onderscheid is vooral nuttig in domain research, waar het werk repetitief is maar de uiteindelijke beslissing niet. (Ahrefs: What Is Agentic SEO?)
Ik vind domain research een van de schonere plekken om dit model te gebruiken. Het bewijs is gestructureerd, de volgorde kan worden beschreven, en elke dure actie kan achter menselijke goedkeuring blijven.
Inhoudsopgave
- Inhoudsopgave
- Wat agentic SEO verandert: chatbot, automatisering en agent
- Waarom domain research bij een agent past
- De stack achter agentische domain research
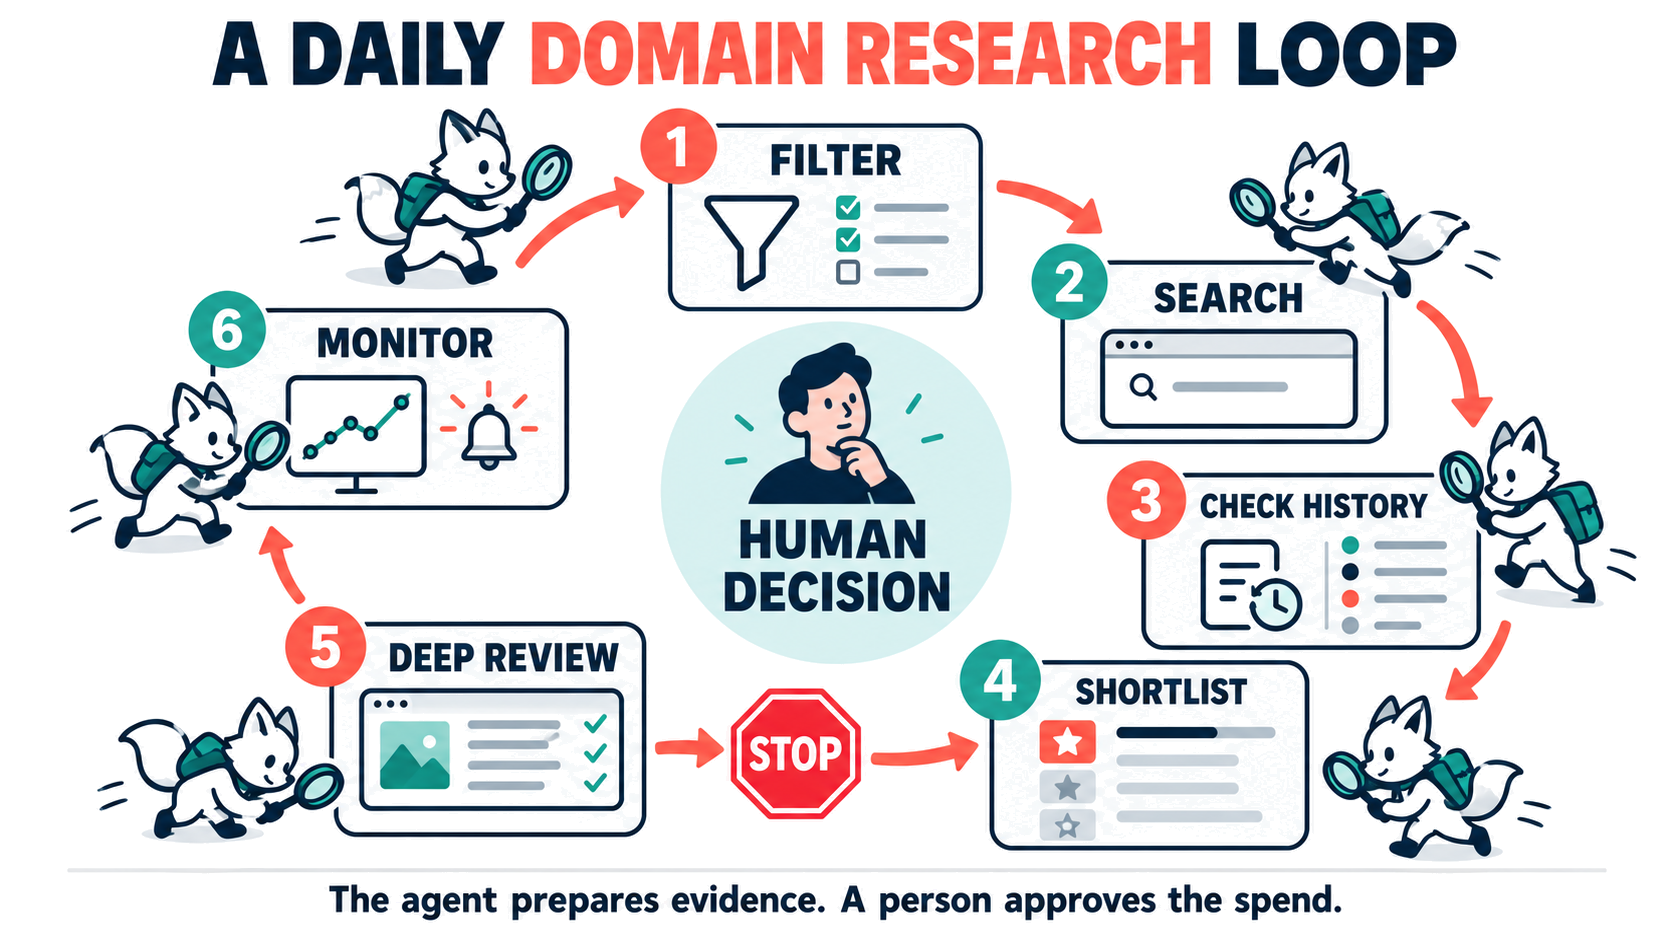
- Een complete agentische domain-research-workflow
- 1. Vertaal de brief naar gestructureerde criteria
- 2. Doorzoek de huidige inventaris
- 3. Screen de vorige identiteit van het domein
- 4. Behandel ontbrekende data bewust
- 5. Vergelijk overlevers en bewaar state
- 6. Besteed premiumdata aan een korte lijst
- 7. Monitor de records die ertoe doen
- 8. Vraag een mens te beslissen
- MCP, API en webhooks hebben aparte rollen
- Guardrails maken de agent nuttig
- Zo begin je zonder een groot agentsysteem te bouwen
- FAQ
Wat agentic SEO verandert: chatbot, automatisering en agent
| Aanpak | Wat de volgende stap stuurt | Goed gebruik in domain research | Belangrijkste beperking |
|---|---|---|---|
| Chatbot | Het volgende bericht van de gebruiker | Een rapport uitleggen of helpen filters te ontwerpen | Hij stopt wanneer het gesprek stopt |
| Vaste automatisering | Vooraf geschreven voorwaarden | Elke ochtend een opgeslagen zoekopdracht trekken en rijen aan een database toevoegen | Uitzonderingen behandelt hij slecht |
| AI-agent | Een doel, tools, state en operationele regels | Zoeken, inspecteren, vergelijken, annoteren, monitoren en een shortlist voorbereiden | Hij heeft sterke datacontracten en duidelijke autoriteitsgrenzen nodig |
Een agent verdient zijn plaats wanneer hij op het researchsysteem kan werken: de zoektool aanroepen, rapporten openen, state opslaan en bewijs teruggeven dat een andere persoon kan verifiëren. Ahrefs maakt hetzelfde punt in zijn agentic-SEO-gids: een agent redeneert niet beter dan het model in een chatvenster, dus de winst komt uit tools, context en het vermogen om te herstellen van een mislukte stap.
Agentic SEO is ook makkelijk te verwarren met GEO. Agentic SEO betreft hoe werk wordt uitgevoerd; GEO betreft zichtbaarheid in door AI gegenereerde zoekervaringen. De termen overlappen in gesprekken, maar beschrijven verschillende problemen.
Waarom domain research bij een agent past
Expired-domain research heeft vier eigenschappen die agents goed aankunnen.
Ten eerste verandert de kandidatenpool voortdurend. Nieuwe domeinen komen binnen, veilingprijzen bewegen, biedingen veranderen en listings eindigen. Het proces heeft baat bij geplande of event-driven runs.
Ten tweede is de eerste screeningregel gebaseerd. Een team kan TLD’s, talen, topics, prijsplafonds, minimumleeftijd, authority-signalen, verboden onderwerpen, veilingsbronnen en tijd tot sluiting specificeren.
Ten derde komt bewijs uit meerdere lagen. Een domein kan sterk lijken op Domain Rating en toch een irrelevante of toxische geschiedenis hebben. Een ander kan een schoon archief en een commerciële naam hebben, maar te weinig linkwaarde voor het beoogde project.
Tot slot heeft het proces een duidelijk overdrachtspunt. Een agent kan duizenden records terugbrengen tot vijf kandidaten. Een persoon beslist nog steeds of een van die vijf gekocht moet worden.
De stack achter agentische domain research
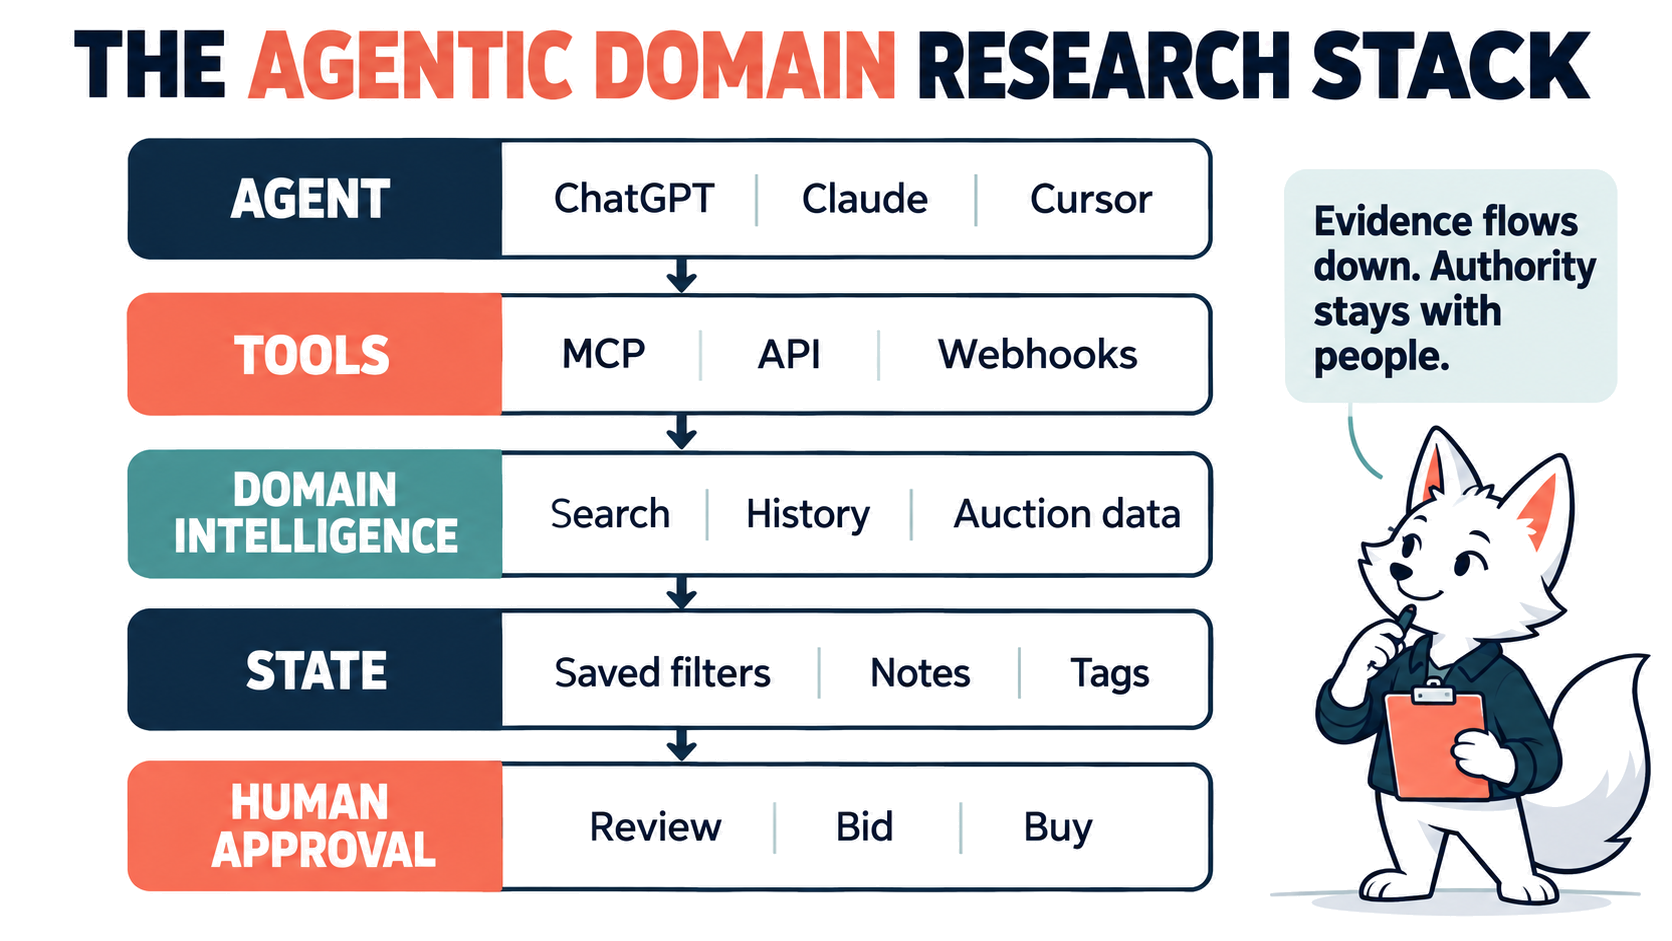
Een praktische stack heeft vijf delen.
- Een agentomgeving. Dit kan ChatGPT, Claude, Cursor, een orchestratieplatform of een gehoste agent zijn die op schema kan draaien.
- Professionele datatools. MCP-servers (Model Context Protocol) en API’s verbinden de agent met actuele domein-, backlink-, traffic-, veiling- en zoekdata.
- Herbruikbare operationele instructies. Een skill of workflow definieert de criteria van het team, het outputformaat, budgetregels en escalatievoorwaarden. De gids van Search Engine Land over SEO-agent-skills maakt hetzelfde punt: geef de agent tools, templates en een reviewer in plaats van een langere prompt. (Search Engine Land: How to build SEO agent skills that actually work)
- State. Opgeslagen filters, report-ID’s, notities, tags en een externe reviewwachtrij voorkomen dat de agent elke dag opnieuw begint.
- Menselijke goedkeuring. Een benoemde persoon bezit het bod, de aankoop, de merkreview en elke uitzondering op de regels.
Karma.Domains bezet de domain-intelligence-laag in deze stack. Het is geen universele AI-SEO-agent voor content, technische fixes of publicatie. Het product geeft agents toegang tot het deel dat ze nodig hebben voor domeinacquisitie: discovery, historische screening, actuele veilingdata en een reviewworkflow.
De database bevat 13M+ domeinen uit 40 veilingsbronnen en voegt gemiddeld meer dan 400.000 nieuwe domeinen per dag toe. Zoeken heeft 90+ filters over veiling-, expired-, backorder- en buy-now-inventaris, en de MCP-server stelt 31 tools beschikbaar voor zoeken, volledige rapporten, opgeslagen filters, notities en tags, share-links, SEO Enrich en live checks. Rapporten combineren Wayback-gebaseerde geschiedenisanalyse met beschikbare data van Ahrefs, Majestic, Moz, Semrush, Similarweb en andere bronnen. (Karma.Domains)
De omvang doet ertoe omdat een agent kandidaten niet kan terughalen die nooit in zijn tools binnenkomen. De filters doen ertoe omdat “vind goede domeinen” geen operationele regel is.
Een complete agentische domain-research-workflow
Stel je een SEO-bureau voor dat Engelstalige domeinen zoekt voor B2B-SaaS-klanten. Hun dagelijkse brief zou kunnen zijn:
Zoek elke ochtend nieuwe
.com- en.io-veilingsdomeinen waarvan de gearchiveerde content B2B-software, SaaS-tools of business technology dekte. Houd de huidige prijs onder $1.000 en minstens 24 uur voor sluiting. Sluit adult, gambling, pharma, piraterij en duidelijke topicwijzigingen uit. Geef maximaal vijf kandidaten terug met rapportlinks, het historische topic, de sterkste SEO-signalen, de belangrijkste zorg en de huidige veilingstatus. Bied niet en koop niet.
Dit gebeurt achter die prompt.
1. Vertaal de brief naar gestructureerde criteria
De agent zet niche, TLD’s, taal, prijs, timing en risicoregels om in ondersteunde filters. Hij moet die keuzes in de output tonen. Verborgen criteria zijn moeilijk te debuggen.
De agent kan het filter daarna opslaan onder een stabiele naam zoals b2b-saas-agency-v1 met save_saved_filter. Als het team volgende week de minimumleeftijd wijzigt, werkt de agent die opgeslagen definitie bij in plaats van bij elke run een nieuwe zoekopdracht te verzinnen.
2. Doorzoek de huidige inventaris
De agent roept search_reports aan over veiling- en expired-records in plaats van het open web te doorzoeken. Elk resultaat draagt een stabiele report_id en een link naar het volledige rapport, zodat elke latere stap naar hetzelfde bewijs kan wijzen.
In deze fase zou ik brede drempels gebruiken. Een strikte eis voor elke mogelijke metric kan goede kandidaten vertragen of wissen omdat verschillende velden op verschillende momenten binnenkomen.
3. Screen de vorige identiteit van het domein
Voor elke kandidaat roept de agent get_domain aan, dat de rapportlink, metrics en een Wayback-samenvatting teruggeeft, en controleert gearchiveerde topics, talen, redirects, servergedrag, contentwijzigingen en risicocategorieën. Een reviewer opent de rapportlink voor de snapshot-voor-snapshot-geschiedenis. Hier faalt een aannemelijke domeinnaam vaak.
SEO-metrics blijven nuttig, maar beantwoorden de identiteitsvraag niet. De oude site kan als SaaS- of techblog begonnen zijn en daarna een couponfarm of casino-affiliatesite zijn geworden. Eén huidige score comprimeert die geschiedenis te agressief.
4. Behandel ontbrekende data bewust
De meeste Karma.Domains-rapporten bevatten al SEO-data. Als een shortlist-rapport een veld mist dat de beslissing nodig heeft, kan de agent SEO Enrich starten met enrich_report_seo en get_enrich_report_seo_job pollen tot de job klaar is. Enrich is een uitzonderingspad voor ontbrekende data, geen routine-refresh voor elk record.
5. Vergelijk overlevers en bewaar state
De agent tagt de overlevende rapporten met project en reviewfase via set_report_annotation, en voegt daarna een korte notitie toe met de belangrijkste reden om elk domein te inspecteren of af te wijzen. create_share_link geeft een senior reviewer of klant een gastlink naar hetzelfde rapport.
Deze stap is makkelijk te onderschatten. Zonder opgeslagen state verschijnt hetzelfde domein morgen opnieuw en verbruikt een nieuwe reviewcyclus.
6. Besteed premiumdata aan een korte lijst
Ahrefs, Semrush en DataForSEO bieden allemaal SEO-MCP-servers, zodat dezelfde agent diepere backlink- en keyworddata kan trekken. Gebruik ze na de history-first screening, wanneer er misschien vijf of tien domeinen overblijven. De agent kan dan anchors, referring-domain-concentratie, verloren links, rankinggeschiedenis, vraag of concurrentiefit dieper inspecteren.
De volgorde stuurt kosten en aandacht. Dure rapporten voor elke ruwe match trekken verspilt beide. Live checks van Karma.Domains volgen dezelfde logica: spam_score_checker, whois_lookup of check_domain_expiry geven een actuele waarde voor één aangeleverde naam en gebruiken credits (cache hits zijn gratis), dus horen ze ook op de shortlist.
7. Monitor de records die ertoe doen
Karma.Domains-webhooks kunnen ondertekende JSON naar n8n, Zapier, Make, IFTTT of een ander HTTPS-endpoint sturen wanneer een rapport begint te matchen met de filtervoorwaarden die bij het abonnement zijn gestuurd, zodat de workflow niet afhangt van een filter die iemand in de UI heeft opgeslagen. Een tweede abonnementstype bewaakt tot 100 specifieke rapporten op prijs, biedenaantal, ending-soon- en ended-events. Een account kan 30 abonnementen houden en 5.000 deliveries per dag ontvangen. (Expired-domain-webhooks)
Een agent kan die events gebruiken om de reviewwachtrij bij te werken, een rij in een gedeelde sheet te schrijven of een nieuwe beslissingsbrief voor Slack, Telegram of e-mail voor te bereiden. Hij moet het team niet waarschuwen bij elke wijziging van een laagwaardig veld. Het aandachtbudget hoort in de workflow: vijf nieuwe kandidaten, één ending-soon-alert of een materiële prijsbeweging.
8. Vraag een mens te beslissen
De eindbrief moet de rapportlinks, de toegepaste regels, actuele veilingdata, bewijs voor de aanbeveling, ontbrekende velden en de belangrijkste zorg van de agent bevatten. Een kandidaatinvoer kan het domein en report_id, de veilingsbron, eindtijd en huidige prijs, het gearchiveerde topic per periode, het sterkste linksignaal, risicocategorieën en nog ontbrekende velden opsommen.
De reviewer controleert daarna het archief, backlinks, marketplace-listing, merkenrisico, fit bij de productcategorie van de klant en het prijsplafond. Een zelfverzekerde alinea van de agent is geen goedkeuring.
MCP, API en webhooks hebben aparte rollen
Karma.Domains stelt dezelfde domeinworkflow beschikbaar via meerdere interfaces.
- MCP past bij interactieve research. Een analist kan de brief in alledaags taalgebruik wijzigen, vragen waarom een kandidaat overleefde, en notities of tags terug naar het rapport schrijven.
- De Expired Domains API past bij deterministische scripts, geplande jobs, interne dashboards en CRM-integraties.
- Webhooks passen bij persistente monitoring. Ze duwen een nieuwe match of veilingswijziging de automatisering in in plaats van te wachten op een nieuwe pollingcyclus.
Een volwassen workflow gebruikt vaak alle drie. De API bouwt of synchroniseert de wachtrij. MCP helpt een analist die te reviewen. Webhooks wekken het proces wanneer iets verandert.
Guardrails maken de agent nuttig
Agentische workflows worden onbetrouwbaar wanneer instructies het doel definiëren maar operationele grenzen negeren. Ik zou minstens deze controles documenteren:
- een maximumaantal resultaten en een maximum tool-call-budget per run;
- verplichte bewijsvelden voor een aanbeveling;
- duidelijke behandeling van null-, verouderde en tegenstrijdige waarden;
- deduplicatie op stabiele report-ID;
- aparte rechten voor lezen, annotatie en externe acties;
- een regel dat biedingen, aankopen en budgetuitzonderingen bevestiging vereisen;
- een auditrecord van de gebruikte criteria en tools.
De agent heeft ook een failure path nodig. Als een bron niet beschikbaar is, is de juiste output “niet geverifieerd” met de getroffen kandidaten. Hij mag geen aannemelijk getal invullen.
Zo begin je zonder een groot agentsysteem te bouwen
Begin met één opgeslagen zoekopdracht en één outputformaat.
Verbind de Karma.Domains MCP-server met ChatGPT of Claude via een OAuth-aanmelding, of gebruik een Bearer-key in Cursor, Claude Code of een andere IDE-client. Je eigen Karma.Domains API-sleutel vereist Pro, en dezelfde sleutel draait de API en webhooks; een gratis account start met 5 bonuscredits (10 met een uitnodiging). Vraag de assistent het filter te maken, het uit te voeren en een shortlist van vijf domeinen met rapportlinks en zorgen terug te geven. Review die output een week handmatig.
Zodra de criteria stabiel zijn, verplaats de repetitieve collectie naar de API of een geplande agent. Voeg een webhook pas toe wanneer er een persoon of systeem klaarstaat om op het event te reageren.
Die volgorde houdt de research inspecteerbaar. De regels leven in het opgeslagen filter en de operationele instructies, zodat iedereen in het team kan lezen waarom een domein is gehouden of afgevallen, en een persoon nog steeds elke beslissing neemt die geld kan kosten of SEO-risico kan scheppen.
FAQ
Wat is agentic SEO?
Agentic SEO is het gebruik van AI-agents die tools kunnen aanroepen, resultaten kunnen controleren en de volgende stap in een SEO-workflow kunnen kiezen, waarbij een persoon de beslissingen goedkeurt die ertoe doen. In domain research betekent dat: de agent zoekt, screent en annoteert kandidaten, en een specialist beslist wat er gekocht wordt.
Is agentic SEO hetzelfde als GEO?
Nee. Agentic SEO beschrijft hoe het werk wordt gedaan. GEO, of generative engine optimization, gaat over zichtbaarheid in door AI gegenereerde antwoorden. Een team kan agents gebruiken voor GEO-werk, maar de twee termen beantwoorden verschillende vragen.
Kan een AI-agent zelf expired domains kopen?
Dat zou hij niet moeten doen. De Karma.Domains MCP-server heeft geen koop- of biedtool, en een gezonde workflow houdt biedingen, aankopen en budgetuitzonderingen achter de goedkeuring van een benoemde persoon.
Wat heeft een agentische SEO-workflow nodig voor domain research?
Gestructureerde data die hij kan bevragen, zoals een expired-domain MCP-server of API, geschreven criteria voor niche en risico’s, een plek om state te bewaren zoals opgeslagen filters, notities en tags, en een regel voor wat te doen wanneer data ontbreekt of verouderd is.