
A maioria dos fluxos de “IA para SEO” ainda começa e termina numa janela de chat. Você pede uma lista de keywords, um outline ou um resumo de auditoria. O modelo responde, e uma pessoa leva o resultado para a próxima ferramenta. O SEO agêntico, o uso prático de agentes de IA no trabalho de SEO, move parte desse trabalho para fora da caixa de resposta. O agente pode escolher uma ferramenta, recuperar dados atuais, aplicar uma regra, inspecionar o resultado e decidir qual passo deve vir a seguir. A Ahrefs descreve o SEO agêntico como aplicar agentes de IA a fluxos para que eles possam agir, adaptar-se e recuperar-se em vez de apenas gerar texto. Essa distinção é especialmente útil na pesquisa de domínios, onde o trabalho é repetitivo, mas a decisão final não. (Ahrefs: What Is Agentic SEO?)
Acho que a pesquisa de domínios é um dos lugares mais limpos para usar este modelo. A evidência é estruturada, a sequência pode ser descrita, e cada ação cara pode permanecer atrás da aprovação humana.
Índice
- Índice
- O que o SEO agêntico muda: chatbot, automação e agente
- Por que a pesquisa de domínios combina com um agente
- O stack por trás da pesquisa agêntica de domínios
- Um fluxo completo de pesquisa agêntica de domínios
- 1. Traduzir o brief em critérios estruturados
- 2. Buscar o inventário atual
- 3. Triar a identidade anterior do domínio
- 4. Tratar dados ausentes de propósito
- 5. Comparar sobreviventes e preservar o estado
- 6. Gastar dados premium numa lista curta
- 7. Monitorar os registros que importam
- 8. Pedir a um humano para decidir
- MCP, API e webhooks têm papéis separados
- Guardrails tornam o agente útil
- Como começar sem construir um grande sistema de agentes
- FAQ
O que o SEO agêntico muda: chatbot, automação e agente
| Abordagem | O que impulsiona o próximo passo | Bom uso na pesquisa de domínios | Limitação principal |
|---|---|---|---|
| Chatbot | A próxima mensagem do usuário | Explicar um relatório ou ajudar a desenhar filtros | Para quando a conversa para |
| Automação fixa | Condições pré-escritas | Puxar uma busca salva toda manhã e adicionar linhas a um banco de dados | Lida mal com exceções |
| Agente de IA | Um objetivo, ferramentas, estado e regras operacionais | Buscar, inspecionar, comparar, anotar, monitorar e preparar uma shortlist | Precisa de contratos de dados fortes e limites claros de autoridade |
Um agente ganha seu lugar quando consegue operar no sistema de pesquisa: chamar a ferramenta de busca, abrir relatórios, salvar estado e devolver evidência que outra pessoa possa verificar. A Ahrefs faz o mesmo ponto no guia de SEO agêntico: um agente não raciocina melhor do que o modelo numa janela de chat, então o ganho vem das ferramentas, do contexto e da capacidade de recuperar-se de um passo falho.
O SEO agêntico também é fácil de confundir com GEO. O SEO agêntico diz respeito a como o trabalho é realizado; GEO diz respeito à visibilidade em experiências de busca geradas por IA. Os termos se sobrepõem na conversa, mas descrevem problemas diferentes.
Por que a pesquisa de domínios combina com um agente
A pesquisa de domínios expirados tem quatro propriedades que os agentes lidam bem.
Primeiro, o pool de candidatos muda o tempo todo. Novos domínios chegam, preços de leilão se movem, lances mudam e listagens terminam. O processo se beneficia de execuções agendadas ou orientadas a eventos.
Segundo, a primeira passagem de triagem é baseada em regras. Uma equipe pode especificar TLDs, idiomas, tópicos, tetos de preço, idade mínima, sinais de autoridade, assuntos proibidos, fontes de leilão e tempo antes do fechamento.
Terceiro, a evidência vem de várias camadas. Um domínio pode parecer forte por Domain Rating e ainda ter um histórico não relacionado ou tóxico. Outro pode ter um arquivo limpo e um nome comercial, mas pouco valor de links para o projeto pretendido.
Por fim, o processo tem um ponto óbvio de transferência. Um agente pode reduzir milhares de registros a cinco candidatos. Uma pessoa ainda decide se algum desses cinco deve ser comprado.
O stack por trás da pesquisa agêntica de domínios
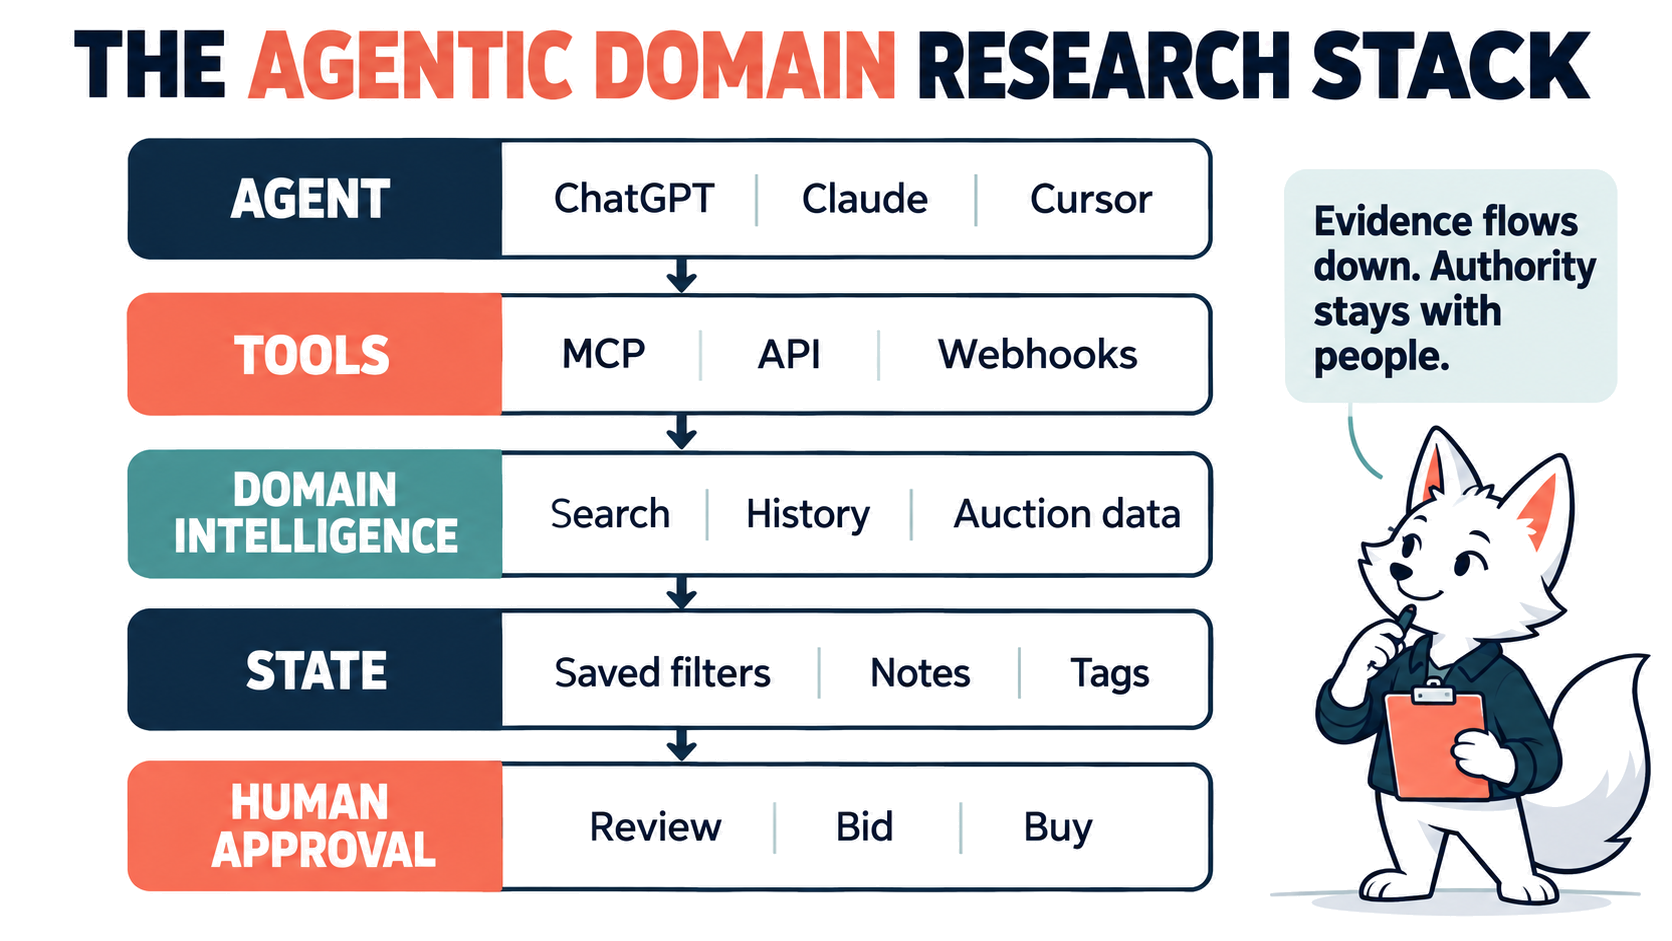
Um stack prático tem cinco partes.
- Um ambiente de agente. Pode ser ChatGPT, Claude, Cursor, uma plataforma de orquestração ou um agente hospedado que rode sob agendamento.
- Ferramentas de dados profissionais. Servidores MCP (Model Context Protocol) e APIs conectam o agente a dados atuais de domínio, backlinks, tráfego, leilão e busca.
- Instruções operacionais reutilizáveis. Um skill ou fluxo define os critérios da equipe, o formato de saída, as regras de orçamento e as condições de escalonamento. O guia da Search Engine Land sobre skills de agentes de SEO faz o mesmo argumento: dê ao agente ferramentas, templates e um revisor em vez de um prompt mais longo. (Search Engine Land: How to build SEO agent skills that actually work)
- Estado. Filtros salvos, IDs de relatório, notas, tags e uma fila externa de revisão impedem que o agente recomece do zero todo dia.
- Aprovação humana. Uma pessoa nomeada é dona do lance, da compra, da revisão de marca e de qualquer exceção às regras.
A Karma.Domains ocupa a camada de inteligência de domínios neste stack. Não é um agente universal de SEO com IA para conteúdo, correções técnicas ou publicação. O produto dá aos agentes acesso à parte de que precisam para aquisição de domínios: descoberta, triagem histórica, dados atuais de leilão e um fluxo de revisão.
A base contém 13M+ domínios de 40 fontes de leilão e adiciona, em média, mais de 400.000 novos domínios por dia. A busca tem 90+ filtros no inventário de leilão, expirados, backorder e buy-now, e o servidor MCP expõe 31 ferramentas para busca, relatórios completos, filtros salvos, notas e tags, links de compartilhamento, SEO Enrich e checagens ao vivo. Os relatórios combinam análise de histórico baseada no Wayback com dados disponíveis da Ahrefs, Majestic, Moz, Semrush, Similarweb e outras fontes. (Karma.Domains)
O tamanho importa porque um agente não consegue recuperar candidatos que nunca entram nas suas ferramentas. Os filtros importam porque “encontre bons domínios” não é uma regra operacional.
Um fluxo completo de pesquisa agêntica de domínios
Considere uma agência de SEO que busca domínios em inglês para clientes de SaaS B2B. O brief diário dela pode ser:
Toda manhã, encontre novos domínios de leilão
.come.iocujo conteúdo arquivado tenha coberto software B2B, ferramentas SaaS ou tecnologia de negócios. Mantenha o preço atual abaixo de $1.000 e pelo menos 24 horas antes do fechamento. Exclua adult, gambling, pharma, pirataria e mudanças óbvias de tópico. Retorne no máximo cinco candidatos com links de relatório, o tópico histórico, os sinais de SEO mais fortes, a principal preocupação e o estado atual do leilão. Não dê lance nem compre.
Aqui está o que acontece por trás desse prompt.
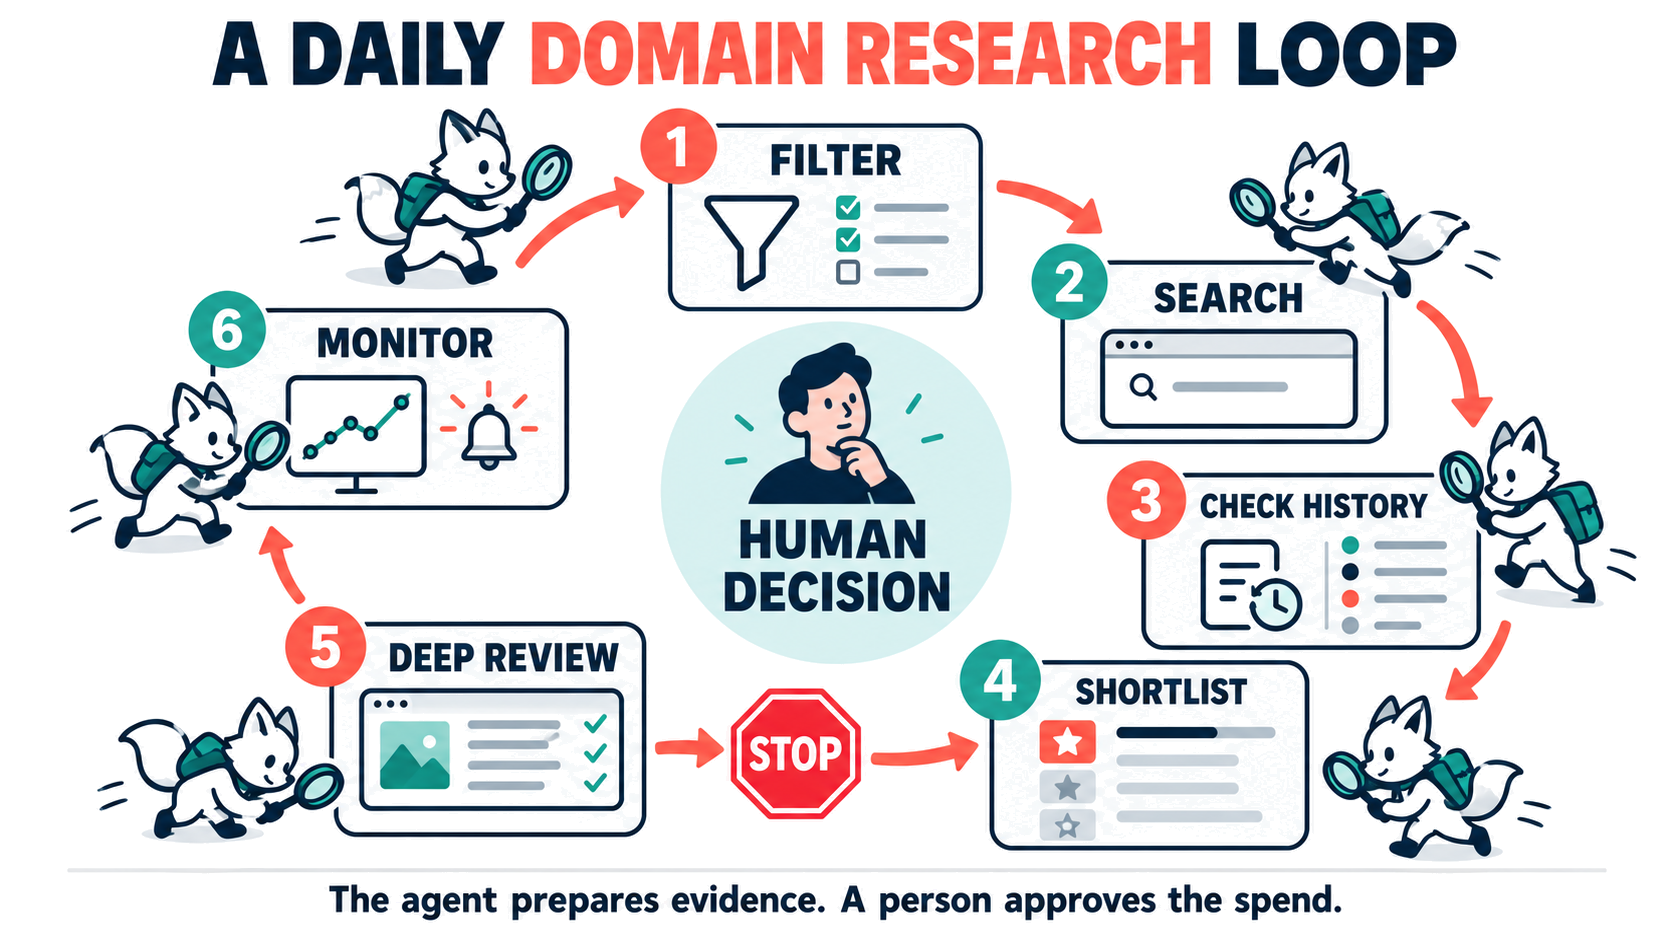
1. Traduzir o brief em critérios estruturados
O agente converte o nicho, TLDs, idioma, preço, timing e regras de risco em filtros suportados. Ele deve expor essas escolhas na saída. Critérios ocultos são difíceis de depurar.
O agente pode então salvar o filtro sob um nome estável como b2b-saas-agency-v1 com save_saved_filter. Se a equipe mudar a idade mínima na semana seguinte, o agente atualiza essa definição salva em vez de inventar uma nova busca a cada execução.
2. Buscar o inventário atual
O agente chama search_reports sobre registros de leilão e expirados em vez de buscar na web aberta. Cada resultado carrega um report_id estável e um link para o relatório completo, para que cada passo posterior possa apontar para a mesma evidência.
Nesta etapa, eu usaria limiares amplos. Uma exigência estrita de cada métrica possível pode atrasar ou apagar bons candidatos porque campos diferentes chegam em momentos diferentes.
3. Triar a identidade anterior do domínio
Para cada candidato, o agente chama get_domain, que retorna o link do relatório, métricas e um resumo do Wayback, e verifica tópicos arquivados, idiomas, redirecionamentos, comportamento do servidor, mudanças de conteúdo e categorias de risco. Um revisor abre o link do relatório para o histórico snapshot a snapshot. É aqui que um nome de domínio plausível costuma falhar.
As métricas de SEO continuam úteis, mas não respondem à pergunta de identidade. O site antigo pode ter começado como um blog SaaS ou de tech e depois virado uma fazenda de cupons ou um site de afiliados de cassino. Uma única pontuação atual comprime esse histórico de forma agressiva demais.
4. Tratar dados ausentes de propósito
A maioria dos relatórios da Karma.Domains já contém dados de SEO. Se um relatório da shortlist estiver sem um campo que a decisão exige, o agente pode iniciar o SEO Enrich com enrich_report_seo e consultar get_enrich_report_seo_job até o job terminar. Enrich é um caminho de exceção para dados ausentes, não um refresh de rotina para cada registro.
5. Comparar sobreviventes e preservar o estado
O agente marca os relatórios sobreviventes com o projeto e o estágio de revisão por meio de set_report_annotation e depois adiciona uma nota curta com o principal motivo para inspecionar ou rejeitar cada domínio. create_share_link dá a um revisor sênior ou a um cliente um link de convidado para o mesmo relatório.
Este passo é fácil de subestimar. Sem estado salvo, o mesmo domínio reaparece na execução de amanhã e consome outro ciclo de revisão.
6. Gastar dados premium numa lista curta
Ahrefs, Semrush e DataForSEO oferecem servidores MCP de SEO, então o mesmo agente pode puxar dados mais profundos de backlinks e keywords. Use-os depois da triagem history-first, quando talvez restem cinco ou dez domínios. O agente pode então inspecionar anchors, concentração de referring domains, links perdidos, histórico de ranking, demanda ou encaixe com concorrentes com mais profundidade.
A ordem controla custo e atenção. Puxar relatórios caros para cada match bruto desperdiça os dois. As checagens ao vivo da Karma.Domains seguem a mesma lógica: spam_score_checker, whois_lookup ou check_domain_expiry devolvem um valor atual para um nome fornecido e usam créditos (acertos de cache são grátis), então também pertencem à shortlist.
7. Monitorar os registros que importam
Os webhooks da Karma.Domains podem enviar JSON assinado para n8n, Zapier, Make, IFTTT ou outro endpoint HTTPS quando um relatório começa a atender às condições de filtro enviadas com a assinatura, para que o fluxo não dependa de um filtro que alguém salvou na UI. Um segundo tipo de assinatura observa até 100 relatórios específicos por preço, contagem de lances, eventos ending-soon e ended. Uma conta pode ter 30 assinaturas e receber 5.000 entregas por dia. (Webhooks de domínios expirados)
Um agente pode usar esses eventos para atualizar a fila de revisão, escrever uma linha numa planilha compartilhada ou preparar um novo brief de decisão para Slack, Telegram ou e-mail. Ele não deve notificar a equipe toda vez que um campo de baixo valor muda. O orçamento de atenção pertence ao fluxo: cinco novos candidatos, um alerta ending-soon ou um movimento material de preço.
8. Pedir a um humano para decidir
O brief final deve incluir os links dos relatórios, as regras aplicadas, os dados atuais de leilão, a evidência que sustenta a recomendação, os campos ausentes e a principal preocupação do agente. Uma entrada de candidato pode listar o domínio e o report_id, a fonte do leilão, o horário de fim e o preço atual, o tópico arquivado por período, o sinal de link mais forte, quaisquer categorias de risco e os campos que ainda faltam.
O revisor então checa o arquivo, backlinks, listagem do marketplace, risco de marca, encaixe com a categoria de produto do cliente e o teto de preço. Um parágrafo confiante do agente não é aprovação.
MCP, API e webhooks têm papéis separados
A Karma.Domains expõe o mesmo fluxo de domínios por várias interfaces.
- MCP encaixa na pesquisa interativa. Um analista pode mudar o brief em linguagem natural, perguntar por que um candidato sobreviveu e escrever notas ou tags de volta no relatório.
- A Expired Domains API encaixa em scripts determinísticos, jobs agendados, dashboards internos e integrações de CRM.
- Webhooks encaixam no monitoramento persistente. Eles empurram um novo match ou uma mudança de leilão para a automação em vez de esperar outro ciclo de polling.
Um fluxo maduro costuma usar os três. A API constrói ou sincroniza a fila. O MCP ajuda um analista a revisá-la. Os webhooks acordam o processo quando algo muda.
Guardrails tornam o agente útil
Fluxos agênticos ficam pouco confiáveis quando as instruções definem o objetivo mas ignoram os limites operacionais. Eu documentaria pelo menos estes controles:
- um número máximo de resultados e um orçamento máximo de chamadas de ferramenta por execução;
- campos de evidência obrigatórios para uma recomendação;
- tratamento claro de valores nulos, desatualizados e conflitantes;
- deduplicação por ID de relatório estável;
- permissões separadas para leitura, anotação e ações externas;
- uma regra de que lances, compras e exceções de orçamento exigem confirmação;
- um registro de auditoria dos critérios e ferramentas usados.
O agente também precisa de um caminho de falha. Se uma fonte estiver indisponível, a saída correta é “não verificado” com os candidatos afetados. Ele não deve substituir um número plausível.
Como começar sem construir um grande sistema de agentes
Comece com uma busca salva e um formato de saída.
Conecte o servidor MCP da Karma.Domains ao ChatGPT ou Claude com um login OAuth, ou use uma chave Bearer no Cursor, Claude Code ou outro cliente de IDE. Sua própria chave de API da Karma.Domains exige Pro, e a mesma chave roda a API e os webhooks; uma conta gratuita começa com 5 créditos de bônus (10 com convite). Peça ao assistente para criar o filtro, executá-lo e devolver uma shortlist de cinco domínios com links de relatório e preocupações. Revise essa saída manualmente por uma semana.
Quando os critérios estiverem estáveis, mova a coleta repetitiva para a API ou um agente agendado. Adicione um webhook só quando houver uma pessoa ou sistema pronto para agir no evento.
Essa ordem mantém a pesquisa inspecionável. As regras vivem no filtro salvo e nas instruções operacionais, para que qualquer um da equipe possa ler por que um domínio foi mantido ou descartado, e uma pessoa ainda toma cada decisão que pode gastar dinheiro ou criar risco de SEO.
FAQ
O que é SEO agêntico?
SEO agêntico é o uso de agentes de IA que podem chamar ferramentas, checar resultados e escolher o próximo passo num fluxo de SEO, com uma pessoa aprovando as decisões que importam. Na pesquisa de domínios, isso significa que o agente busca, tria e anota candidatos, e um especialista decide o que comprar.
SEO agêntico é a mesma coisa que GEO?
Não. SEO agêntico descreve como o trabalho é feito. GEO, ou generative engine optimization, é sobre visibilidade dentro de respostas geradas por IA. Uma equipe pode usar agentes para trabalho de GEO, mas os dois termos respondem a perguntas diferentes.
Um agente de IA pode comprar domínios expirados sozinho?
Não deveria. O servidor MCP da Karma.Domains não tem ferramenta de compra nem de lance, e um fluxo sólido mantém lances, compras e exceções de orçamento atrás da aprovação de uma pessoa nomeada.
Do que um fluxo de SEO agêntico precisa para pesquisa de domínios?
Dados estruturados que ele possa consultar, como um servidor MCP ou API de domínios expirados, critérios escritos para o nicho e os riscos, um lugar para guardar estado como filtros salvos, notas e tags, e uma regra para o que fazer quando dados estão ausentes ou desatualizados.