
Zwei Domains können ähnliche SEO-Metriken und völlig unterschiedliches Investitionspotenzial haben. Wir haben die Domain-Name-Analyse in Karma.Domains gebaut, damit Investorinnen und Investoren solche Fälle trennen können, bevor der teure manuelle Teil der Due Diligence beginnt.
Inhaltsverzeichnis
- Inhaltsverzeichnis
- Ich wollte keinen weiteren Appraisal-Score
- Wir hätten beinahe zu viel gebaut
- Die erste Schicht enthält Fakten
- Wortanzahl erwies sich als KI-Problem
- Die zweite Schicht interpretiert den Namen
- Das Modell war selbstsicher bei schlechten Splits
- Unser Testset begann, uns zu schmeicheln
- Produktionskontrollen zählten mehr als der Prompt
- Vier Wege, wie ich die neuen Filter nutzen würde
- Wie der Report die Entscheidung stützt
- Dieselben Felder funktionieren außerhalb des Browsers
- Wo die Automatisierung endet
Beim Durchsehen von Auktions- und Expired-Domain-Listen in Karma.Domains bin ich immer wieder auf dieselbe Lücke gestoßen. Unsere Reports konnten mir viel über die Vergangenheit einer Domain sagen: was früher auf der Website stand, welche Themen im Archiv vorkamen, ob das Backlink-Profil offensichtliche Risiken zeigte und welche SEO-Signale verfügbar waren.
Über den Namen selbst sagte der Report deutlich weniger.
Für Domain-Investorinnen und -Investoren ist dieser Unterschied wichtig. Ein sauberer zweiwörtiger kommerzieller Name und eine unbeholfene Fragmentkette können mit ähnlichen Authority-Metriken nebeneinander stehen. Der eine ist leicht auszusprechen, leicht zu merken und für mehrere Käuferarten nützlich. Der andere hat möglicherweise gar keinen plausiblen Endnutzer.
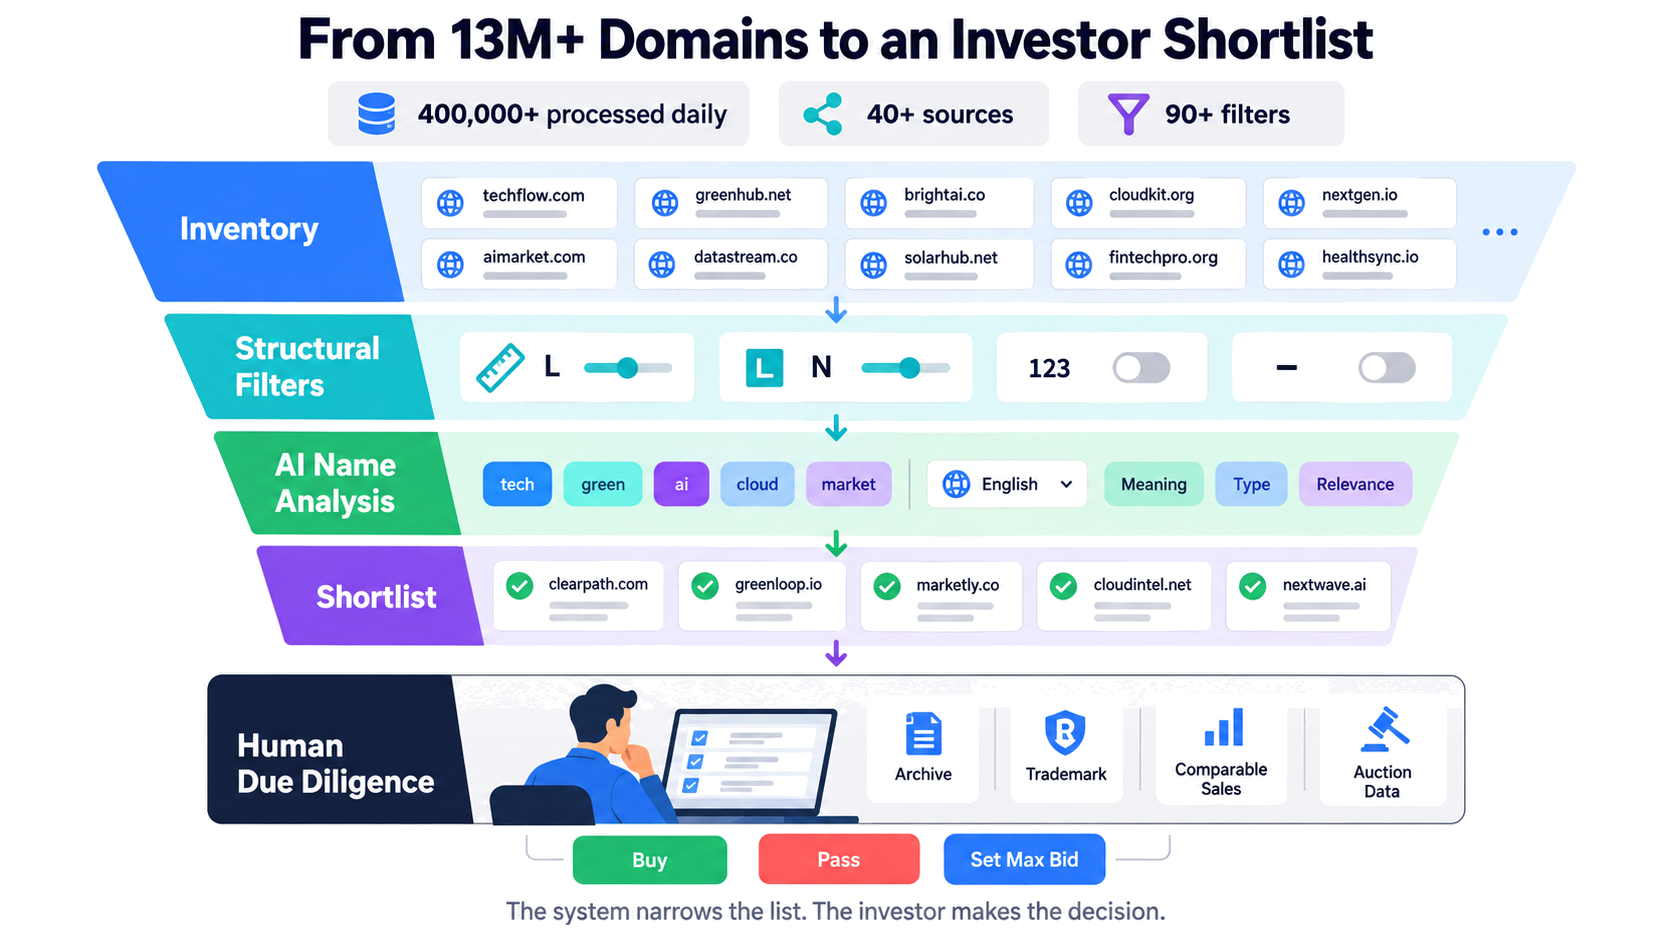
Als unsere Datenbank die Marke von 13 Millionen Expired- und Auktionsdomains überschritt und täglich mehr als 400.000 Domains aus über 40 Quellen verarbeitet wurden, wurde dieser blinde Fleck schwerer zu ignorieren. Karma.Domains unterstützte bereits über 90 Filter und kombinierte verfügbare Daten von Ahrefs, Semrush, Moz, Majestic, Similarweb, der Wayback Machine und anderen Quellen. Investorinnen und Investoren konnten Historie und SEO-Signale detailliert screenern. Tausende Namen mussten sie trotzdem einzeln lesen.
Also bauten wir eine neue Schicht für die Frage, die jede Domainerin und jeder Domainer zuerst stellt: Ist der Name einen genaueren Blick wert?
Ich wollte keinen weiteren Appraisal-Score
Die naheliegende Produktidee war eine einzelne Zahl für „Investmentqualität“. Ich habe sie früh verworfen.
Eine Domain hat keinen universellen Wert außerhalb eines Käufers, eines Marktes, eines Verkaufshorizonts und einer Strategie. Wer sich auf kurze Akronyme spezialisiert, sieht ein anderes Asset als jemand, der ein Portfolio lokaler Service-Domains aufbaut. Eine natürliche Phrase auf Niederländisch kann für ein rein englisches Modell bedeutungslos wirken. Ein starker Geo-Service-Name kann für Lead-Generation nützlich und für einen Brandable-Marketplace irrelevant sein.
Ein einzelner Score würde diese Annahmen verstecken. Schlimmer noch: Er würde eine subjektive Modellausgabe präzise erscheinen lassen.
Karma.Domains hat bereits einen Brand Score, und wir haben ihn getrennt gehalten. Die neue Analyse legt die Evidenz offen, nach der man filtern möchte: Struktur, Wörter, Sprache, Namensyp, Branche und mögliche Exact-Match-Intention. Die Strategie liefert die Investorin oder der Investor.
Meine Meinung dazu ist ziemlich klar: Appraisal ist die falsche Abstraktion für die Discovery-Phase. Discovery soll den Haufen verkleinern und dabei die Gründe erhalten, warum ein Name übrig geblieben ist.
Wir hätten beinahe zu viel gebaut
Unsere erste Produktvision war deutlich größer. Sie umfasste investorenspezifische Views, Projekte, eine Inbox, eine Deal-Pipeline, Monitoring und weitere Workflow-Funktionen.
Die meisten dieser Ideen können weiterhin nützlich sein. Sie waren auch ein guter Weg, monatelang ein separates Produkt zu bauen, bevor bewiesen war, dass Investorinnen und Investoren die zugrunde liegende Analyse überhaupt wollten.
Wir haben den Scope zurückgeschnitten. Das erste Release sollte in der Such- und Report-Erfahrung leben, die die Leute bereits nutzten. Felder zur bestehenden Domain-Akte, Filter zur bestehenden Liste, eine lesbare Aufschlüsselung zum bestehenden Report. Dieselben Daten auch über Public API und MCP.
Diese Entscheidung prägte das Feature. Wir bauten einen besseren ersten Durchgang durchs Inventar – keinen Ersatz für ein Portfolio-System.
Die erste Schicht enthält Fakten
Manche Eigenschaften eines Domainnamens brauchen kein Sprachmodell.
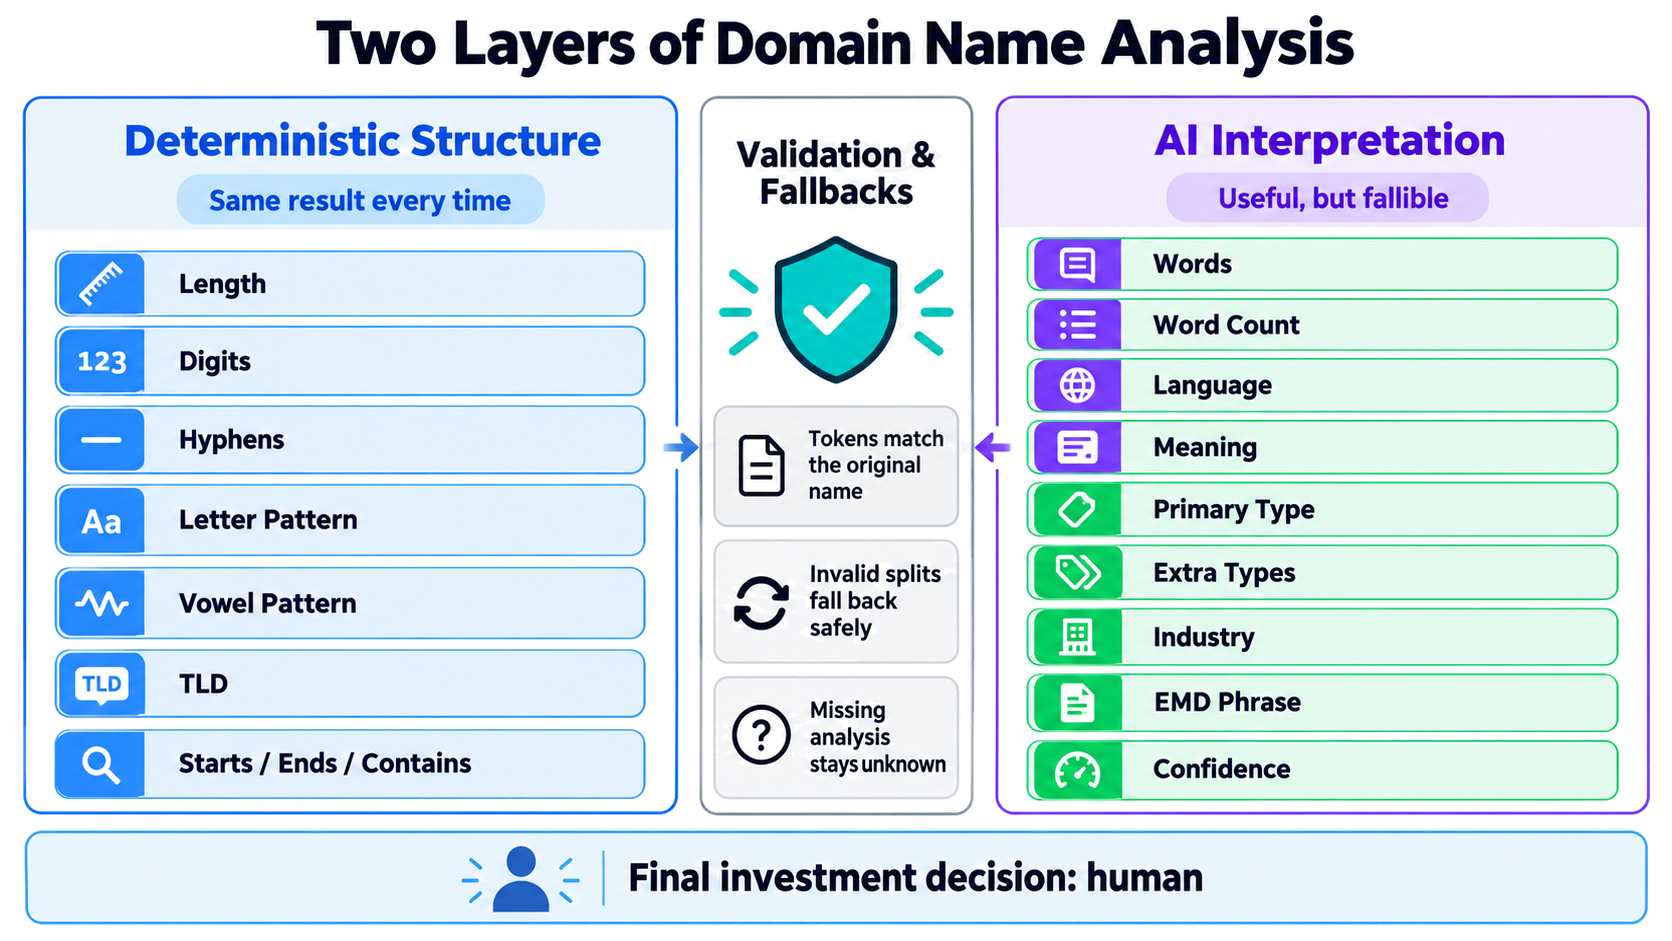
Für die Second-Level-Domain berechnet Karma.Domains:
- Zeichenlänge;
- Anzahl von Ziffern und Bindestrichen;
- ob Ziffern oder Bindestriche vorhanden sind;
- ein Buchstabenmuster;
- ein Vokal- und Konsonantenmuster;
- Text am Anfang, am Ende oder irgendwo im Namen;
- die TLD.
Das Buchstabenmuster nutzt L für einen Buchstaben, N für eine Zahl, H für einen Bindestrich und X für ein anderes Zeichen. Das Vokalmuster nutzt V für einen Vokal, C für einen anderen lateinischen Buchstaben sowie N, H und X.
Nehmen wir solar7.com als einfaches Beispiel. Das Buchstabenmuster ist LLLLLN. Das Vokalmuster ist CVCVCN. Kein Modell muss den Namen „verstehen“, um eines der beiden Ergebnisse zu erzeugen.
Muster sind besonders nützlich, wenn die Form des Assets zählt. Wer nach vierbuchstabigen Namen sucht, kann nach LLLL filtern. Wer aussprechbare Fünf-Buchstaben-Kombinationen recherchiert, kann mit Vokalmustern wie CVCVC arbeiten und danach einen Sprach- oder Namensyp-Filter setzen.
Diese Felder sind vorhersagbar. Denselben Filter morgen erneut ausführen – das strukturelle Ergebnis ändert sich nicht, nur weil ein Modell den Namen anders interpretiert hat.
Wortanzahl erwies sich als KI-Problem
Wortanzahl klingt nach einem weiteren Fakt. Das ist sie nicht – zumindest nicht bei einer Domain ohne Leerzeichen.
Bevor wir sagen können, dass ein Name zwei Wörter enthält, müssen wir entscheiden, wo eines endet und das nächste beginnt. Eightshapes bedeutet wahrscheinlich „eight shapes“. Eine Zeichenkette aus Sprachen, Nachnamen und Abkürzungen kann mehrere vernünftige Splits zulassen. Eine erfundene Marke kann wie zwei bekannte Fragmente aussehen, obwohl die beabsichtigte Lesart ein einziges Kunstwort ist.
Deshalb gehört der Wortanzahl-Filter zum KI-gestützten Teil des Systems. Er hängt von Tokenisierung ab, und Tokenisierung hängt von Bedeutung ab.
Diese kleine Erkenntnis hat die Architektur verändert. Wir haben aufgehört, jedes numerisch wirkende Feld als deterministisch zu behandeln.
Die zweite Schicht interpretiert den Namen
Das Modell erhält Domainnamen und TLD. Beim Klassifizieren sieht es keine Backlink-Metriken, Auktionspopularität, Traffic-Schätzungen oder KarmaScore. Das Ergebnis sollte die Zeichenkette beschreiben – nicht Signale aus anderen Report-Teilen nachträglich rechtfertigen.
Die Analyse versucht zu ermitteln:
- die Wörter im Namen;
- die wahrscheinliche Sprache jedes Wortes;
- eine kurze Bedeutung;
- einen primären Typ wie dictionary word, descriptive phrase, personal name oder brandable;
- zusätzliche Typen, wo sinnvoll, darunter geographic, acronym und EMD;
- eine oder mehrere breite Branchen;
- eine kommerzielle Phrase, wenn der Name wie eine Exact-Match-Domain wirkt;
- ein Gesamtkonfidenzniveau.
Wir nutzen 17 breite Branchenkategorien. Sie sind bewusst grob. „Software“ oder „real estate“ helfen, eine große Liste zu verengen. Ein Modell, das aus sechs Buchstaben einen extrem spezifischen Businessplan erfindet, nicht.
Dieselbe Zurückhaltung gilt für Namensypen. Der Primärtyp muss singular sein. Ein Name kann nicht zugleich klare descriptive phrase und coined brandable sein, nur weil das Modell absichern will. Geographic, acronym und EMD funktionieren als Zusatzattribute, weil sie andere Fragen beantworten.
Auf dem Papier wirkte das geradlinig. Die ersten Tests waren es nicht.
Das Modell war selbstsicher bei schlechten Splits
Der häufigste Fehler war die Wortsegmentierung.
Ein Modell ließ einen offensichtlichen Compound wie eightshapes zusammengeklebt. Bei einem anderen Namen erzeugte es einen Split wie cop + salive, obwohl das zweite Token keinen Sinn ergab. Mehrsprachige Strings brachten eigene Probleme. Ein Name wie vuelostime lädt zu konkurrierenden spanischen und englischen Lesarten ein – und das Modell konnte zwischen ihnen springen, ohne die Mehrdeutigkeit zuzugeben.
Spracherkennung erzeugte eine weitere Fehlerklasse. Frühe Versionen leiteten die Sprache aus der TLD ab, behandelten lateinische Zeichen als Beleg für Englisch oder verwechselten einen Ortsnamen mit einer Sprache. Akronyme wurden manchmal ohne Beleg aufgelöst. Branchenlabels vermehrten sich, sobald ein Wort eine schwache Assoziation mit mehreren Märkten hatte.
Die EMD-Klassifikation schwankte in beide Richtungen. Ein enger Prompt verpasste nützliche kommerzielle Phrasen. Ein breiterer nannte fast jede descriptive Kombination eine Exact-Match-Domain.
Wir haben mehrere Modellfamilien getestet. Manche lieferten fehlerhafte oder abgeschnittene strukturierte Daten. Schnellere Modelle streuten Branchen über schwache Assoziationen. Ein Modell lieferte auf einem Testbatch spürbar bessere linguistische Analyse, war aber für das nötige Volumen zu langsam und zu teuer.
Höhere Temperature half nicht. Das waren systematische Fehler, kein Mangel an Kreativität.
Eine Änderung verbesserte schwierige Namen: das Modell zuerst eine allgemeine Bedeutung bilden lassen, bevor der Wortsplit finalisiert wird. Bei thegeoffcapesfoundation half der semantische Kontext zu the / geoff / capes / foundation. Das löste nicht jeden mehrsprachigen oder mehrdeutigen Fall, gab der Tokenisierung aber einen besseren Startpunkt.
Unser Testset begann, uns zu schmeicheln
Irgendwann haben wir mehrere schwierige Domains und ihre korrekten Interpretationen als Beispiele in den Prompt gelegt. Die nächste Evaluation sah viel besser aus.
Zu viel besser.
Wir testeten wiederholt dieselben Domains. Dem Prompt waren faktisch die Antworten gegeben. Er konnte diese Fälle reproduzieren, ohne eine Regel zu lernen, die auf neues Inventar übertragbar war.
Wir entfernten die domain-spezifischen Beispiele und schrieben sie als allgemeine Anweisungen um. Die Scores fielen. Das war nützlich, weil das schlechtere Ergebnis ehrlich war.
Das war vermutlich die wichtigste Entwicklungslektion des Projekts. Ein Prompt kann hervorragend aussehen, wenn das Testset hineinfließt. Domainnamen machen diesen Fehler leicht übersehbar, weil jeder schwierige String wie ein Spezialfall wirkt, den man als Beispiel hinzufügen möchte.
Danach bewerteten wir Änderungen an ungesehenen Namen – mit besonderem Fokus auf mehrsprachige Strings, lange Compounds, Personennamen, Akronyme und Phrasen, die auf mehr als eine Weise segmentiert werden können.
Produktionskontrollen zählten mehr als der Prompt
Wir verbesserten den Prompt weiter, aber die Prompt-Arbeit stieß irgendwann an abnehmende Erträge. Die Produktionsabsicherungen trugen mehr dazu bei, das Feature vertrauenswürdig zu machen.
Das Backend prüft, dass jedes Token wieder zum Originalnamen zusammengefügt werden kann. Das Modell darf keinen Buchstaben hinzufügen, kein Zeichen weglassen und die Schreibweise nicht still „korrigieren“. Scheitert die Validierung des Splits, fällt das System auf eine sicherere Darstellung zurück.
Das Schema erlaubt einen Primärtyp – das verhindert widersprüchliche Antworten in diesem Feld. Fehlende Analyse bleibt unknown. Wir wandeln eine unverarbeitete oder fehlgeschlagene Klassifikation nicht in ein falsches „no“ um. In der Oberfläche tragen KI-Filter und das Klassifikationspanel den Hinweis, dass das Ergebnis ungenau sein kann.
Dieser Ansatz akzeptiert eine unbequeme Tatsache: Manche Namen sind mehrdeutig, und das Modell liegt manchmal falsch. Die Kontrollen verhindern, dass eine seltsame Antwort zu korrupter Struktur oder falscher Gewissheit wird.
Eine Investorin oder ein Investor kann einen übersehenen Kandidaten weiterhin über benachbarte Filter finden. Das System sollte eine fragwürdige Inferenzen nie hinter einem selbstsicheren Score verschwinden lassen.
Vier Wege, wie ich die neuen Filter nutzen würde
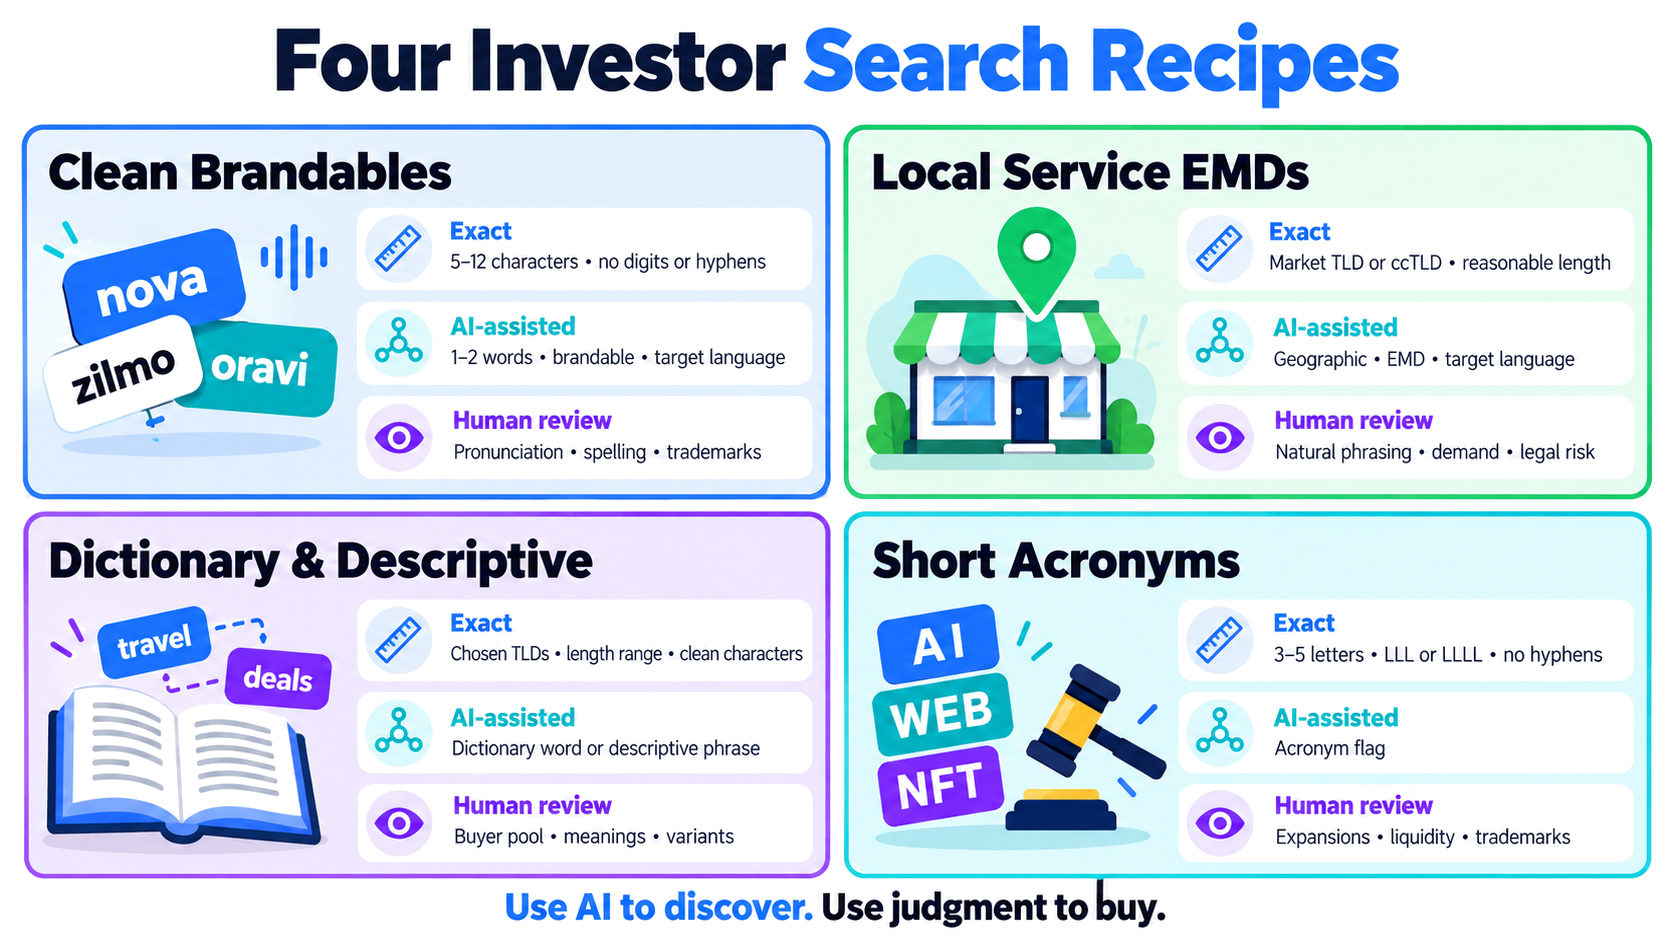
Der praktische Nutzen entsteht, wenn exakte Struktur und semantische Klassifikation zusammenspielen. Hier sind vier Startrezepte. Die Spannen sind Beispiele, keine universellen Kaufregeln.
| Strategie | Strukturelle Filter | KI-gestützte Filter | Manuelle Prüfung |
|---|---|---|---|
| Saubere Brandables | 5–12 Zeichen, keine Ziffern oder Bindestriche, ausgewählte TLDs | Ein oder zwei Wörter, brandable, Zielsprache, relevante Branche | Aussprache, Schreibweise, Radio-Test, vergleichbare Verkäufe, Markenrechte |
| Lokale Service-EMDs | Markt-TLD oder ccTLD, sinnvolle Länge, benötigtes Geo- oder Service-Fragment | Geographic, EMD, Zielsprache, Service-Branche | Natürliche Formulierung, reales Suchverhalten, lokale Nachfrage, rechtliches Risiko |
| Wörterbuch- und descriptive Namen | Gewählte TLDs, Längenbereich, keine unerwünschten Zeichen | Dictionary word oder descriptive phrase, Sprache, Branche | Käuferpool, Alternativbedeutungen, Pluralform, Schreibvarianten |
| Kurze Akronyme | Drei bis fünf Buchstaben, Muster wie LLL oder LLLL, keine Bindestriche | Acronym-Flag und Sprachkontext, wo verfügbar | Plausible Auflösungen, bestehende Organisationen, Liquidität, Markenrechte |
Saubere Brandables
Ich würde mit dem beginnen, was das Modell nicht falsch lesen kann: TLD, Länge, Ziffern, Bindestriche und Muster. Dann würde ich ein oder zwei semantische Constraints hinzufügen – etwa brandable plus software.
Wird die Liste zu klein, lockern Sie zuerst das semantische Feld, bevor Sie die strukturellen Regeln der Strategie aufweichen. Eine falsch gelabelte Branche kann einen guten Namen verstecken. Eine 19-Zeichen-Domain wird kein Sechs-Buchstaben-Brandable, nur weil der Klassifikator sie mag.
Lokale Service-Namen
Geo-Service-Kombinationen profitieren stärker von semantischen Filtern, weil Reihenfolge und Sprache der Phrase zählen. Suchen Sie nach Geographic- und EMD-Flags und prüfen Sie dann Tokenisierung und Bedeutung im Report.
Ein Modell kann erkennen, dass Stadt und Service vorhanden sind. Es kann nicht sagen, ob eine lokale Kundin oder ein lokaler Kunde die Phrase natürlich sagen würde, ob die Suchnachfrage kommerziell nützlich ist oder ob der Markt bereits gesättigt ist.
Wörterbuchwörter und descriptive Phrasen
Sprache ist hier ein nützlicher Discovery-Filter, besonders über ccTLDs hinweg. Sie verdient auch Skepsis. Kurze Wörter existieren in mehreren Sprachen, und Eigennamen ähneln oft Wörterbuchwörtern.
Bevor ich den Typ akzeptiere, würde ich die farbige Wortaufschlüsselung im Report prüfen. Der visuelle Split macht eine fragwürdige Interpretation leichter erkennbar als ein nacktes Label in einer Tabelle.
Akronyme
Der strukturelle Durchgang leistet bei kurzen Akronymen die meiste Arbeit. Das KI-Flag hilft, wahrscheinliche Initialen von gewöhnlichen Kurzwörtern zu trennen – kennt aber nicht jede Organisation, jedes Produkt oder jede Nischenabkürzung.
Bei dieser Strategie sind False Positives günstig. Markenfehler sind es nicht. Halten Sie die KI-Schwelle breit und die rechtlichen sowie Endnutzer-Checks streng.
Wie der Report die Entscheidung stützt
Der Tab Domain name in einem Karma.Domains-Report zeigt beide Schichten getrennt.
Der Abschnitt Structure enthält die Messwerte: Länge, Ziffern, Bindestriche, Buchstabenmuster und Vokalmuster. Der Abschnitt Classification zeigt den vorgeschlagenen Wortsplit, Bedeutung, Typ, Sprachen, Branchen, EMD-Phrase, Wortanzahl und Konfidenz.
Wir nutzen den validierten Wortsplit auch, um eine lesbare CamelCase-Version der Domain anzuzeigen. Beim Kopieren erhalten Sie weiterhin die originale Lowercase-Domain. Die formatierte Version erleichtert das Scannen einer Liste – sie verändert das Asset nicht.
Brand Score steht aus Bequemlichkeit im selben Bereich, bleibt aber ein eigenes Signal. Die Name-Analyse zieht ihn nicht in eine neue Masterzahl ein.
Wenn Sie nur ein paar Dutzend Domains pro Monat prüfen, ist vieles davon vielleicht unnötig. Sie können die Namen selbst lesen. Die Filter werden nützlich, wenn die Rohlliste Tausende Kandidaten enthält oder mehrere Personen dieselbe Portfolio-These konsistent anwenden müssen.
Dieselben Felder funktionieren außerhalb des Browsers
Wir haben das Feature in die bestehende Suchschicht gebaut. Die Namensfelder sind deshalb über die Weboberfläche, die Karma.Domains Public API und den Karma.Domains MCP Server verfügbar.
In der Web-App kann man die neuen Felder mit Auktionsquelle, aktuellem Preis, Endzeit, TLD, Historie und SEO-Filtern kombinieren.
Die API unterstützt wiederholbare Suchen in einem privaten Dashboard, Spreadsheet-Pipeline oder Portfolio-Workflow. Eine These lässt sich als Query-Parameter speichern und gegen neues Inventar laufen lassen, ohne den Screen jedes Mal neu zusammenzubauen.
MCP öffnet dieselbe Suche für ChatGPT, Claude und andere kompatible Assistenten. Eine Anfrage kann gesprächig sein:
Finde kurze
.com-Auktionsnamen ohne Ziffern oder Bindestriche. Behalte ein- oder zweiwörtige englische Namen, die als brandable in software oder finance klassifiziert sind. Zeige Namensaufschlüsselung und Auktionsdetails.
Die nächste Nachricht kann die These anpassen:
Behalte die strukturellen Regeln, entferne finance und nimm descriptive phrases unter zehn Zeichen auf.
Natürliche Sprache macht Iteration leichter. Die eigentliche Suche erledigen weiterhin die darunterliegenden Filter.
Wo die Automatisierung endet
Die Name-Analyse schätzt keinen Verkaufspreis, prognostiziert keine Sell-through-Rate und genehmigt keinen Kauf. Sie ersetzt keine Markenrecherche, kein muttersprachliches Urteil, keine Comparable-Sales-Analyse und keinen genauen Blick auf Archiv und Backlink-Profil.
Sie kennt auch nicht Ihre Holding-Kosten, bevorzugten Marketplaces, Toleranz für Illiquidität oder Zugang zu wahrscheinlichen Käufern. Diese Variablen zählen oft mehr als ein zusätzliches Signal im Report.
Mein bevorzugter Workflow ist einfach. Deterministische Filter definieren die Form des Assets. KI-Felder erschließen Bedeutung und kommerziellen Kontext. Dann die Reports der kleinen Gruppe öffnen, die übrig bleibt. Anschließend Historie, Links, rechtliches Risiko, vergleichbare Verkäufe und aktuelle Auktionsbedingungen prüfen – und erst dann ein Gebot setzen.
Das Feature verdient seinen Platz, wenn es 10.000 Namen in 40 lesenswerte verwandelt. Die vier kaufenswerten auszuwählen bleibt die Arbeit der Investorin oder des Investors.