
Deux domaines peuvent avoir des métriques SEO similaires et un potentiel d’investissement complètement différent. Nous avons conçu l’analyse de noms de domaine dans Karma.Domains pour aider les investisseurs à séparer ces cas avant la partie manuelle et coûteuse de la due diligence.
Table des matières
- Table des matières
- Je ne voulais pas d’un nouveau score d’appraisal
- Nous avons failli construire trop
- La première couche contient des faits
- Le nombre de mots s’est révélé un problème d’IA
- La deuxième couche interprète le nom
- Le modèle était confiant sur de mauvaises découpes
- Notre jeu de test a commencé à nous flatter
- Les contrôles de production ont compté plus que le prompt
- Quatre façons dont j’utiliserais les nouveaux filtres
- Comment le rapport soutient la décision
- Les mêmes champs fonctionnent hors du navigateur
- Où s’arrête l’automatisation
En parcourant les listes d’enchères et de domaines expirés dans Karma.Domains, je tombais sans cesse sur le même angle mort. Nos rapports pouvaient m’en dire beaucoup sur le passé d’un domaine : ce qui se trouvait autrefois sur le site, quels thèmes apparaissaient dans son archive, si son profil de backlinks montrait un risque évident, et quels signaux SEO étaient disponibles.
Le rapport en disait beaucoup moins sur le nom lui-même.
Cette distinction compte pour une investisseuse ou un investisseur en domaines. Un nom commercial propre en deux mots et une chaîne maladroite de fragments peuvent se côtoyer avec des métriques d’autorité similaires. L’un peut être facile à prononcer, facile à mémoriser et utile à plusieurs types d’acheteurs. L’autre peut n’avoir aucun utilisateur final plausible.
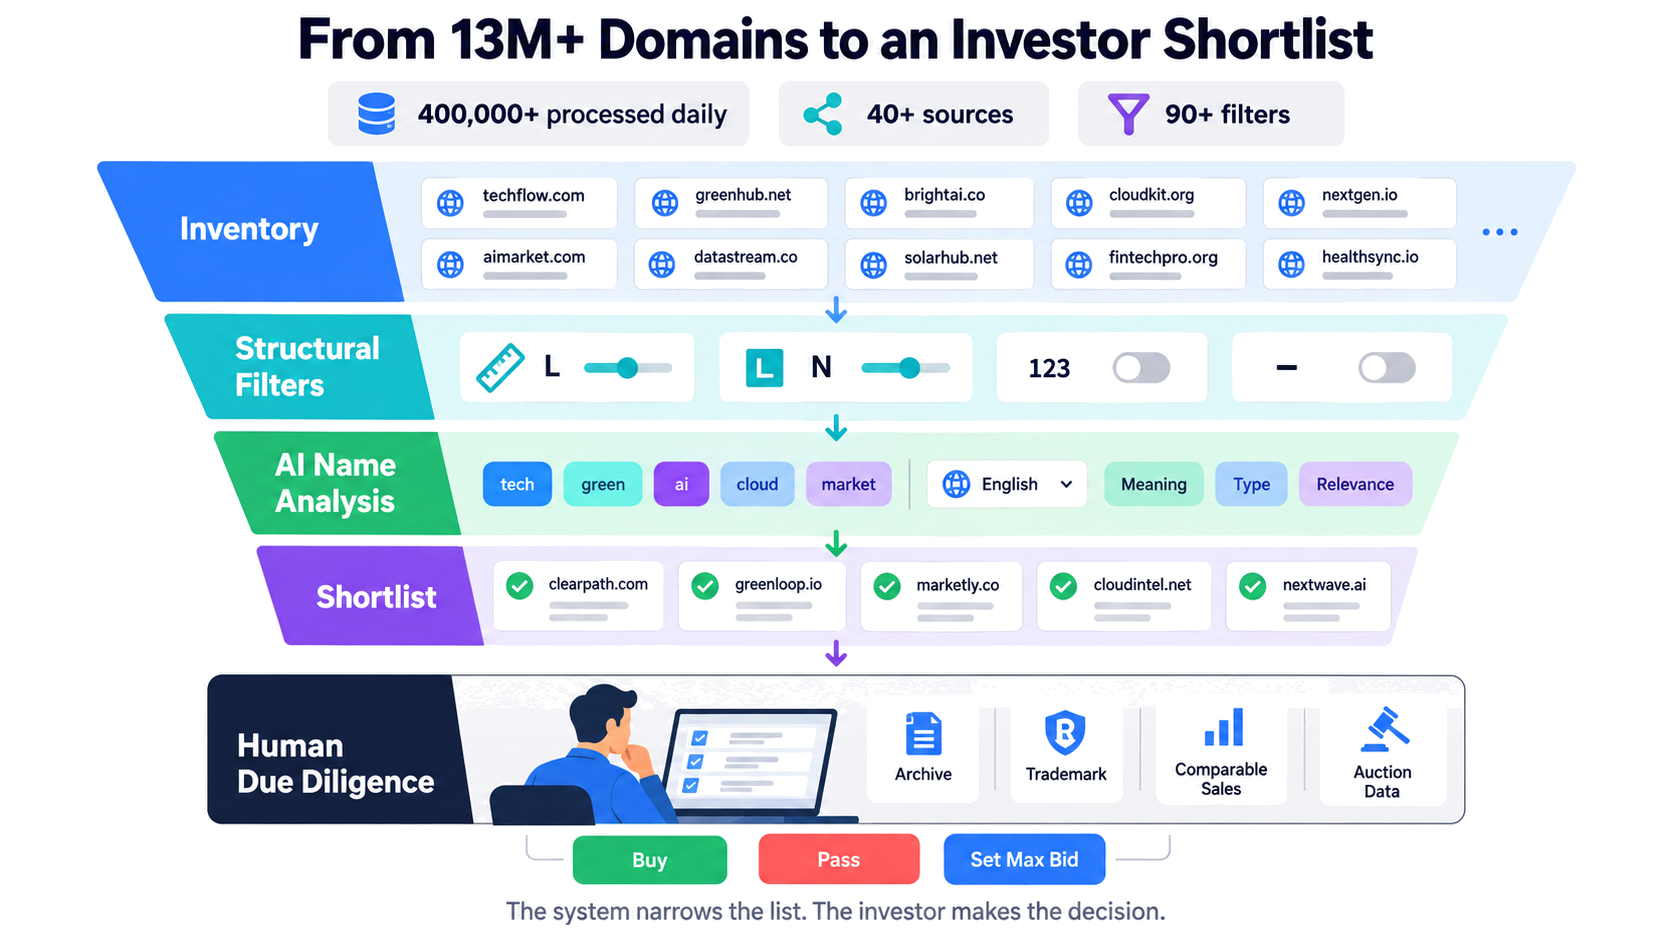
Quand notre base a dépassé 13 millions de domaines expirés et aux enchères, avec plus de 400 000 domaines traités chaque jour depuis plus de 40 sources, cet angle mort est devenu plus difficile à ignorer. Karma.Domains supportait déjà plus de 90 filtres et combinait les données disponibles d’Ahrefs, Semrush, Moz, Majestic, Similarweb, de la Wayback Machine et d’autres sources. Les investisseurs pouvaient filtrer en détail l’historique et les signaux SEO. Ils devaient encore lire des milliers de noms un par un.
Nous avons donc construit une nouvelle couche pour la question que chaque domainer pose d’abord : ce nom mérite-t-il un regard plus attentif ?
Je ne voulais pas d’un nouveau score d’appraisal
L’idée produit évidente était un seul chiffre de « qualité d’investissement ». Je l’ai rejetée tôt.
Un domaine n’a pas de valeur universelle hors d’un acheteur, d’un marché, d’un horizon de vente et d’une stratégie. Une investisseuse spécialisée dans les acronymes courts voit un actif différent de quelqu’un qui construit un portefeuille de domaines de services locaux. Une phrase naturelle en néerlandais peut sembler dénuée de sens pour un modèle uniquement anglophone. Un fort nom geo-service peut servir à un opérateur de génération de leads et être sans intérêt pour une marketplace de brandables.
Un score unique masquerait ces hypothèses. Pire : il ferait paraître précis un résultat de modèle subjectif.
Karma.Domains a déjà un Brand Score, et nous l’avons laissé séparé. La nouvelle analyse expose les preuves sur lesquelles on peut filtrer : structure, mots, langue, type de nom, secteur et éventuelle intention exact-match. C’est l’investisseur qui apporte la stratégie.
Mon avis ici est assez ferme : l’appraisal est la mauvaise abstraction pour l’étape de discovery. La discovery doit réduire le tas tout en préservant les raisons pour lesquelles un nom a survécu.
Nous avons failli construire trop
Notre première vision produit était bien plus large. Elle incluait des vues spécifiques aux investisseurs, des projets, une inbox, un pipeline de deals, du monitoring et plusieurs autres fonctions de workflow.
La plupart de ces idées peuvent encore être utiles. Elles étaient aussi une bonne façon de passer des mois à construire un produit séparé avant de prouver que les investisseurs voulaient l’analyse sous-jacente.
Nous avons réduit le périmètre. La première version devait vivre dans l’expérience de recherche et de rapport déjà utilisée. Ajouter des champs à la fiche domaine existante, des filtres à la liste existante, et une lecture détaillée au rapport existant. Les mêmes données seraient aussi disponibles via Public API et MCP.
Cette décision a façonné la fonctionnalité. Nous construisions un meilleur premier passage sur l’inventaire, pas un remplacement du système de portefeuille d’un investisseur.
La première couche contient des faits
Certaines propriétés d’un nom de domaine n’ont pas besoin d’un modèle de langage.
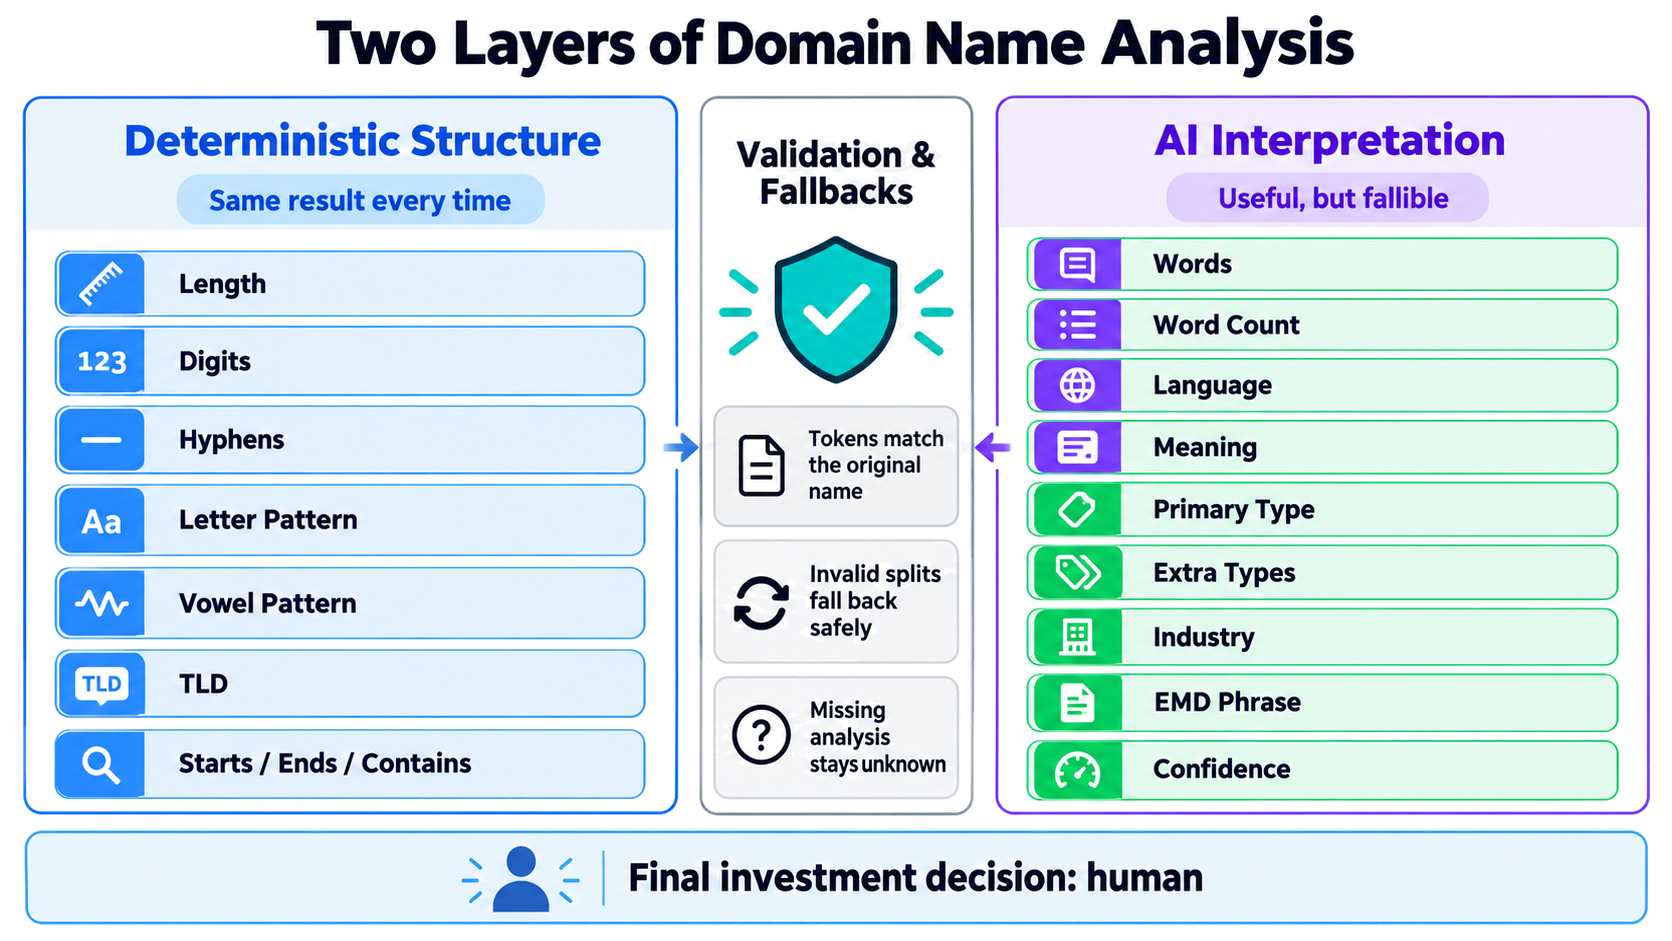
Pour le domaine de second niveau, Karma.Domains calcule :
- la longueur en caractères ;
- le nombre de chiffres et de tirets ;
- la présence de chiffres ou de tirets ;
- un motif de lettres ;
- un motif de voyelles et de consonnes ;
- le texte au début, à la fin ou n’importe où dans le nom ;
- le TLD.
Le motif de lettres utilise L pour une lettre, N pour un chiffre, H pour un tiret et X pour un autre caractère. Le motif de voyelles utilise V pour une voyelle, C pour une autre lettre latine, plus N, H et X.
Prenons solar7.com comme exemple simple. Son motif de lettres est LLLLLN. Son motif de voyelles est CVCVCN. Aucun modèle n’a besoin de « comprendre » le nom pour produire l’un ou l’autre résultat.
Les motifs sont surtout utiles lorsque la forme de l’actif compte. Une investisseuse qui cherche des noms de quatre lettres peut filtrer sur LLLL. Quelqu’un qui explore des combinaisons de cinq lettres prononçables peut travailler avec des motifs de voyelles comme CVCVC, puis appliquer un filtre de langue ou de type de nom.
Ces champs sont prévisibles. Relancez le même filtre demain : le résultat structurel ne changera pas parce qu’un modèle a interprété le nom autrement.
Le nombre de mots s’est révélé un problème d’IA
Le nombre de mots semble être un autre fait. Ce n’est pas le cas — du moins pas pour un domaine sans espaces.
Avant de dire qu’un nom contient deux mots, il faut décider où l’un s’arrête et où le suivant commence. Eightshapes signifie probablement « eight shapes ». Une chaîne qui mélange langues, nom de famille et abréviation peut admettre plusieurs découpes raisonnables. Une marque inventée peut ressembler à deux fragments familiers alors que la lecture voulue est un seul mot inventé.
C’est pourquoi le filtre de nombre de mots appartient à la partie assistée par l’IA du système. Il dépend de la tokenisation, et la tokenisation dépend du sens.
Cette petite prise de conscience a changé l’architecture. Nous avons cessé de traiter comme déterministe tout champ qui avait l’air numérique.
La deuxième couche interprète le nom
Le modèle reçoit le nom de domaine et le TLD. Pendant la classification, il ne voit ni métriques de backlinks, ni popularité d’enchère, ni estimations de trafic, ni KarmaScore. Nous voulions que le résultat décrive la chaîne, pas qu’il rationalise des signaux venus d’ailleurs dans le rapport.
L’analyse cherche à identifier :
- les mots à l’intérieur du nom ;
- la langue probable de chaque mot ;
- un sens court ;
- un type principal, tel que dictionary word, descriptive phrase, personal name ou brandable ;
- des types additionnels le cas échéant, dont geographic, acronym et EMD ;
- un ou plusieurs secteurs larges ;
- une phrase commerciale lorsque le nom semble être un exact-match domain ;
- un niveau de confiance global.
Nous utilisons 17 catégories sectorielles larges. Elles sont volontairement grossières. « Software » ou « real estate » aident à réduire une grande liste. Un modèle qui invente un plan d’affaires ultra-spécifique à partir de six lettres, non.
La même retenue s’applique aux types de noms. Un type principal doit être unique. Un nom ne peut pas être à la fois une descriptive phrase claire et un brandable inventé simplement parce que le modèle veut se couvrir. Geographic, acronym et EMD fonctionnent comme attributs additionnels, car ils répondent à d’autres questions.
Sur le papier, cela paraissait simple. Les premiers tests ne l’étaient pas.
Le modèle était confiant sur de mauvaises découpes
L’erreur la plus fréquente était la segmentation des mots.
Un modèle laissait collé un composé évident comme eightshapes. Sur un autre nom, il produisait une découpe du type cop + salive, alors que le second token n’avait aucun sens. Les chaînes multilingues posaient leurs propres problèmes. Un nom comme vuelostime invite à des lectures espagnole et anglaise concurrentes, et le modèle pouvait passer de l’une à l’autre sans admettre l’ambiguïté.
La détection de langue a créé une autre classe d’erreurs. Les premières versions déduisaient une langue du TLD, traitaient les caractères latins comme preuve d’anglais, ou confondaient un toponyme avec une langue. Les acronymes étaient parfois développés sans preuve. Les libellés sectoriels se multipliaient dès qu’un mot avait une association faible avec plusieurs marchés.
La classification EMD oscillait dans les deux sens. Un prompt étroit manquait des phrases commerciales utiles. Un prompt plus large se mit à appeler exact-match domain presque toute combinaison descriptive.
Nous avons essayé plusieurs familles de modèles. Certains renvoyaient des données structurées mal formées ou tronquées. Les modèles plus rapides avaient tendance à disperser les secteurs sur de faibles associations. Un modèle produisait une analyse linguistique nettement meilleure sur un lot de test, mais il était trop lent et trop cher pour le volume à traiter.
Augmenter la température n’a pas aidé. C’étaient des erreurs systématiques, pas un manque de créativité.
Un changement a amélioré les noms difficiles : demander au modèle de former d’abord un sens général avant de finaliser la découpe en mots. Sur thegeoffcapesfoundation, le contexte sémantique a aidé à arriver à the / geoff / capes / foundation. Cela n’a pas résolu chaque cas multilingue ou ambigu, mais a donné à la tokenisation un meilleur point de départ.
Notre jeu de test a commencé à nous flatter
À un moment, nous avons ajouté au prompt plusieurs domaines difficiles et leurs interprétations correctes comme exemples. L’évaluation suivante paraissait bien meilleure.
Trop meilleure.
Nous retestions régulièrement certains des mêmes domaines. Le prompt avait effectivement reçu les réponses. Il pouvait reproduire ces cas sans apprendre une règle transférable à un nouvel inventaire.
Nous avons retiré les exemples spécifiques aux domaines et les avons réécrits en instructions générales. Les scores ont baissé. C’était utile, car le résultat plus bas était honnête.
Ce fut probablement la leçon de développement la plus importante du projet. Un prompt peut sembler excellent lorsque le jeu de test fuit dedans. Les noms de domaine rendent cette erreur facile à manquer, parce que chaque chaîne gênante semble un cas spécial digne d’être ajouté en exemple.
Ensuite, nous avons jugé les changements sur des noms jamais vus, avec une attention particulière aux chaînes multilingues, aux longs composés, aux noms de personnes, aux acronymes et aux phrases segmentables de plusieurs façons.
Les contrôles de production ont compté plus que le prompt
Nous avons continué à améliorer le prompt, mais le travail sur le prompt a fini par atteindre des rendements décroissants. Les garde-fous de production ont davantage contribué à rendre la fonctionnalité digne de confiance.
Le backend vérifie que chaque token peut être réassemblé en le nom d’origine. Le modèle ne peut ni ajouter une lettre, ni supprimer un caractère, ni « corriger » silencieusement l’orthographe. Si la découpe échoue à la validation, le système revient à une représentation plus sûre.
Le schéma n’autorise qu’un type principal, ce qui empêche les réponses contradictoires sur ce champ. Une analyse manquante reste unknown. Nous ne transformons pas une classification non traitée ou échouée en un faux « no ». Dans l’interface, les filtres issus de l’IA et le panneau de classification portent l’avertissement que le résultat peut être inexact.
Cette approche accepte un fait inconfortable : certains noms sont ambigus, et le modèle se trompera parfois. Les contrôles empêchent qu’une réponse étrange devienne une structure corrompue ou une fausse certitude.
Une investisseuse peut encore trouver un candidat négligé en essayant des filtres voisins. Le système ne doit jamais faire disparaître une inférence douteuse derrière un score confiant.
Quatre façons dont j’utiliserais les nouveaux filtres
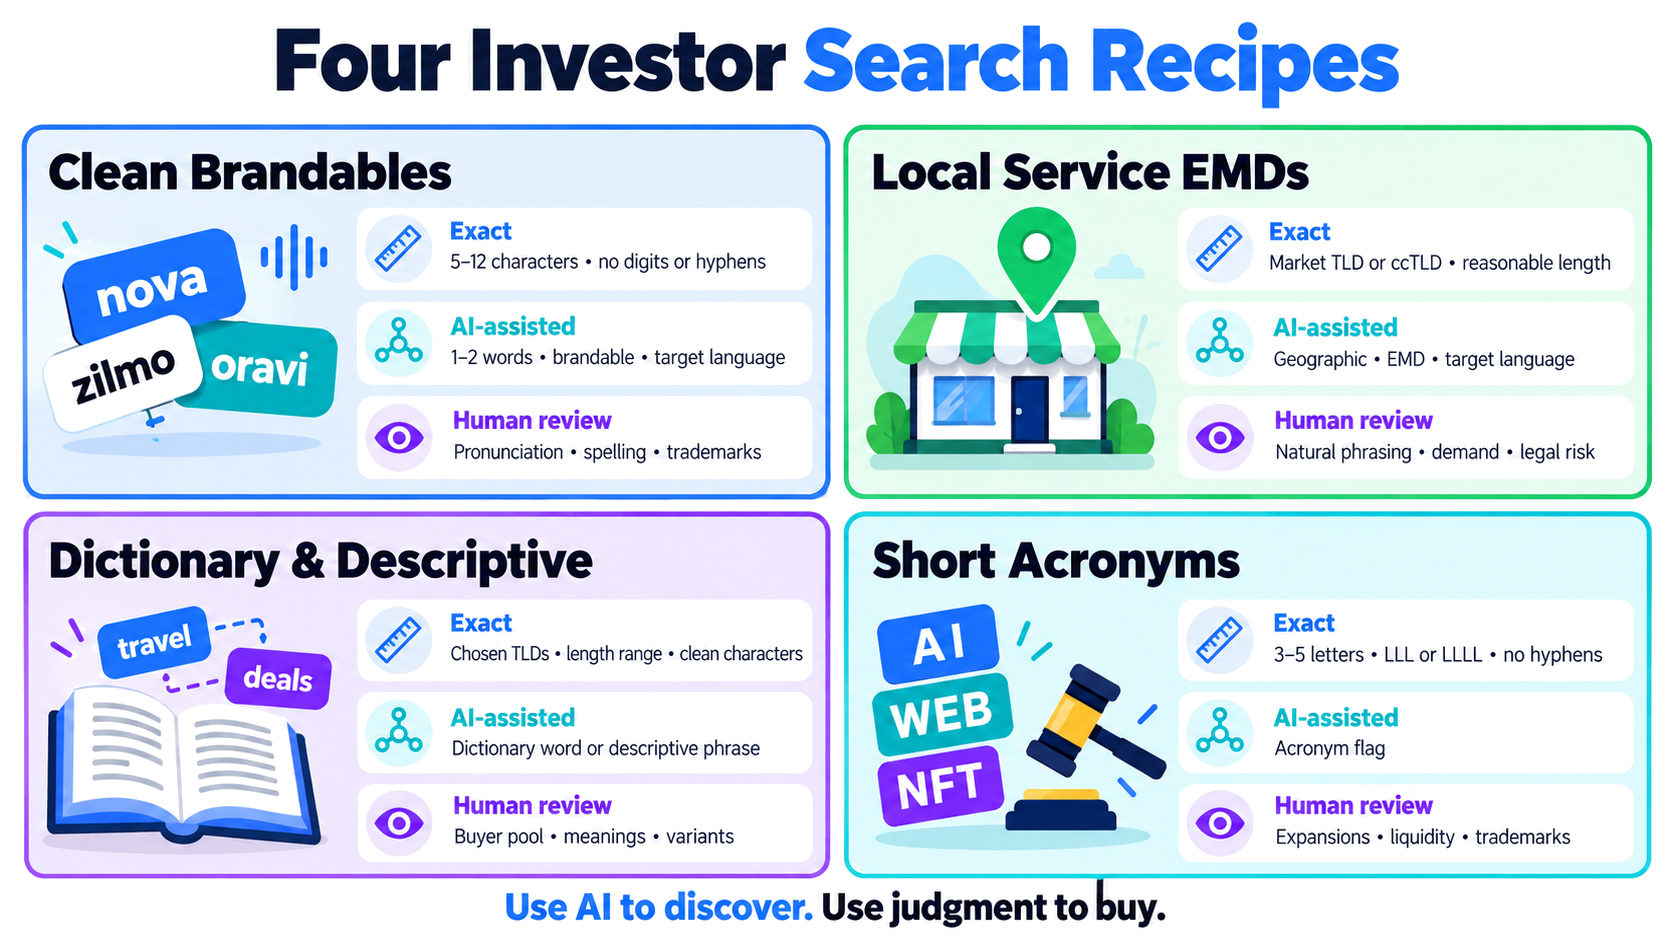
La valeur pratique apparaît lorsque structure exacte et classification sémantique travaillent ensemble. Voici quatre recettes de départ. Les plages sont des exemples, pas des règles d’achat universelles.
| Stratégie | Filtres structurels | Filtres assistés par l’IA | Revue manuelle |
|---|---|---|---|
| Brandables propres | 5–12 caractères, sans chiffres ni tirets, TLD sélectionnés | Un ou deux mots, brandable, langue cible, secteur pertinent | Prononciation, orthographe, radio test, ventes comparables, marques |
| EMD de services locaux | TLD de marché ou ccTLD, longueur raisonnable, fragment geo ou service requis | Geographic, EMD, langue cible, secteur de service | Formulation naturelle, comportement de recherche réel, demande locale, risque juridique |
| Noms dictionnaire et descriptifs | TLD choisis, plage de longueur, sans caractères indésirables | Dictionary word ou descriptive phrase, langue, secteur | Vivier d’acheteurs, sens alternatifs, forme plurielle, variantes d’orthographe |
| Acronymes courts | Trois à cinq lettres, motifs comme LLL ou LLLL, sans tirets | Indicateur acronym et contexte linguistique si disponible | Développements plausibles, organisations existantes, liquidité, marques |
Brandables propres
Je commencerais par ce que le modèle ne peut pas mal lire : TLD, longueur, chiffres, tirets et motif. Puis j’ajouterais une ou deux contraintes sémantiques, par exemple brandable plus software.
Si la liste devient trop petite, assouplissez le champ sémantique avant les règles structurelles qui définissent la stratégie. Un secteur mal étiqueté peut cacher un bon nom. Un domaine de 19 caractères ne devient pas un brandable de six lettres parce que le classifieur l’aime.
Noms de services locaux
Les combinaisons geo-service profitent davantage des filtres sémantiques, car l’ordre et la langue de la phrase comptent. Cherchez les indicateurs geographic et EMD, puis examinez la tokenisation et le sens réellement affichés dans le rapport.
Un modèle peut reconnaître qu’une ville et un service sont présents. Il ne peut pas dire si un client local dirait naturellement la phrase, si la demande de recherche est commercialement utile, ou si le marché est déjà saturé.
Mots du dictionnaire et phrases descriptives
La langue est ici un filtre de discovery utile, surtout sur les ccTLD. Elle mérite aussi du scepticisme. Les mots courts existent dans plusieurs langues, et les noms propres ressemblent souvent à des mots du dictionnaire.
Avant d’accepter le type, j’examinerais la découpe colorée des mots dans le rapport. Le split visuel rend une interprétation douteuse plus facile à repérer qu’une simple étiquette dans un tableau.
Acronymes
Le passage structurel fait l’essentiel du travail pour les acronymes courts. L’indicateur IA aide à séparer les initiales probables des mots courts ordinaires, mais il ne connaît pas chaque organisation, produit ou abréviation de niche.
Pour cette stratégie, les faux positifs sont bon marché. Les erreurs de marque ne le sont pas. Gardez le seuil IA large et les contrôles juridiques et utilisateurs finaux stricts.
Comment le rapport soutient la décision
L’onglet Domain name d’un rapport Karma.Domains montre les deux couches séparément.
La section Structure contient les mesures : longueur, chiffres, tirets, motif de lettres et motif de voyelles. La section Classification montre la découpe proposée, le sens, le type, les langues, les secteurs, la phrase EMD, le nombre de mots et la confiance.
Nous utilisons aussi la découpe validée pour afficher une version CamelCase lisible du domaine. Copier le nom donne toujours le domaine original en minuscules. La version formatée sert à scanner une liste plus facilement, pas à modifier l’actif.
Le Brand Score apparaît dans la même zone par commodité, mais reste son propre signal. L’analyse du nom ne l’absorbe pas dans un nouveau chiffre maître.
Si vous ne passez en revue que quelques dizaines de domaines par mois, une grande partie de cela peut être inutile. Vous pouvez lire les noms vous-même. Les filtres deviennent utiles quand la liste brute contient des milliers de candidats, ou quand plusieurs personnes doivent appliquer la même thèse de portefeuille de façon cohérente.
Les mêmes champs fonctionnent hors du navigateur
Nous avons intégré la fonctionnalité dans la couche de recherche existante, donc les champs de nom sont disponibles via l’interface web, la Public API Karma.Domains et le serveur MCP Karma.Domains.
Dans l’application web, une investisseuse peut combiner les nouveaux champs avec la source d’enchère, le prix actuel, l’heure de fin, le TLD, l’historique et les filtres SEO.
L’API prend en charge des recherches répétables dans un tableau de bord privé, un pipeline tableur ou un workflow de portefeuille. On peut stocker une thèse en paramètres de requête et la lancer sur un nouvel inventaire sans reconstruire l’écran à chaque fois.
MCP expose la même recherche à ChatGPT, Claude et d’autres assistants compatibles. Une demande peut être conversationnelle :
Trouve des noms
.comcourts en enchère, sans chiffres ni tirets. Garde les noms anglais d’un ou deux mots classés brandable en software ou finance. Affiche la découpe du nom et les détails d’enchère.
Le message suivant peut ajuster la thèse :
Garde les règles structurelles, retire finance, et inclus les descriptive phrases de moins de dix caractères.
Le langage naturel facilite l’itération. Ce sont toujours les filtres sous-jacents qui font la vraie recherche.
Où s’arrête l’automatisation
L’analyse du nom n’estime pas un prix de vente, ne prédit pas un taux de sell-through et n’approuve pas un achat. Elle ne remplace ni la recherche de marques, ni le jugement d’une locutrice native, ni l’analyse des ventes comparables, ni un regard attentif sur l’archive et le profil de backlinks.
Elle ne connaît pas non plus votre coût de détention, vos marketplaces préférées, votre tolérance à l’illiquidité ou votre accès à des acheteurs probables. Ces variables comptent souvent plus qu’un signal supplémentaire dans un rapport.
Mon workflow préféré est simple. Utilisez des filtres déterministes pour définir la forme de l’actif. Ajoutez des champs IA pour explorer le sens et le contexte commercial. Ouvrez les rapports du petit groupe qui survit. Puis vérifiez l’historique, les liens, le risque juridique, les ventes comparables et les conditions d’enchère actuelles avant de placer une offre.
La fonctionnalité gagne sa place quand elle transforme 10 000 noms en 40 qui valent la peine d’être lus. Choisir les quatre qui valent la peine d’être achetés reste le travail de l’investisseur.