
Два домена могут иметь похожие SEO-метрики и совершенно разный инвестиционный потенциал. Мы сделали анализ доменных имён в Karma.Domains, чтобы помочь инвесторам разделять такие случаи до дорогой ручной части due diligence.
Содержание
- Содержание
- Я не хотела ещё один appraisal-скор
- Мы чуть не построили слишком много
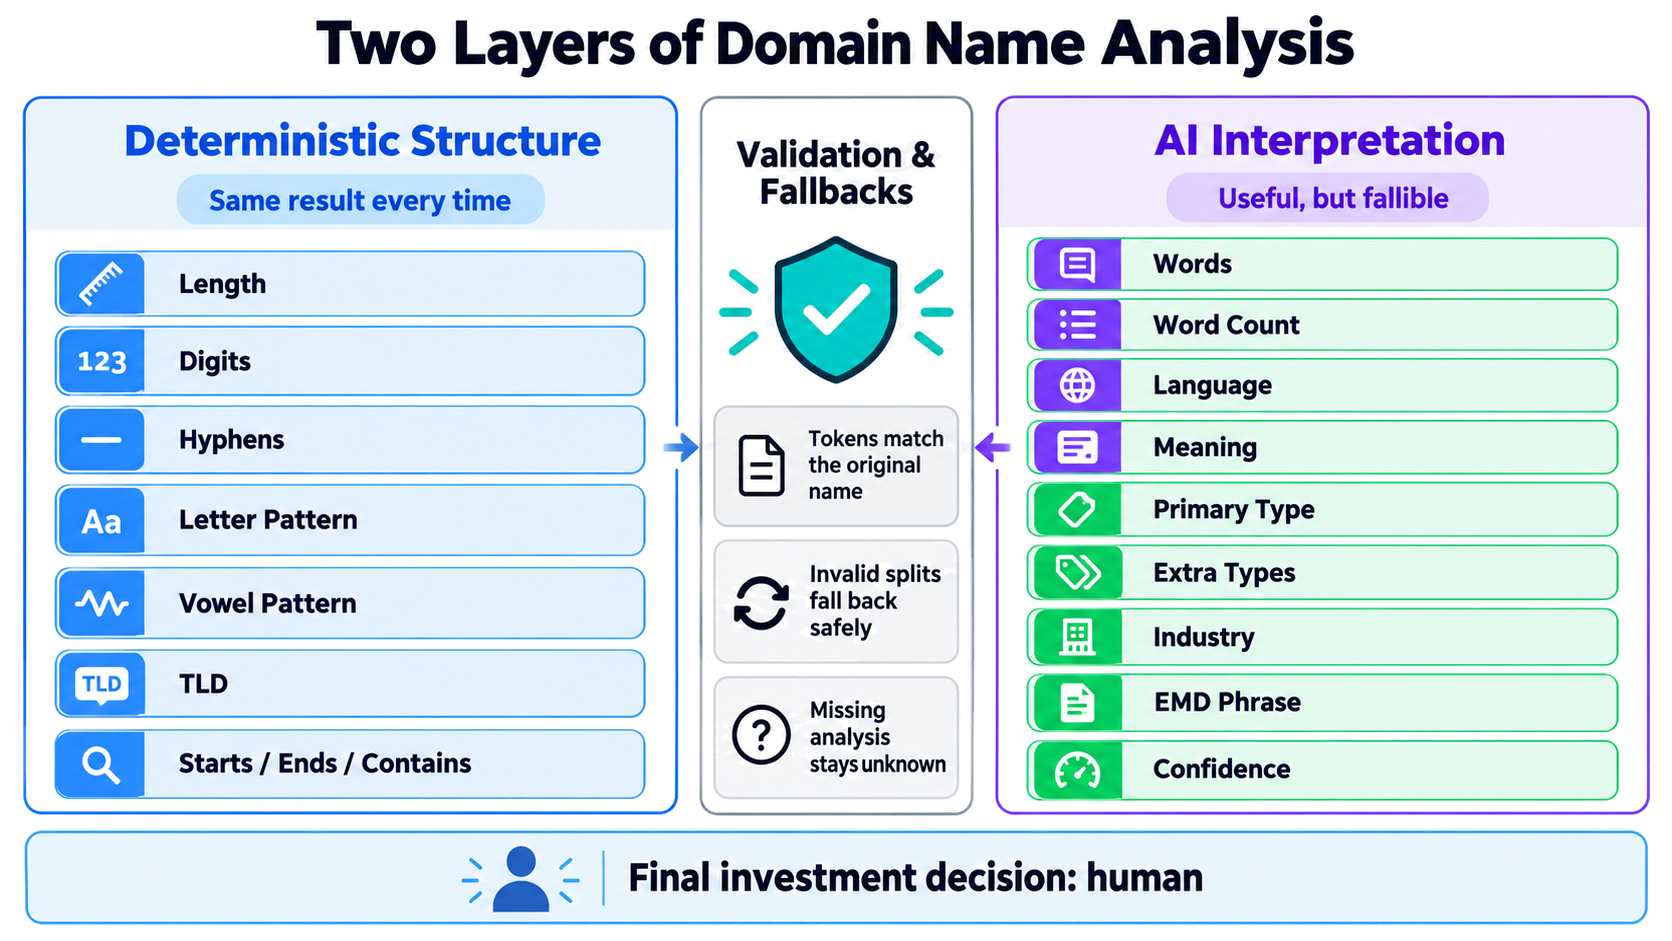
- Первый слой содержит факты
- Подсчёт слов оказался задачей для AI
- Второй слой интерпретирует имя
- Модель уверенно делала плохие разбиения
- Наш тестовый набор начал нам льстить
- Продакшен-контроли оказались важнее промпта
- Четыре способа, как я использовала бы новые фильтры
- Как отчёт поддерживает решение
- Те же поля работают вне браузера
- Где заканчивается автоматизация
Просматривая списки аукционов и expired-доменов в Karma.Domains, я снова и снова натыкалась на один и тот же пробел. Наши отчёты многое говорили о прошлом домена: что раньше было на сайте, какие темы встречались в архиве, есть ли в бэклинк-профиле очевидный риск и какие SEO-сигналы доступны.
Об самом имени отчёт говорил гораздо меньше.
Для доменного инвестора это важное различие. Чистое двухсловное коммерческое имя и неуклюжая склейка фрагментов могут стоять рядом с похожими метриками авторитетности. Одно легко произнести, легко запомнить, и оно полезно разным типам покупателей. У другого может не быть вообще никакого правдоподобного конечного пользователя.
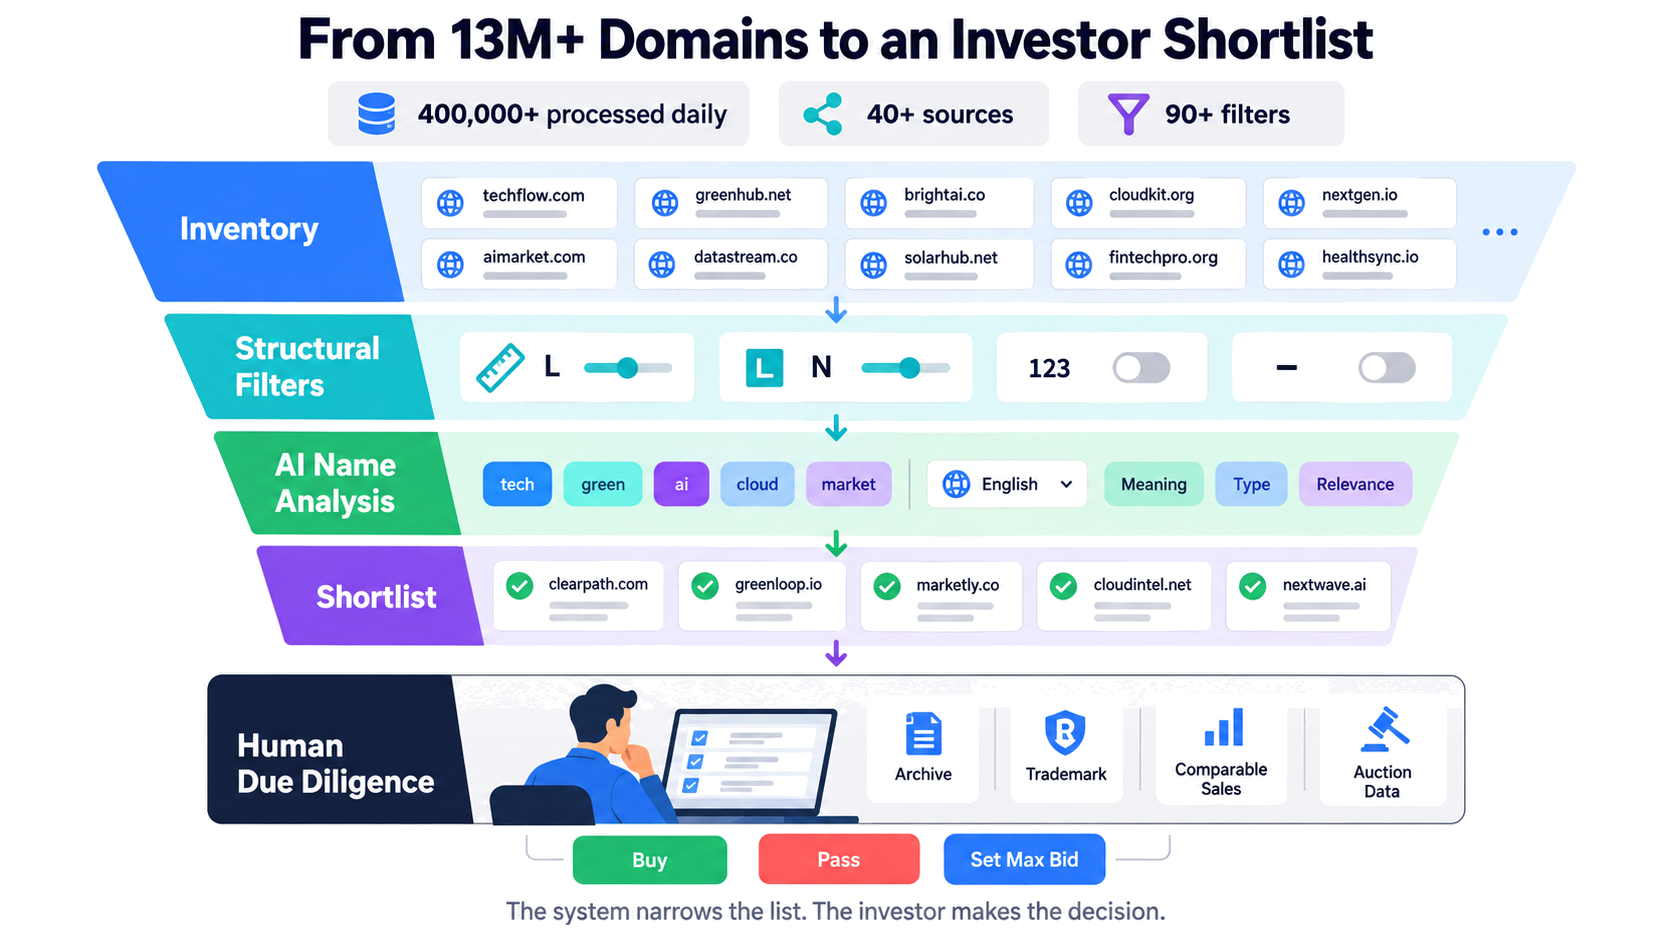
Когда наша база выросла за 13 миллионов expired- и аукционных доменов, а ежедневно обрабатывалось более 400 000 доменов из 40+ источников, эту слепую зону стало труднее игнорировать. Karma.Domains уже поддерживал 90+ фильтров и объединял доступные данные Ahrefs, Semrush, Moz, Majestic, Similarweb, Wayback Machine и других источников. Инвесторы могли подробно просеивать историю и SEO-сигналы. Но тысячи имён по-прежнему приходилось читать одно за другим.
Поэтому мы построили новый слой под вопрос, который каждый domainer задаёт первым: стоит ли имя более пристального взгляда?
Я не хотела ещё один appraisal-скор
Очевидная продуктовая идея — одно число «инвестиционного качества». Я отвергла её на раннем этапе.
У домена нет универсальной ценности вне покупателя, рынка, горизонта продажи и стратегии. Инвестор, который специализируется на коротких акронимах, видит другой актив, чем тот, кто собирает портфель локальных сервисных доменов. Естественная фраза на нидерландском может выглядеть бессмысленной для модели, заточенной только под английский. Сильное geo-service имя полезно оператору лидогенерации и бесполезно для маркетплейса брендируемых имён.
Один скор скрыл бы эти допущения. Хуже того, он сделал бы субъективный вывод модели похожим на точную величину.
В Karma.Domains уже есть Brand Score, и мы оставили его отдельно. Новый анализ показывает доказательства, по которым инвестор может фильтровать: структуру, слова, язык, тип имени, отрасль и возможный exact-match интент. Стратегию задаёт сам инвестор.
Моё мнение здесь довольно жёсткое: appraisal — неправильная абстракция для стадии discovery. Discovery должен уменьшать кучу, сохраняя причины, по которым имя осталось в выборке.
Мы чуть не построили слишком много
Первое продуктовое видение было гораздо шире. В нём были инвесторские представления, проекты, inbox, deal pipeline, мониторинг и ещё несколько workflow-функций.
Большая часть этих идей всё ещё может быть полезной. Но это также был хороший способ потратить месяцы на отдельный продукт до того, как доказать, что инвесторам нужен сам анализ.
Мы сузили scope. Первый релиз должен был жить внутри уже привычного поиска и отчёта. Добавить поля в существующую карточку домена, фильтры в существующий список и читаемую разбивку в существующий отчёт. Те же данные — через Public API и MCP.
Это решение определило фичу. Мы строили лучший первый проход по инвентарю, а не замену портфельной системе инвестора.
Первый слой содержит факты
Некоторые свойства доменного имени не требуют языковой модели.
Для домена второго уровня Karma.Domains считает:
- длину в символах;
- количество цифр и дефисов;
- наличие цифр или дефисов;
- буквенный паттерн;
- паттерн гласных и согласных;
- текст в начале, в конце или в любой части имени;
- TLD.
В буквенном паттерне L — буква, N — цифра, H — дефис, X — другой символ. В паттерне гласных V — гласная, C — другая латинская буква, плюс N, H и X.
Возьмём простой пример — solar7.com. Буквенный паттерн: LLLLLN. Паттерн гласных: CVCVCN. Модели не нужно «понимать» имя, чтобы получить любой из этих результатов.
Паттерны особенно полезны, когда важна форма актива. Инвестор, который ищет четырёхбуквенные имена, может фильтровать по LLLL. Тот, кто исследует произносимые пятибуквенные комбинации, может работать с паттернами гласных вроде CVCVC, а затем добавить фильтр по языку или типу имени.
Эти поля предсказуемы. Запустите тот же фильтр завтра — структурный результат не изменится из-за того, что модель иначе интерпретировала имя.
Подсчёт слов оказался задачей для AI
Подсчёт слов звучит как ещё один факт. Это не так — по крайней мере, не для домена без пробелов.
Прежде чем сказать, что в имени два слова, нужно решить, где заканчивается одно и начинается следующее. Eightshapes, вероятно, значит «eight shapes». Строка, где смешаны языки, фамилия и аббревиатура, может допускать несколько разумных разбиений. Выдуманный бренд может выглядеть как два знакомых фрагмента, даже если задумывалось одно придуманное слово.
Поэтому фильтр по числу слов относится к AI-assisted части системы. Он зависит от токенизации, а токенизация зависит от смысла.
Это небольшое наблюдение изменило архитектуру. Мы перестали считать каждое «похожее на число» поле детерминированным.
Второй слой интерпретирует имя
Модель получает доменное имя и TLD. Во время классификации она не видит метрики бэклинков, популярность на аукционе, оценки трафика или KarmaScore. Мы хотели, чтобы результат описывал строку, а не рационализировал сигналы из других частей отчёта.
Анализ пытается определить:
- слова внутри имени;
- вероятный язык каждого слова;
- короткое значение;
- один основной тип: dictionary word, descriptive phrase, personal name или brandable;
- дополнительные типы, где это уместно: geographic, acronym и EMD;
- одну или несколько широких отраслей;
- коммерческую фразу, если имя похоже на exact-match domain;
- общий уровень уверенности.
Мы используем 17 широких отраслевых категорий. Они намеренно грубые. «Software» или «real estate» помогают сузить большой список. Модель, которая из шести букв сочиняет сверхконкретный бизнес-план, — нет.
Та же сдержанность относится к типам имён. Основной тип должен быть один. Имя не может одновременно быть явной descriptive phrase и coined brandable только потому, что модель хочет подстраховаться. Geographic, acronym и EMD работают как дополнительные атрибуты, потому что отвечают на другие вопросы.
На бумаге это выглядело просто. Первые тесты — нет.
Модель уверенно делала плохие разбиения
Самая частая ошибка — сегментация слов.
Модель оставляла очевидный компаунд вроде eightshapes слитым. На другом имени выдавала разбиение в духе cop + salive, хотя второй токен не имел смысла. Многоязычные строки создавали свою проблему. Имя вроде vuelostime провоцирует конкурирующие испанские и английские чтения, и модель могла прыгать между ними, не признавая неоднозначность.
Детекция языка дала другой класс ошибок. Ранние версии выводили язык из TLD, считали латинские символы доказательством английского или путали топоним с языком. Акронимы иногда раскрывались без оснований. Отраслевые метки размножались, когда у слова была слабая связь сразу с несколькими рынками.
Классификация EMD качалась в обе стороны. Узкий промпт пропускал полезные коммерческие фразы. Более широкий начинал называть exact-match domain почти любую описательную комбинацию.
Мы пробовали несколько семейств моделей. Некоторые возвращали битые или обрезанные структурированные данные. Более быстрые модели чаще размазывали отрасли по слабым ассоциациям. Одна модель заметно лучше делала лингвистический анализ на тестовом батче, но была слишком медленной и дорогой для нужного нам объёма.
Повышение temperature не помогло. Это были системные ошибки, а не нехватка креативности.
Одно изменение действительно улучшило сложные имена: сначала попросить модель сформировать общее значение, а уже потом финализировать разбиение на слова. На thegeoffcapesfoundation семантический контекст помог прийти к the / geoff / capes / foundation. Это не решило каждый многоязычный или неоднозначный случай, но дало токенизации лучшую точку старта.
Наш тестовый набор начал нам льстить
В какой-то момент мы добавили в промпт несколько сложных доменов и их правильные интерпретации как примеры. Следующая оценка выглядела гораздо лучше.
Слишком лучше.
Мы снова и снова тестировали часть тех же доменов. Промпту по сути уже дали ответы. Он мог воспроизводить эти случаи, не выучив правило, которое переносится на новый инвентарь.
Мы убрали доменно-специфичные примеры и переписали их как общие инструкции. Оценки упали. Это было полезно: более низкий результат был честным.
Вероятно, это самый важный урок разработки в проекте. Промпт может выглядеть отлично, когда тестовый набор в него протекает. С доменными именами эту ошибку легко не заметить: каждая проблемная строка кажется особым случаем, который стоит добавить как пример.
После этого мы оценивали изменения на невиданных именах, уделяя особое внимание многоязычным строкам, длинным компаундам, личным именам, акронимам и фразам, которые можно сегментировать несколькими способами.
Продакшен-контроли оказались важнее промпта
Мы продолжали улучшать промпт, но в какой-то момент упёрлись в убывающую отдачу. Больше для доверия к фиче сделали продакшен-защиты.
Бэкенд проверяет, что каждый токен можно снова склеить в исходное имя. Модель не может добавить букву, выкинуть символ или тихо «исправить» написание. Если разбиение не проходит валидацию, система откатывается к более безопасному представлению.
Схема допускает только один primary type — это не даёт противоречивых ответов в этом поле. Отсутствующий анализ остаётся unknown. Мы не превращаем необработанную или проваленную классификацию в ложное «no». В интерфейсе AI-фильтры и панель классификации несут предупреждение, что результат может быть неточным.
Этот подход принимает неудобный факт: некоторые имена неоднозначны, и модель иногда ошибается. Контроли не дают странному ответу превратиться в повреждённую структуру или ложную уверенность.
Инвестор всё ещё может найти упущенного кандидата соседними фильтрами. Система никогда не должна прятать сомнительный вывод за уверенным скором.
Четыре способа, как я использовала бы новые фильтры
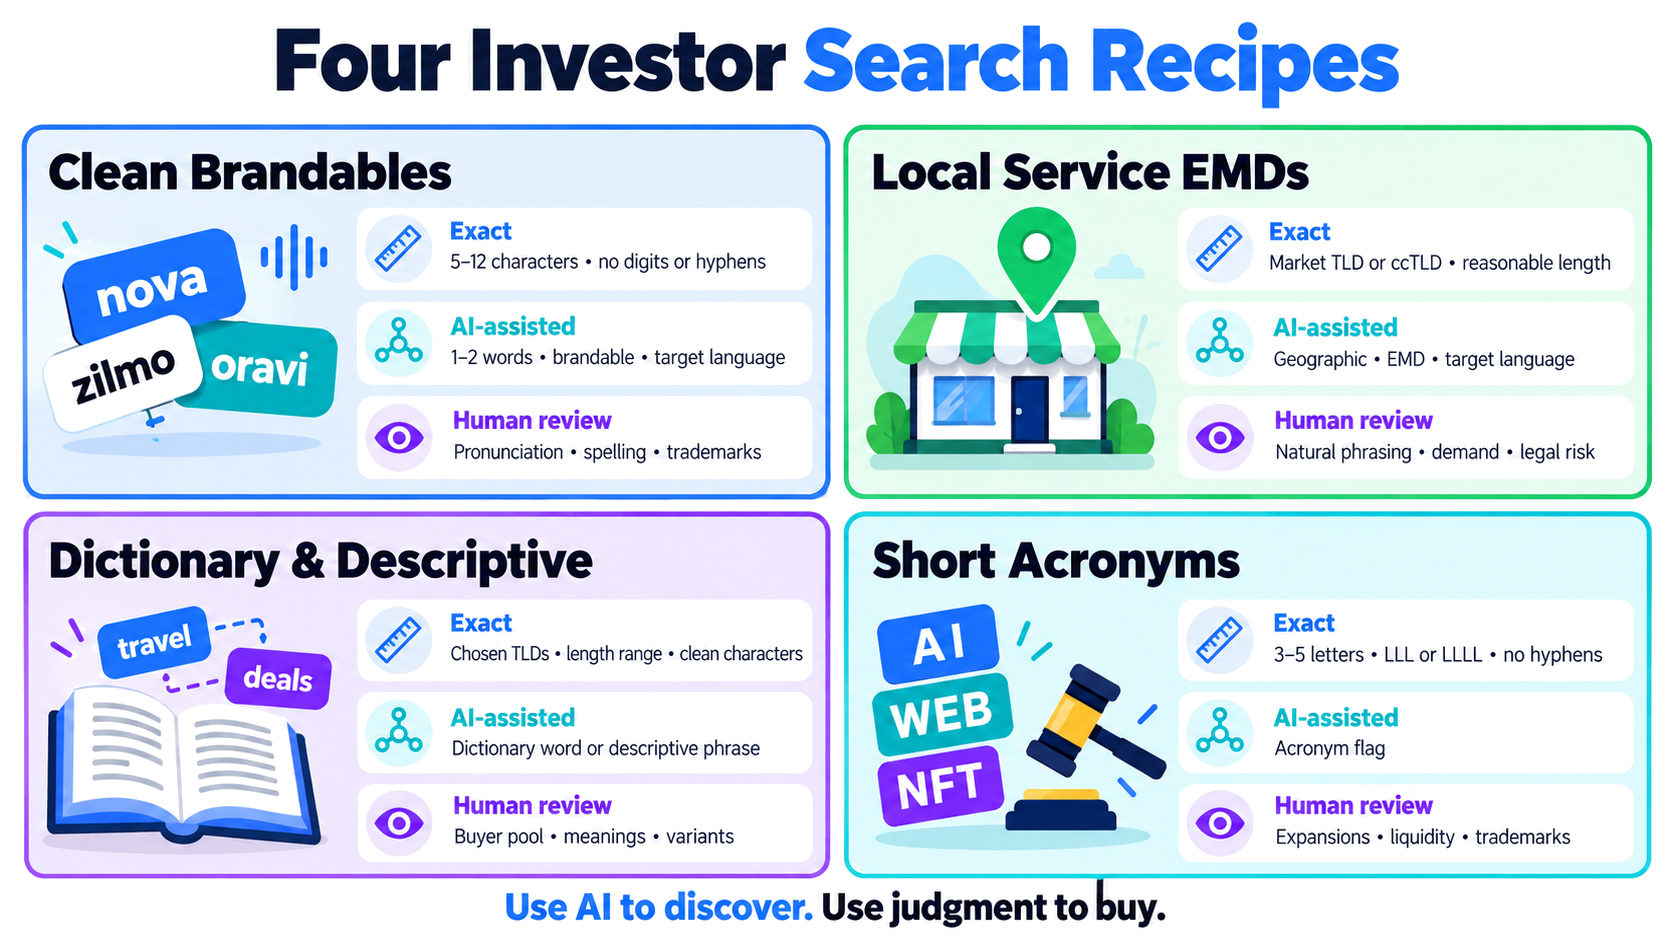
Практическая ценность появляется, когда точная структура и семантическая классификация работают вместе. Вот четыре стартовых рецепта. Диапазоны — примеры, а не универсальные правила покупки.
| Стратегия | Структурные фильтры | AI-assisted фильтры | Ручная проверка |
|---|---|---|---|
| Чистые brandables | 5–12 символов, без цифр и дефисов, выбранные TLD | Одно или два слова, brandable, целевой язык, релевантная отрасль | Произношение, написание, radio test, сопоставимые продажи, товарные знаки |
| Локальные сервисные EMD | Рыночный TLD или ccTLD, разумная длина, нужный geo- или service-фрагмент | Geographic, EMD, целевой язык, сервисная отрасль | Естественность фразы, реальное поисковое поведение, локальный спрос, юридический риск |
| Словарные и описательные имена | Выбранные TLD, диапазон длины, без нежелательных символов | Dictionary word или descriptive phrase, язык, отрасль | Пул покупателей, альтернативные значения, множественное число, варианты написания |
| Короткие акронимы | Три–пять букв, паттерны вроде LLL или LLLL, без дефисов | Флаг acronym и языковой контекст, где доступен | Правдоподобные расшифровки, существующие организации, ликвидность, товарные знаки |
Чистые brandables
Я бы начала с того, что модель не может прочитать неправильно: TLD, длина, цифры, дефисы и паттерн. Затем добавила бы одно-два семантических ограничения — например, brandable плюс software.
Если список становится слишком маленьким, ослабляйте семантическое поле раньше структурных правил, которые определяют стратегию. Неверно размеченная отрасль может спрятать хорошее имя. Домен из 19 символов не становится шестибуквенным brandable только потому, что классификатору он нравится.
Локальные сервисные имена
Geo-service комбинации больше выигрывают от семантических фильтров, потому что важны порядок и язык фразы. Ищите флаги geographic и EMD, затем смотрите фактическую токенизацию и значение в отчёте.
Модель может распознать, что в имени есть город и услуга. Она не скажет, произнёс ли бы локальный клиент эту фразу естественно, полезен ли поисковый спрос коммерчески и не перенасыщен ли уже рынок.
Словарные слова и описательные фразы
Язык здесь полезный discovery-фильтр, особенно по ccTLD. Но к нему стоит относиться скептически. Короткие слова существуют в нескольких языках, а имена собственные часто похожи на словарные.
Перед тем как принять тип, я бы посмотрела цветную разбивку слов в отчёте. Визуальное разбиение делает сомнительную интерпретацию заметнее, чем голая метка в таблице.
Акронимы
Для коротких акронимов основную работу делает структурный проход. AI-флаг помогает отделить вероятные инициалы от обычных коротких слов, но он не знает каждую организацию, продукт или нишевую аббревиатуру.
В этой стратегии ложные срабатывания дёшевы. Ошибки с товарными знаками — нет. Держите AI-порог широким, а юридические и end-user проверки — строгими.
Как отчёт поддерживает решение
Вкладка Domain name в отчёте Karma.Domains показывает оба слоя отдельно.
Секция Structure содержит измерения: длина, цифры, дефисы, буквенный паттерн и паттерн гласных. Секция Classification показывает предложенное разбиение на слова, значение, тип, языки, отрасли, EMD-фразу, число слов и уверенность.
Мы также используем валидированное разбиение, чтобы показать читаемую CamelCase-версию домена. При копировании имени вы по-прежнему получаете исходный lowercase-домен. Форматированная версия нужна, чтобы список было легче сканировать, а не чтобы менять актив.
Brand Score рядом для удобства, но остаётся отдельным сигналом. Анализ имени не втягивает его в новый «главный» скор.
Если вы просматриваете лишь несколько десятков доменов в месяц, многое из этого может быть лишним. Имена можно читать самому. Фильтры становятся полезны, когда в сыром списке тысячи кандидатов или когда несколько человек должны последовательно применять одну и ту же портфельную тезу.
Те же поля работают вне браузера
Мы встроили фичу в существующий поисковый слой, поэтому поля имени доступны через веб-интерфейс, Public API Karma.Domains и MCP-сервер Karma.Domains.
В веб-приложении инвестор может комбинировать новые поля с источником аукциона, текущей ценой, временем окончания, TLD, историей и SEO-фильтрами.
API поддерживает повторяемые поиски внутри приватного дашборда, spreadsheet-пайплайна или портфельного workflow. Инвестор может сохранить тезу как параметры запроса и прогонять её по новому инвентарю, не собирая экран заново каждый раз.
MCP открывает тот же поиск для ChatGPT, Claude и других совместимых ассистентов. Запрос может быть разговорным:
Найди короткие аукционные
.comбез цифр и дефисов. Оставь одно- или двухсловные английские имена, классифицированные как brandable в software или finance. Покажи разбивку имени и детали аукциона.
Следующее сообщение может скорректировать тезу:
Сохрани структурные правила, убери finance и включи descriptive phrases короче десяти символов.
Естественный язык упрощает итерацию. Реальный поиск по-прежнему делают нижележащие фильтры.
Где заканчивается автоматизация
Анализ имени не оценивает цену продажи, не предсказывает sell-through rate и не одобряет покупку. Он не заменяет проверку товарных знаков, суждение носителя языка, анализ сопоставимых продаж или внимательный взгляд на архив и бэклинк-профиль.
Он также не знает вашу стоимость удержания, предпочитаемые маркетплейсы, терпимость к неликвидности или доступ к вероятным покупателям. Эти переменные часто важнее ещё одного сигнала в отчёте.
Мой предпочтительный workflow прост. Детерминированными фильтрами задайте форму актива. AI-полями исследуйте смысл и коммерческий контекст. Откройте отчёты по небольшой группе, которая осталась. Затем проверьте историю, ссылки, юридический риск, сопоставимые продажи и текущие условия аукциона — и только потом ставьте ставку.
Фича оправдывает себя, когда превращает 10 000 имён в 40, которые стоит прочитать. Выбрать четыре, которые стоит купить, по-прежнему работа инвестора.