
Dos dominios pueden tener métricas SEO similares y un potencial de inversión completamente distinto. Creamos el análisis de nombres de dominio en Karma.Domains para ayudar a las inversoras y los inversores a separar esos casos antes de la parte manual y cara del due diligence.
Tabla de contenidos
- Tabla de contenidos
- No quería otra puntuación de appraisal
- Casi construimos demasiado
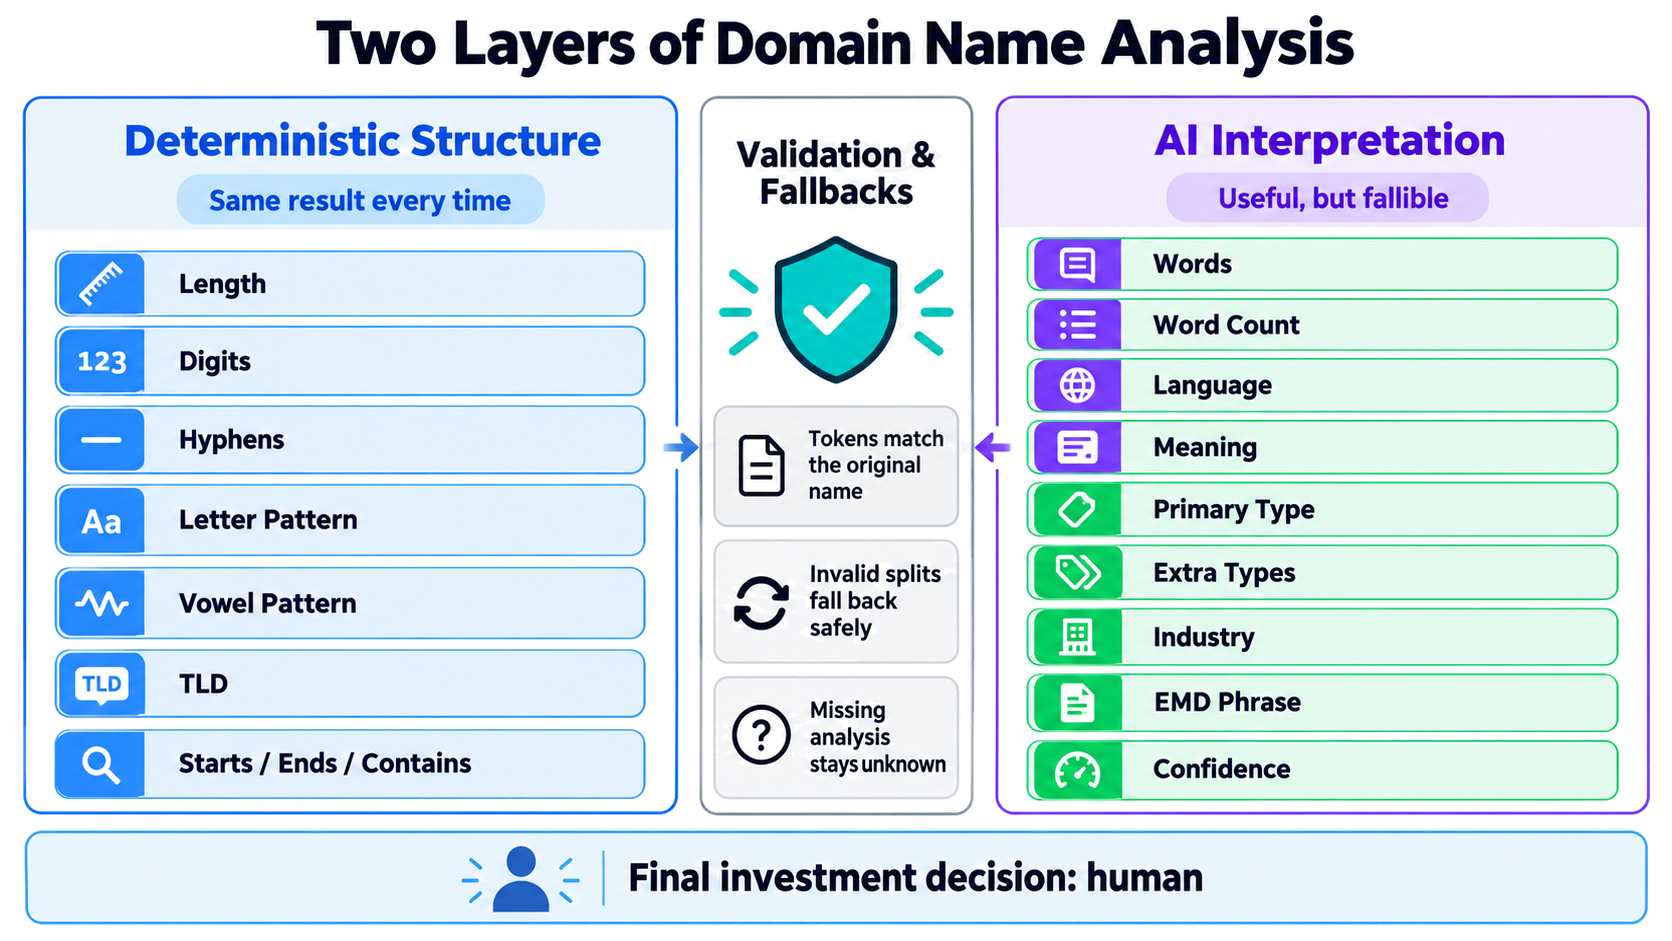
- La primera capa contiene hechos
- El recuento de palabras resultó ser un problema de IA
- La segunda capa interpreta el nombre
- El modelo era confiado con malas divisiones
- Nuestro conjunto de prueba empezó a halagarnos
- Los controles de producción importaron más que el prompt
- Cuatro formas en que usaría los nuevos filtros
- Cómo el informe apoya la decisión
- Los mismos campos funcionan fuera del navegador
- Dónde se detiene la automatización
Mientras revisaba listas de subastas y dominios expirados en Karma.Domains, me topaba una y otra vez con el mismo vacío. Nuestros informes podían contarme mucho sobre el pasado de un dominio: qué había antes en el sitio, qué temas aparecían en su archivo, si su perfil de backlinks mostraba un riesgo obvio y qué señales SEO estaban disponibles.
El informe decía mucho menos sobre el nombre en sí.
Esa distinción importa para quien invierte en dominios. Un nombre comercial limpio de dos palabras y una cadena torpe de fragmentos pueden sentarse uno al lado del otro con métricas de autoridad similares. Uno puede ser fácil de pronunciar, fácil de recordar y útil para varios tipos de compradores. El otro puede no tener ningún usuario final plausible.
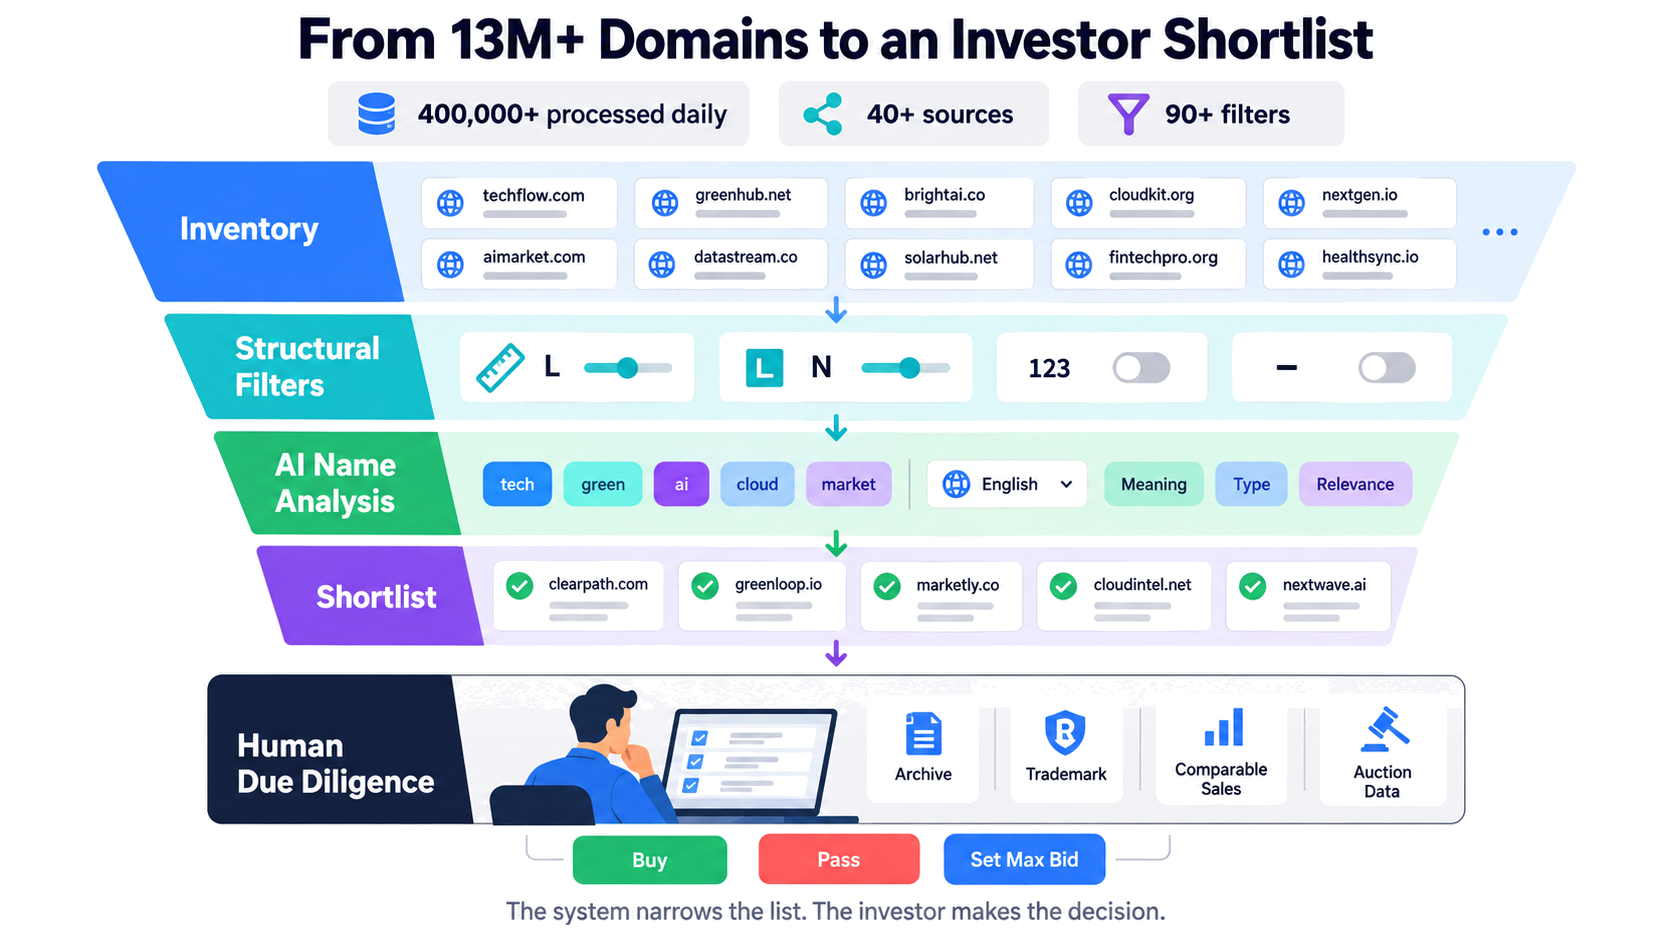
Cuando nuestra base superó los 13 millones de dominios expirados y en subasta, con más de 400.000 dominios procesados al día desde más de 40 fuentes, ese punto ciego se volvió más difícil de ignorar. Karma.Domains ya admitía más de 90 filtros y combinaba datos disponibles de Ahrefs, Semrush, Moz, Majestic, Similarweb, la Wayback Machine y otras fuentes. Se podía filtrar con detalle el historial y las señales SEO. Aun así había que leer miles de nombres uno por uno.
Así que construimos una nueva capa para la pregunta que toda domainer se hace primero: ¿vale la pena mirar este nombre con más detenimiento?
No quería otra puntuación de appraisal
La idea de producto obvia era un único número de «calidad de inversión». La rechacé pronto.
Un dominio no tiene valor universal fuera de un comprador, un mercado, un horizonte de venta y una estrategia. Quien se especializa en acrónimos cortos ve un activo distinto de quien construye un portafolio de dominios de servicios locales. Una frase natural en neerlandés puede parecer sin sentido para un modelo solo en inglés. Un nombre geo-service fuerte puede ser útil para generación de leads e irrelevante para un marketplace de brandables.
Una sola puntuación ocultaría esas suposiciones. Peor aún: haría que una salida subjetiva del modelo pareciera precisa.
Karma.Domains ya tiene un Brand Score, y lo mantuvimos separado. El nuevo análisis expone la evidencia por la que se puede filtrar: estructura, palabras, idioma, tipo de nombre, industria e posible intención exact-match. La estrategia la aporta la inversora o el inversor.
Mi opinión aquí es bastante firme: el appraisal es la abstracción equivocada para la etapa de discovery. El discovery debe reducir el montón y preservar las razones por las que un nombre sobrevivió.
Casi construimos demasiado
Nuestra primera visión de producto era mucho más grande. Incluía vistas específicas para inversores, proyectos, una inbox, un pipeline de deals, monitoreo y varias funciones más de workflow.
La mayoría de esas ideas pueden seguir siendo útiles. También eran una buena forma de pasar meses construyendo un producto aparte antes de demostrar que las inversoras y los inversores querían el análisis subyacente.
Recortamos el alcance. La primera versión debía vivir dentro de la experiencia de búsqueda e informe que la gente ya usaba. Añadir campos al registro de dominio existente, filtros a la lista existente y un desglose legible al informe existente. Los mismos datos también estarían disponibles mediante Public API y MCP.
Esa decisión dio forma a la función. Estábamos construyendo un mejor primer pase por el inventario, no un reemplazo del sistema de portafolio de una inversora.
La primera capa contiene hechos
Algunas propiedades de un nombre de dominio no necesitan un modelo de lenguaje.
Para el dominio de segundo nivel, Karma.Domains calcula:
- longitud en caracteres;
- recuento de dígitos y guiones;
- si hay dígitos o guiones;
- un patrón de letras;
- un patrón de vocales y consonantes;
- texto al principio, al final o en cualquier parte del nombre;
- el TLD.
El patrón de letras usa L para una letra, N para un número, H para un guion y X para otro carácter. El patrón de vocales usa V para una vocal, C para otra letra latina, más N, H y X.
Tomemos solar7.com como ejemplo sencillo. Su patrón de letras es LLLLLN. Su patrón de vocales es CVCVCN. Ningún modelo tiene que «entender» el nombre para producir cualquiera de esos resultados.
Los patrones son especialmente útiles cuando importa la forma del activo. Quien busca nombres de cuatro letras puede filtrar por LLLL. Quien investiga combinaciones pronunciables de cinco letras puede trabajar con patrones de vocales como CVCVC y luego aplicar un filtro de idioma o de tipo de nombre.
Estos campos son predecibles. Ejecuta el mismo filtro mañana y el resultado estructural no cambiará porque un modelo interpretó el nombre de otra forma.
El recuento de palabras resultó ser un problema de IA
El recuento de palabras suena como otro hecho. No lo es, al menos no para un dominio sin espacios.
Antes de decir que un nombre contiene dos palabras, hay que decidir dónde termina una y empieza la siguiente. Eightshapes probablemente significa «eight shapes». Una cadena que mezcla idiomas, un apellido y una abreviatura puede admitir varias divisiones razonables. Una marca inventada puede parecer dos fragmentos familiares aunque la lectura pretendida sea una sola palabra acuñada.
Por eso el filtro de recuento de palabras pertenece a la parte asistida por IA del sistema. Depende de la tokenización, y la tokenización depende del significado.
Esa pequeña constatación cambió la arquitectura. Dejamos de tratar como determinista todo campo que parecía numérico.
La segunda capa interpreta el nombre
El modelo recibe el nombre de dominio y el TLD. Al clasificar el nombre no ve métricas de backlinks, popularidad de subasta, estimaciones de tráfico ni KarmaScore. Queríamos que el resultado describiera la cadena, no que racionalizara señales de otras partes del informe.
El análisis intenta identificar:
- las palabras dentro del nombre;
- el idioma probable de cada palabra;
- un significado breve;
- un tipo principal, como dictionary word, descriptive phrase, personal name o brandable;
- tipos adicionales cuando apliquen, incluidos geographic, acronym y EMD;
- una o más industrias amplias;
- una frase comercial cuando el nombre parece un exact-match domain;
- un nivel general de confianza.
Usamos 17 categorías industriales amplias. Son deliberadamente gruesas. «Software» o «real estate» ayudan a estrechar una lista grande. Un modelo que inventa un plan de negocio extremadamente específico a partir de seis letras, no.
La misma contención se aplica a los tipos de nombre. Un tipo principal debe ser singular. Un nombre no puede ser a la vez una descriptive phrase clara y un brandable acuñado solo porque el modelo quiere cubrirse. Geographic, acronym y EMD funcionan como atributos adicionales porque responden a otras preguntas.
Sobre el papel, esto parecía sencillo. Las primeras pruebas no lo fueron.
El modelo era confiado con malas divisiones
El error más común era la segmentación de palabras.
Un modelo dejaba pegado un compuesto obvio como eightshapes. En otro nombre producía una división equivalente a cop + salive, aunque el segundo token no tenía sentido. Las cadenas multilingües causaban sus propios problemas. Un nombre como vuelostime invita a lecturas españolas e inglesas en competencia, y el modelo podía saltar entre ellas sin admitir la ambigüedad.
La detección de idioma creó otra clase de errores. Las primeras versiones inferían un idioma del TLD, trataban los caracteres latinos como evidencia de inglés o confundían un topónimo con un idioma. Los acrónimos a veces se expandían sin evidencia. Las etiquetas de industria se multiplicaban cuando una palabra tenía una asociación débil con varios mercados.
La clasificación EMD oscilaba en ambas direcciones. Un prompt estrecho perdía frases comerciales útiles. Uno más amplio empezó a llamar exact-match domain a casi cualquier combinación descriptiva.
Probamos varias familias de modelos. Algunas devolvían datos estructurados malformados o truncados. Los modelos más rápidos tendían a dispersar industrias sobre asociaciones débiles. Un modelo produjo un análisis lingüístico notablemente mejor en un lote de prueba, pero era demasiado lento y caro para el volumen que necesitábamos procesar.
Subir la temperatura no ayudó. Eran errores sistemáticos, no una falta de creatividad.
Un cambio sí mejoró los nombres difíciles: pedir al modelo que formara primero un significado general antes de cerrar la división en palabras. En thegeoffcapesfoundation, el contexto semántico ayudó a llegar a the / geoff / capes / foundation. No resolvió cada caso multilingüe o ambiguo, pero dio a la tokenización un mejor punto de partida.
Nuestro conjunto de prueba empezó a halagarnos
En un momento añadimos al prompt varios dominios difíciles y sus interpretaciones correctas como ejemplos. La siguiente evaluación se veía mucho mejor.
Demasiado mejor.
Estábamos probando una y otra vez algunos de los mismos dominios. Al prompt se le habían dado, de hecho, las respuestas. Podía reproducir esos casos sin aprender una regla transferible a inventario nuevo.
Quitamos los ejemplos específicos de dominio y los reescribimos como instrucciones generales. Las puntuaciones bajaron. Fue útil, porque el resultado más bajo era honesto.
Esta fue probablemente la lección de desarrollo más importante del proyecto. Un prompt puede parecer excelente cuando el conjunto de prueba se filtra dentro. Los nombres de dominio hacen que ese error sea fácil de pasar por alto, porque cada cadena problemática parece un caso especial que merece añadirse como ejemplo.
Después juzgamos los cambios sobre nombres no vistos, con especial atención a cadenas multilingües, compuestos largos, nombres personales, acrónimos y frases que se pueden segmentar de más de una forma.
Los controles de producción importaron más que el prompt
Seguimos mejorando el prompt, pero el trabajo sobre el prompt acabó en rendimientos decrecientes. Las salvaguardas de producción hicieron más por hacer fiable la función.
El backend comprueba que cada token pueda volver a unirse en el nombre original. El modelo no puede añadir una letra, eliminar un carácter ni «corregir» la ortografía en silencio. Si la división falla la validación, el sistema vuelve a una representación más segura.
El esquema permite un solo tipo primario, lo que evita respuestas contradictorias en ese campo. Un análisis ausente permanece unknown. No convertimos una clasificación sin procesar o fallida en un falso «no». En la interfaz, los filtros derivados de IA y el panel de clasificación llevan la advertencia de que el resultado puede ser inexacto.
Este enfoque acepta un hecho incómodo: algunos nombres son ambiguos y el modelo a veces se equivocará. Los controles impiden que una respuesta extraña se convierta en estructura corrupta o falsa certeza.
Una inversora aún puede encontrar un candidato pasado por alto con filtros vecinos. El sistema nunca debe hacer desaparecer una inferencia dudosa detrás de una puntuación confiada.
Cuatro formas en que usaría los nuevos filtros
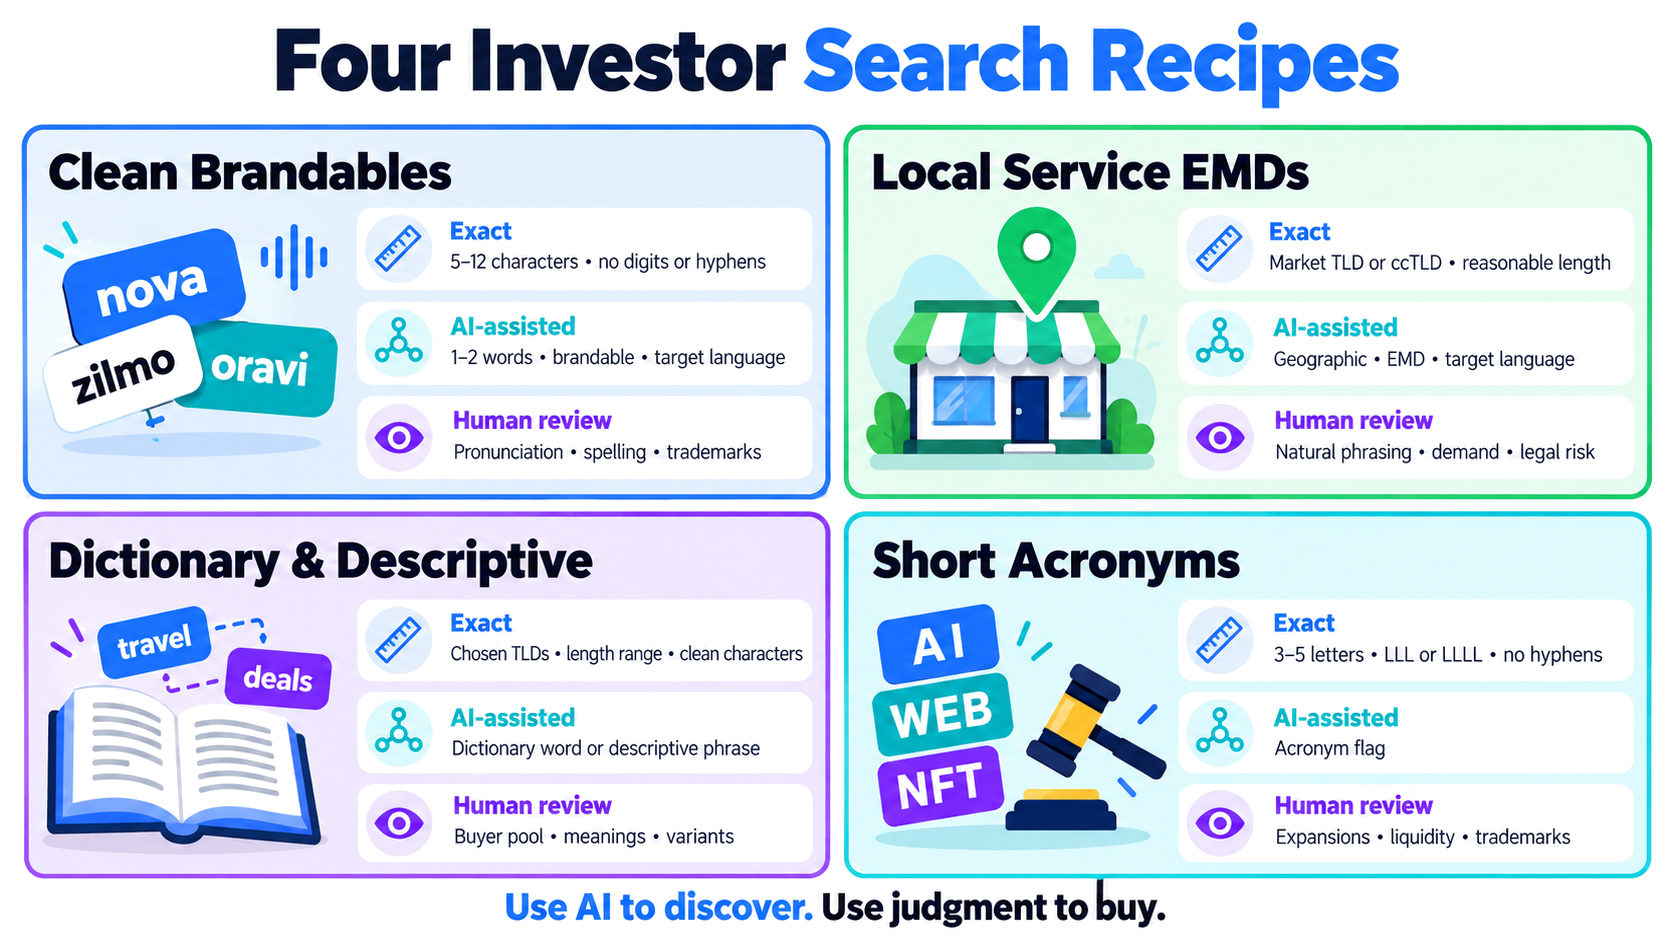
El valor práctico aparece cuando la estructura exacta y la clasificación semántica trabajan juntas. Aquí van cuatro recetas de partida. Los rangos son ejemplos, no reglas universales de compra.
| Estrategia | Filtros estructurales | Filtros asistidos por IA | Revisión manual |
|---|---|---|---|
| Brandables limpios | 5–12 caracteres, sin dígitos ni guiones, TLD seleccionados | Una o dos palabras, brandable, idioma objetivo, industria relevante | Pronunciación, ortografía, radio test, ventas comparables, marcas |
| EMD de servicios locales | TLD de mercado o ccTLD, longitud razonable, fragmento geo o de servicio requerido | Geographic, EMD, idioma objetivo, industria de servicio | Formulación natural, comportamiento de búsqueda real, demanda local, riesgo legal |
| Nombres de diccionario y descriptivos | TLD elegidos, rango de longitud, sin caracteres no deseados | Dictionary word o descriptive phrase, idioma, industria | Pool de compradores, significados alternativos, forma plural, variantes ortográficas |
| Acrónimos cortos | Tres a cinco letras, patrones como LLL o LLLL, sin guiones | Indicador acronym y contexto lingüístico cuando esté disponible | Expansiones plausibles, organizaciones existentes, liquidez, marcas |
Brandables limpios
Empezaría por lo que el modelo no puede leer mal: TLD, longitud, dígitos, guiones y patrón. Luego añadiría una o dos restricciones semánticas, como brandable más software.
Si la lista se vuelve demasiado pequeña, afloja primero el campo semántico antes que las reglas estructurales que definen la estrategia. Una industria mal etiquetada puede ocultar un buen nombre. Un dominio de 19 caracteres no se convierte en un brandable de seis letras porque al clasificador le guste.
Nombres de servicios locales
Las combinaciones geo-service se benefician más de los filtros semánticos porque importan el orden y el idioma de la frase. Busca las banderas geographic y EMD, y luego revisa la tokenización y el significado reales del informe.
Un modelo puede reconocer que hay una ciudad y un servicio. No puede decirte si una clienta local diría la frase de forma natural, si la demanda de búsqueda es comercialmente útil o si el mercado ya está saturado.
Palabras de diccionario y frases descriptivas
El idioma es aquí un filtro de discovery útil, sobre todo entre ccTLD. También merece escepticismo. Las palabras cortas pueden existir en varios idiomas, y los nombres propios a menudo se parecen a palabras de diccionario.
Antes de aceptar el tipo, inspeccionaría el desglose de palabras en color del informe. La división visual hace más fácil atrapar una interpretación dudosa que una etiqueta suelta en una tabla.
Acrónimos
El pase estructural hace la mayor parte del trabajo con acrónimos cortos. La bandera de IA ayuda a separar iniciales probables de palabras cortas ordinarias, pero no conoce cada organización, producto o abreviatura de nicho.
Para esta estrategia, los falsos positivos son baratos. Los errores de marca no lo son. Mantén el umbral de IA amplio y las comprobaciones legales y de usuario final estrictas.
Cómo el informe apoya la decisión
La pestaña Domain name de un informe de Karma.Domains muestra ambas capas por separado.
La sección Structure contiene las mediciones: longitud, dígitos, guiones, patrón de letras y patrón de vocales. La sección Classification muestra la división de palabras propuesta, el significado, el tipo, los idiomas, las industrias, la frase EMD, el recuento de palabras y la confianza.
También usamos la división validada para mostrar una versión CamelCase legible del dominio. Al copiar el nombre sigues obteniendo el dominio original en minúsculas. La versión formateada está para facilitar el escaneo de una lista, no para alterar el activo.
Brand Score aparece en la misma zona por comodidad, pero sigue siendo su propia señal. El análisis del nombre no lo absorbe en un nuevo número maestro.
Si solo revisas unas pocas docenas de dominios al mes, gran parte de esto puede ser innecesario. Puedes leer los nombres tú misma. Los filtros se vuelven útiles cuando la lista en bruto contiene miles de candidatos o cuando varias personas deben aplicar la misma tesis de portafolio de forma coherente.
Los mismos campos funcionan fuera del navegador
Integramos la función en la capa de búsqueda existente, así que los campos de nombre están disponibles a través de la interfaz web, la Public API de Karma.Domains y el servidor MCP de Karma.Domains.
En la app web, una inversora puede combinar los nuevos campos con fuente de subasta, precio actual, hora de fin, TLD, historial y filtros SEO.
La API admite búsquedas repetibles dentro de un dashboard privado, un pipeline de hojas de cálculo o un workflow de portafolio. Se puede guardar una tesis como parámetros de consulta y ejecutarla contra inventario nuevo sin reconstruir la pantalla cada vez.
MCP expone la misma búsqueda a ChatGPT, Claude y otros asistentes compatibles. Una petición puede ser conversacional:
Encuentra nombres
.comcortos en subasta, sin dígitos ni guiones. Quédate con nombres ingleses de una o dos palabras clasificados como brandable en software o finance. Muestra el desglose del nombre y los detalles de la subasta.
El siguiente mensaje puede ajustar la tesis:
Mantén las reglas estructurales, quita finance e incluye descriptive phrases de menos de diez caracteres.
El lenguaje natural facilita la iteración. Los filtros subyacentes siguen haciendo la búsqueda real.
Dónde se detiene la automatización
El análisis del nombre no estima un precio de venta, no predice una tasa de sell-through ni aprueba una compra. No sustituye la investigación de marcas, el juicio de una hablante nativa, el análisis de ventas comparables ni una mirada atenta al archivo y al perfil de backlinks.
Tampoco puede conocer tu coste de mantenimiento, tus marketplaces preferidos, tu tolerancia a la iliquidez o tu acceso a compradores probables. Esas variables a menudo importan más que una señal extra en un informe.
Mi workflow preferido es sencillo. Usa filtros deterministas para definir la forma del activo. Añade campos de IA para explorar significado y contexto comercial. Abre los informes del pequeño grupo que sobrevive. Luego comprueba historial, enlaces, riesgo legal, ventas comparables y condiciones actuales de subasta antes de pujar.
La función gana su lugar cuando convierte 10.000 nombres en 40 que merecen leerse. Elegir los cuatro que merecen comprarse sigue siendo el trabajo de la inversora.