
Dua domain bisa punya metrik SEO serupa tetapi potensi investasi yang sama sekali berbeda. Kami membangun analisis nama domain di Karma.Domains untuk membantu investor memisahkan kasus-kasus itu sebelum bagian due diligence yang mahal dan manual dimulai.
Daftar Isi
- Daftar Isi
- Saya tidak ingin skor appraisal lagi
- Kami hampir membangun terlalu banyak
- Lapisan pertama berisi fakta
- Jumlah kata ternyata masalah AI
- Lapisan kedua menafsirkan nama
- Model percaya diri soal pemisahan yang buruk
- Set uji kami mulai menjilat kami
- Kontrol produksi lebih penting daripada prompt
- Empat cara saya akan memakai filter baru
- Bagaimana laporan mendukung keputusan
- Field yang sama bekerja di luar browser
- Di mana otomatisasi berhenti
Saat meninjau daftar lelang dan domain kedaluwarsa di Karma.Domains, saya terus menemui celah yang sama. Laporan kami bisa memberi tahu banyak tentang masa lalu sebuah domain: apa yang dulu ada di situsnya, topik apa yang muncul di arsipnya, apakah profil backlink menunjukkan risiko jelas, dan sinyal SEO mana yang tersedia.
Laporan itu jauh lebih sedikit berbicara tentang namanya sendiri.
Perbedaan itu penting bagi investor domain. Nama komersial dua kata yang bersih dan rangkaian fragmen yang canggung bisa berdampingan dengan metrik otoritas yang mirip. Yang satu mungkin mudah diucapkan, mudah diingat, dan berguna bagi beberapa jenis pembeli. Yang lain mungkin sama sekali tidak punya pengguna akhir yang masuk akal.
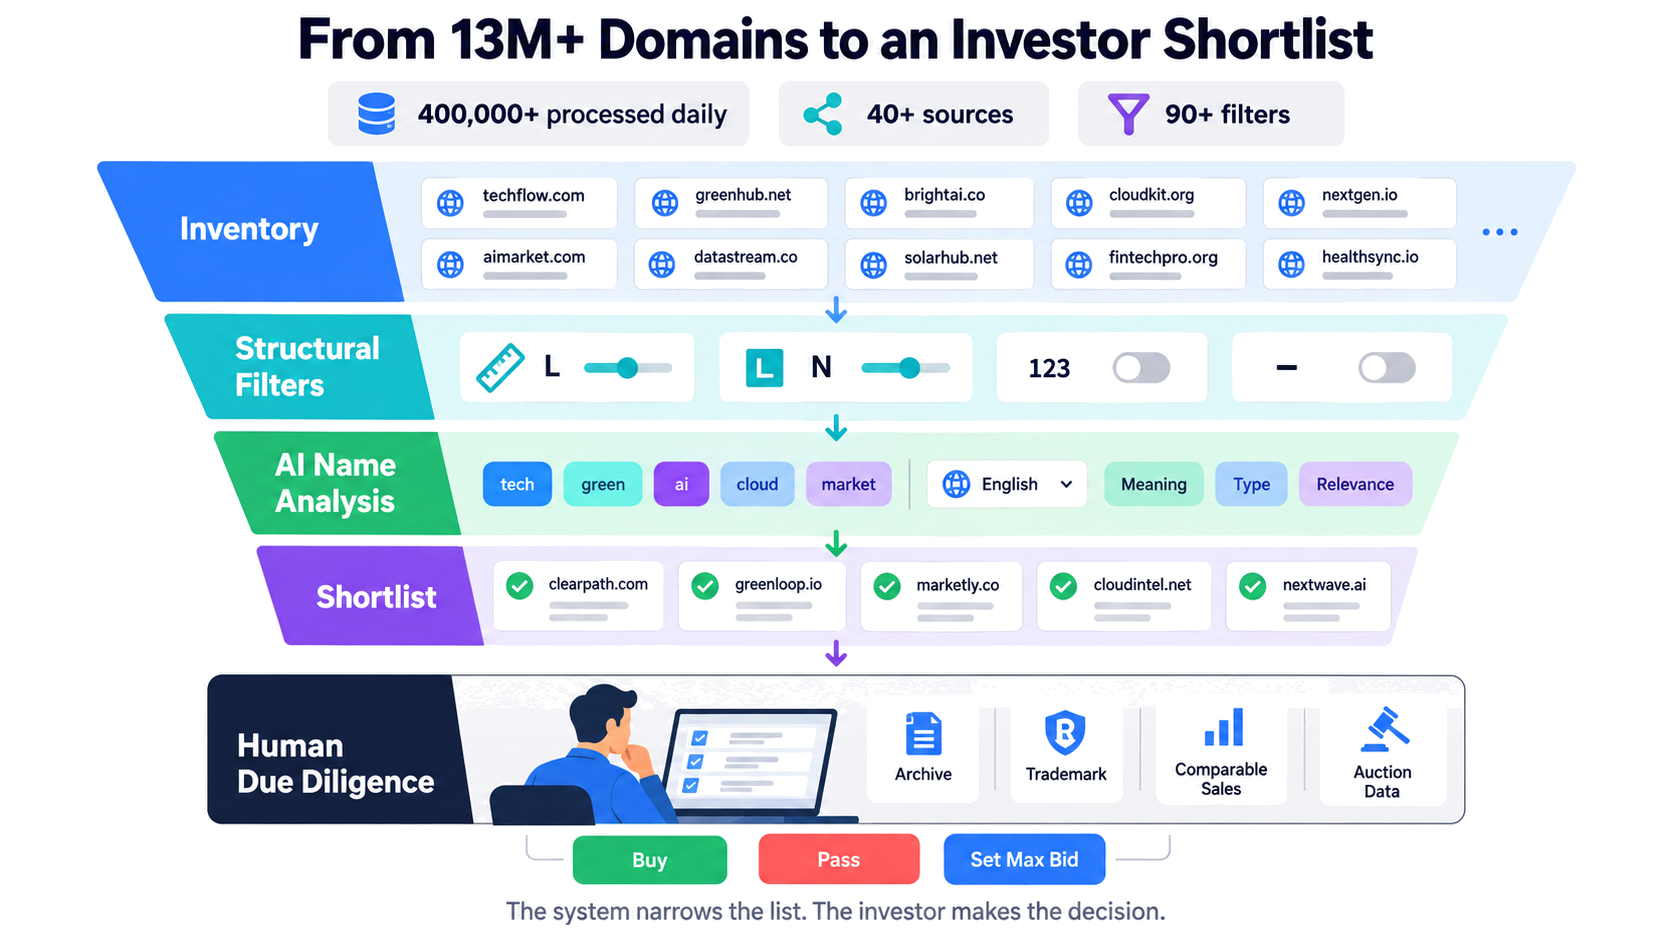
Ketika basis data kami melewati 13 juta domain kedaluwarsa dan lelang, dengan lebih dari 400.000 domain diproses setiap hari dari 40+ sumber, titik buta itu semakin sulit diabaikan. Karma.Domains sudah mendukung 90+ filter dan menggabungkan data yang tersedia dari Ahrefs, Semrush, Moz, Majestic, Similarweb, Wayback Machine, dan sumber lain. Investor bisa menyaring riwayat dan sinyal SEO secara detail. Mereka tetap harus membaca ribuan nama satu per satu.
Jadi kami membangun lapisan baru untuk pertanyaan yang diajukan setiap domainer terlebih dulu: apakah namanya layak dilihat lebih dekat?
Saya tidak ingin skor appraisal lagi
Ide produk yang paling jelas adalah satu angka «kualitas investasi». Saya menolaknya sejak awal.
Domain tidak punya nilai universal di luar pembeli, pasar, horizon penjualan, dan strategi. Investor yang spesialisasi pada akronim pendek melihat aset berbeda dari seseorang yang membangun portofolio domain layanan lokal. Frasa alami dalam bahasa Belanda bisa tampak tak berarti bagi model yang hanya berbahasa Inggris. Nama geo-service yang kuat bisa berguna bagi operator lead generation dan tidak relevan bagi marketplace brandable.
Satu skor akan menyembunyikan asumsi-asumsi itu. Lebih buruk lagi: itu akan membuat keluaran model yang subjektif tampak presisi.
Karma.Domains sudah punya Brand Score, dan kami mempertahankannya terpisah. Analisis baru mengekspos bukti yang mungkin ingin difilter investor: struktur, kata, bahasa, tipe nama, industri, dan kemungkinan niat exact-match. Strateginya disediakan investor.
Pendapat saya di sini cukup kuat: appraisal adalah abstraksi yang salah untuk tahap discovery. Discovery harus mengurangi tumpukan sambil mempertahankan alasan mengapa sebuah nama bertahan.
Kami hampir membangun terlalu banyak
Visi produk pertama kami jauh lebih besar. Termasuk tampilan khusus investor, proyek, inbox, pipeline deal, monitoring, dan beberapa fitur workflow lain.
Sebagian besar ide itu mungkin masih berguna. Ide-ide itu juga cara yang baik untuk menghabiskan berbulan-bulan membangun produk terpisah sebelum membuktikan bahwa investor menginginkan analisis dasarnya.
Kami memangkas ruang lingkup. Rilis pertama harus hidup di dalam pengalaman pencarian dan laporan yang sudah dipakai orang. Menambahkan field ke rekaman domain yang ada, filter ke daftar yang ada, dan uraian yang mudah dibaca ke laporan yang ada. Data yang sama juga tersedia melalui Public API dan MCP.
Keputusan itu membentuk fiturnya. Kami membangun pass pertama yang lebih baik melalui inventaris, bukan pengganti sistem portofolio investor.
Lapisan pertama berisi fakta
Beberapa properti nama domain tidak membutuhkan model bahasa.
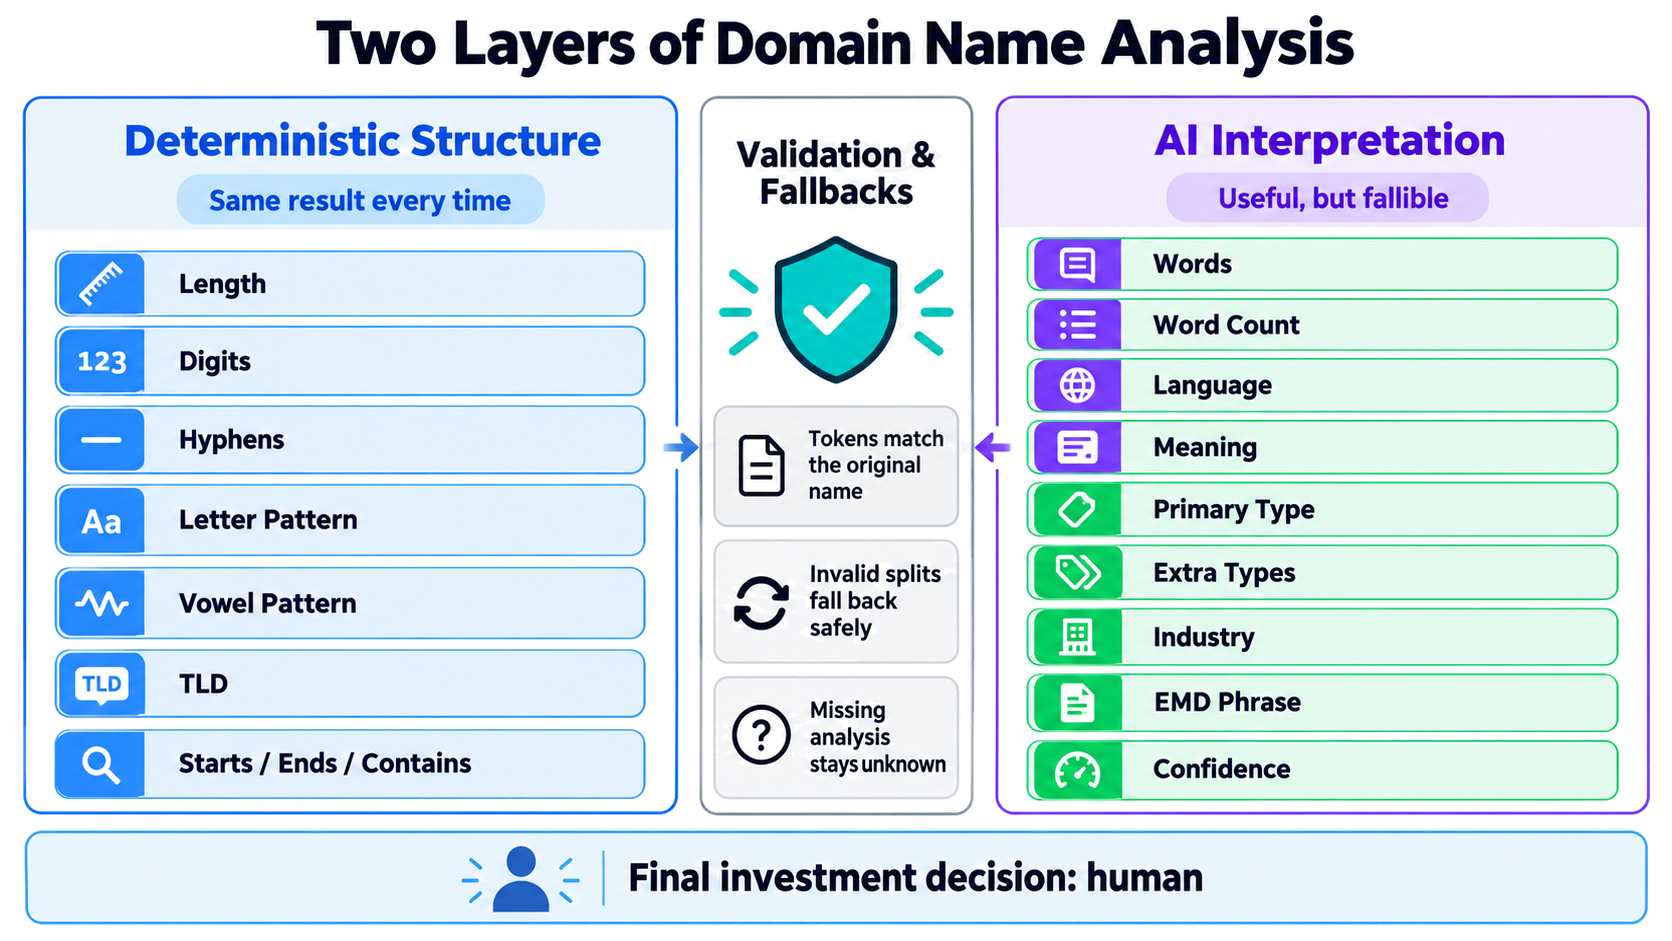
Untuk second-level domain, Karma.Domains menghitung:
- panjang karakter;
- jumlah digit dan tanda hubung;
- apakah ada digit atau tanda hubung;
- pola huruf;
- pola vokal dan konsonan;
- teks di awal, akhir, atau di mana saja dalam nama;
- TLD.
Pola huruf memakai L untuk huruf, N untuk angka, H untuk tanda hubung, dan X untuk karakter lain. Pola vokal memakai V untuk vokal, C untuk huruf Latin lain, plus N, H, dan X.
Ambil solar7.com sebagai contoh sederhana. Pola hurufnya LLLLLN. Pola vokalnya CVCVCN. Tidak ada model yang harus «memahami» nama untuk menghasilkan salah satu hasil itu.
Pola sangat berguna ketika bentuk aset penting. Investor yang mencari nama empat huruf bisa memfilter LLLL. Seseorang yang meneliti kombinasi lima huruf yang mudah diucapkan bisa bekerja dengan pola vokal seperti CVCVC, lalu menerapkan filter bahasa atau tipe nama.
Field ini dapat diprediksi. Jalankan filter yang sama besok dan hasil struktural tidak akan berubah karena model menafsirkan nama secara berbeda.
Jumlah kata ternyata masalah AI
Jumlah kata terdengar seperti fakta lain. Bukan — setidaknya tidak untuk domain tanpa spasi.
Sebelum kita bisa bilang sebuah nama berisi dua kata, kita harus memutuskan di mana satu kata berakhir dan yang berikutnya dimulai. Eightshapes kemungkinan berarti «eight shapes». String yang mencampur bahasa, nama keluarga, dan singkatan bisa mendukung beberapa pemisahan yang masuk akal. Merek yang dibuat-buat bisa tampak seperti dua fragmen yang dikenal meski bacaan yang dimaksud adalah satu kata ciptaan.
Itulah mengapa filter jumlah kata termasuk bagian sistem yang dibantu AI. Bergantung pada tokenisasi, dan tokenisasi bergantung pada makna.
Kesadaran kecil itu mengubah arsitektur. Kami berhenti memperlakukan setiap field yang tampak numerik sebagai deterministik.
Lapisan kedua menafsirkan nama
Model menerima nama domain dan TLD. Saat mengklasifikasi nama, model tidak melihat metrik backlink, popularitas lelang, estimasi trafik, atau KarmaScore. Kami ingin hasilnya menggambarkan string, bukan merasionalisasi sinyal dari bagian lain laporan.
Analisis mencoba mengidentifikasi:
- kata-kata di dalam nama;
- bahasa yang mungkin untuk setiap kata;
- makna singkat;
- satu tipe utama, seperti dictionary word, descriptive phrase, personal name, atau brandable;
- tipe tambahan jika relevan, termasuk geographic, acronym, dan EMD;
- satu atau lebih industri luas;
- frasa komersial ketika nama tampak sebagai exact-match domain;
- tingkat kepercayaan keseluruhan.
Kami memakai 17 kategori industri luas. Sengaja kasar. «Software» atau «real estate» bisa membantu mempersempit daftar besar. Model yang menciptakan rencana bisnis sangat spesifik dari enam huruf, tidak.
Penahanan yang sama berlaku untuk tipe nama. Tipe utama harus tunggal. Nama tidak bisa sekaligus descriptive phrase yang jelas dan brandable ciptaan hanya karena model ingin berhati-hati. Geographic, acronym, dan EMD bekerja sebagai atribut tambahan karena menjawab pertanyaan berbeda.
Di atas kertas, ini tampak sederhana. Tes pertama tidak demikian.
Model percaya diri soal pemisahan yang buruk
Kesalahan paling umum adalah segmentasi kata.
Model bisa membiarkan compound yang jelas seperti eightshapes tetap menempel. Pada nama lain, menghasilkan pemisahan setara cop + salive, meski token kedua tidak masuk akal. String multibahasa menimbulkan masalah sendiri. Nama seperti vuelostime mengundang bacaan Spanyol dan Inggris yang bersaing, dan model bisa melompat di antara keduanya tanpa mengakui ambiguitas.
Deteksi bahasa menciptakan kelas kesalahan lain. Versi awal menyimpulkan bahasa dari TLD, memperlakukan karakter Latin sebagai bukti bahasa Inggris, atau mengacaukan nama tempat dengan bahasa. Akronim kadang diperluas tanpa bukti. Label industri bertambah ketika sebuah kata punya asosiasi lemah dengan beberapa pasar.
Klasifikasi EMD berayun ke kedua arah. Prompt sempit melewatkan frasa komersial yang berguna. Prompt lebih luas mulai menyebut hampir setiap kombinasi deskriptif sebagai exact-match domain.
Kami mencoba beberapa keluarga model. Beberapa mengembalikan data terstruktur yang rusak atau terpotong. Model lebih cepat cenderung menyebar industri lewat asosiasi lemah. Satu model menghasilkan analisis linguistik yang jelas lebih baik pada batch uji, tetapi terlalu lambat dan mahal untuk volume yang perlu kami proses.
Menaikkan temperature tidak membantu. Itu kesalahan sistematis, bukan kekurangan kreativitas.
Satu perubahan memang memperbaiki nama sulit: meminta model membentuk makna umum dulu sebelum menyelesaikan pemisahan kata. Pada thegeoffcapesfoundation, konteks semantik membantu sampai ke the / geoff / capes / foundation. Itu belum menyelesaikan setiap kasus multibahasa atau ambigu, tetapi memberi titik awal tokenisasi yang lebih baik.
Set uji kami mulai menjilat kami
Pada satu titik, kami menambahkan beberapa domain sulit dan interpretasi yang benar ke dalam prompt sebagai contoh. Evaluasi berikutnya tampak jauh lebih baik.
Terlalu jauh lebih baik.
Kami berulang kali menguji beberapa domain yang sama. Prompt pada dasarnya sudah diberi jawaban. Ia bisa mereproduksi kasus itu tanpa mempelajari aturan yang bisa ditransfer ke inventaris baru.
Kami menghapus contoh khusus domain dan menulis ulang sebagai instruksi umum. Skor turun. Itu berguna karena hasil yang lebih rendah jujur.
Ini mungkin pelajaran pengembangan paling penting dalam proyek. Prompt bisa tampak sangat baik ketika set uji bocor ke dalamnya. Nama domain membuat kesalahan itu mudah terlewat karena setiap string bermasalah terasa seperti kasus khusus yang layak ditambahkan sebagai contoh.
Setelah itu, kami menilai perubahan pada nama yang belum pernah dilihat, dengan perhatian ekstra pada string multibahasa, compound panjang, nama pribadi, akronim, dan frasa yang bisa disegmentasi lebih dari satu cara.
Kontrol produksi lebih penting daripada prompt
Kami terus memperbaiki prompt, tetapi kerja prompt akhirnya menemui hasil yang menurun. Pengaman produksi lebih banyak membuat fitur ini bisa dipercaya.
Backend memeriksa bahwa setiap token bisa digabung kembali menjadi nama asli. Model tidak bisa menambah huruf, menghapus karakter, atau diam-diam «mengoreksi» ejaan. Jika pemisahan gagal validasi, sistem kembali ke representasi yang lebih aman.
Skema hanya mengizinkan satu tipe utama, yang mencegah jawaban bertentangan di field itu. Analisis yang hilang tetap unknown. Kami tidak mengubah klasifikasi yang belum diproses atau gagal menjadi «no» palsu. Di antarmuka, filter turunan AI dan panel klasifikasi membawa peringatan bahwa hasilnya mungkin tidak akurat.
Pendekatan ini menerima fakta yang tidak nyaman: beberapa nama ambigu, dan model kadang salah. Kontrol menjaga jawaban aneh agar tidak menjadi struktur rusak atau kepastian palsu.
Investor masih bisa menemukan kandidat yang terlewat dengan mencoba filter tetangga. Sistem tidak boleh membuat inferensi meragukan hilang di balik skor yang percaya diri.
Empat cara saya akan memakai filter baru
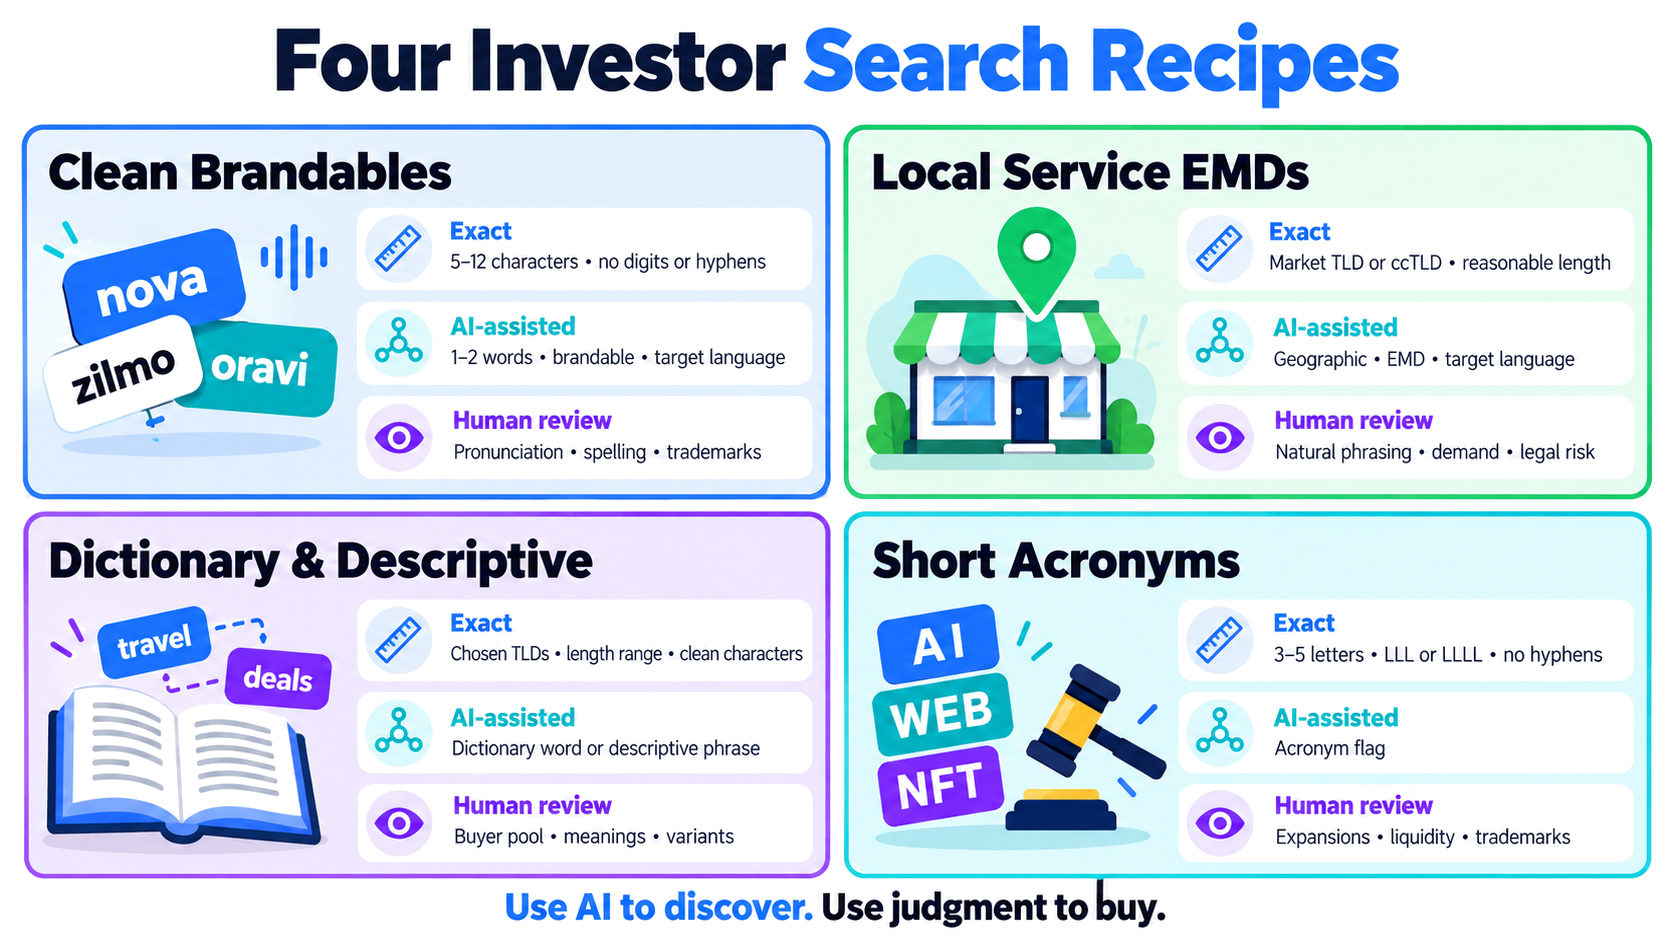
Nilai praktis muncul ketika struktur eksak dan klasifikasi semantik bekerja bersama. Berikut empat resep awal. Rentangnya contoh, bukan aturan beli universal.
| Strategi | Filter struktural | Filter berbantuan AI | Tinjauan manual |
|---|---|---|---|
| Brandable bersih | 5–12 karakter, tanpa digit atau tanda hubung, TLD terpilih | Satu atau dua kata, brandable, bahasa target, industri relevan | Pengucapan, ejaan, radio test, penjualan sebanding, merek dagang |
| EMD layanan lokal | TLD pasar atau ccTLD, panjang wajar, fragmen geo atau layanan yang diperlukan | Geographic, EMD, bahasa target, industri layanan | Frasa alami, perilaku pencarian nyata, permintaan lokal, risiko hukum |
| Nama kamus dan deskriptif | TLD pilihan, rentang panjang, tanpa karakter tak diinginkan | Dictionary word atau descriptive phrase, bahasa, industri | Kumpulan pembeli, makna alternatif, bentuk jamak, varian ejaan |
| Akronim pendek | Tiga sampai lima huruf, pola seperti LLL atau LLLL, tanpa tanda hubung | Flag acronym dan konteks bahasa jika tersedia | Perluasan yang masuk akal, organisasi yang ada, likuiditas, merek dagang |
Brandable bersih
Saya akan mulai dari yang tidak bisa dibaca salah oleh model: TLD, panjang, digit, tanda hubung, dan pola. Lalu saya akan menambahkan satu atau dua batasan semantik, misalnya brandable plus software.
Jika daftar terlalu kecil, longgarkan field semantik dulu sebelum aturan struktural yang mendefinisikan strategi. Industri yang salah dilabel bisa menyembunyikan nama bagus. Domain 19 karakter tidak menjadi brandable enam huruf hanya karena classifier menyukainya.
Nama layanan lokal
Kombinasi geo-service lebih diuntungkan filter semantik karena urutan dan bahasa frasa penting. Cari flag geographic dan EMD, lalu tinjau tokenisasi dan makna aktual di laporan.
Model bisa mengenali bahwa kota dan layanan ada. Model tidak bisa memberi tahu apakah pelanggan lokal akan mengucapkan frasa itu secara alami, apakah permintaan pencarian berguna secara komersial, atau apakah pasar sudah jenuh.
Kata kamus dan frasa deskriptif
Bahasa adalah filter discovery yang berguna di sini, terutama lintas ccTLD. Bahasa juga pantas disikapi skeptis. Kata pendek bisa ada di beberapa bahasa, dan nama diri sering menyerupai kata kamus.
Sebelum menerima tipenya, saya akan memeriksa uraian kata berwarna di laporan. Pemisahan visual membuat interpretasi meragukan lebih mudah ditangkap daripada label kosong di tabel.
Akronim
Pass struktural melakukan sebagian besar kerja untuk akronim pendek. Flag AI membantu memisahkan inisial yang mungkin dari kata pendek biasa, tetapi tidak mengenal setiap organisasi, produk, atau singkatan niche.
Untuk strategi ini, false positive murah. Kesalahan merek dagang tidak. Jaga ambang AI tetap luas dan pemeriksaan hukum serta pengguna akhir tetap ketat.
Bagaimana laporan mendukung keputusan
Tab Domain name di laporan Karma.Domains menampilkan kedua lapisan secara terpisah.
Bagian Structure berisi pengukuran: panjang, digit, tanda hubung, pola huruf, dan pola vokal. Bagian Classification menampilkan usulan pemisahan kata, makna, tipe, bahasa, industri, frasa EMD, jumlah kata, dan kepercayaan.
Kami juga memakai pemisahan kata yang tervalidasi untuk menampilkan versi CamelCase yang mudah dibaca. Menyalin nama tetap memberi domain lowercase asli. Versi terformat ada agar daftar lebih mudah dipindai, bukan untuk mengubah aset.
Brand Score muncul di area yang sama demi kenyamanan, tetapi tetap sinyalnya sendiri. Analisis nama tidak menyerapnya ke dalam angka master baru.
Jika Anda hanya meninjau beberapa puluh domain per bulan, banyak dari ini mungkin tidak diperlukan. Anda bisa membaca namanya sendiri. Filter menjadi berguna ketika daftar mentah berisi ribuan kandidat atau ketika beberapa orang harus menerapkan tesis portofolio yang sama secara konsisten.
Field yang sama bekerja di luar browser
Kami membangun fitur ke dalam lapisan pencarian yang ada, jadi field nama tersedia lewat antarmuka web, Public API Karma.Domains, dan server MCP Karma.Domains.
Di aplikasi web, investor bisa menggabungkan field baru dengan sumber lelang, harga saat ini, waktu berakhir, TLD, riwayat, dan filter SEO.
API mendukung pencarian yang dapat diulang di dalam dashboard pribadi, pipeline spreadsheet, atau workflow portofolio. Investor bisa menyimpan tesis sebagai parameter query dan menjalankannya terhadap inventaris baru tanpa menyusun ulang layar setiap kali.
MCP mengekspos pencarian yang sama ke ChatGPT, Claude, dan asisten kompatibel lainnya. Permintaan bisa bersifat percakapan:
Temukan nama lelang
.compendek tanpa digit atau tanda hubung. Pertahankan nama Inggris satu atau dua kata yang diklasifikasi sebagai brandable di software atau finance. Tampilkan uraian nama dan detail lelang.
Pesan berikutnya bisa menyesuaikan tesis:
Pertahankan aturan struktural, hapus finance, dan sertakan descriptive phrase di bawah sepuluh karakter.
Bahasa alami membuat iterasi lebih mudah. Filter di bawahnya tetap melakukan pencarian yang sebenarnya.
Di mana otomatisasi berhenti
Analisis nama tidak memperkirakan harga jual, tidak memprediksi sell-through rate, dan tidak menyetujui pembelian. Tidak menggantikan riset merek dagang, penilaian penutur asli, analisis penjualan sebanding, atau tinjauan dekat pada arsip dan profil backlink.
Analisis juga tidak bisa mengetahui biaya holding Anda, marketplace pilihan, toleransi terhadap illiquiditas, atau akses ke pembeli yang mungkin. Variabel itu sering lebih penting daripada satu sinyal tambahan di laporan.
Workflow yang saya sukai sederhana. Gunakan filter deterministik untuk mendefinisikan bentuk aset. Tambahkan field AI untuk mengeksplorasi makna dan konteks komersial. Buka laporan untuk kelompok kecil yang bertahan. Lalu periksa riwayat, tautan, risiko hukum, penjualan sebanding, dan kondisi lelang saat ini sebelum memasang bid.
Fitur ini pantas ada ketika mengubah 10.000 nama menjadi 40 yang layak dibaca. Memilih empat yang layak dibeli tetap pekerjaan investor.