
两个域名可能有相近的 SEO 指标,却有完全不同的投资潜力。我们做了 Karma.Domains 的域名名称分析,帮助投资者在昂贵的人工尽职调查开始前把这类情况分开。
目录
- 目录
- 我不想再要一个 appraisal 分数
- 我们差点做得太多
- 第一层是事实
- 词数结果变成了 AI 问题
- 第二层解释名称
- 模型对糟糕切分很自信
- 测试集开始讨好我们
- 生产控制比提示更重要
- 我会这样用新过滤器的四种方式
- 报告如何支持决策
- 同样的字段也能在浏览器外使用
- 自动化止步之处
在 Karma.Domains 里翻看拍卖和过期域名列表时,我一再碰到同一个缺口。我们的报告能告诉我很多关于域名过去的信息:网站上曾经有什么、归档里出现过哪些主题、外链画像是否有明显风险,以及有哪些 SEO 信号可用。
关于名称本身,报告说得少得多。
对域名投资者来说,这个区别很重要。一个干净的两词商业名,和一个别扭的碎片拼接,可能并排出现,权威指标却差不多。前者可能好念、好记,对多种买家有用;后者可能根本没有说得通的最终用户。
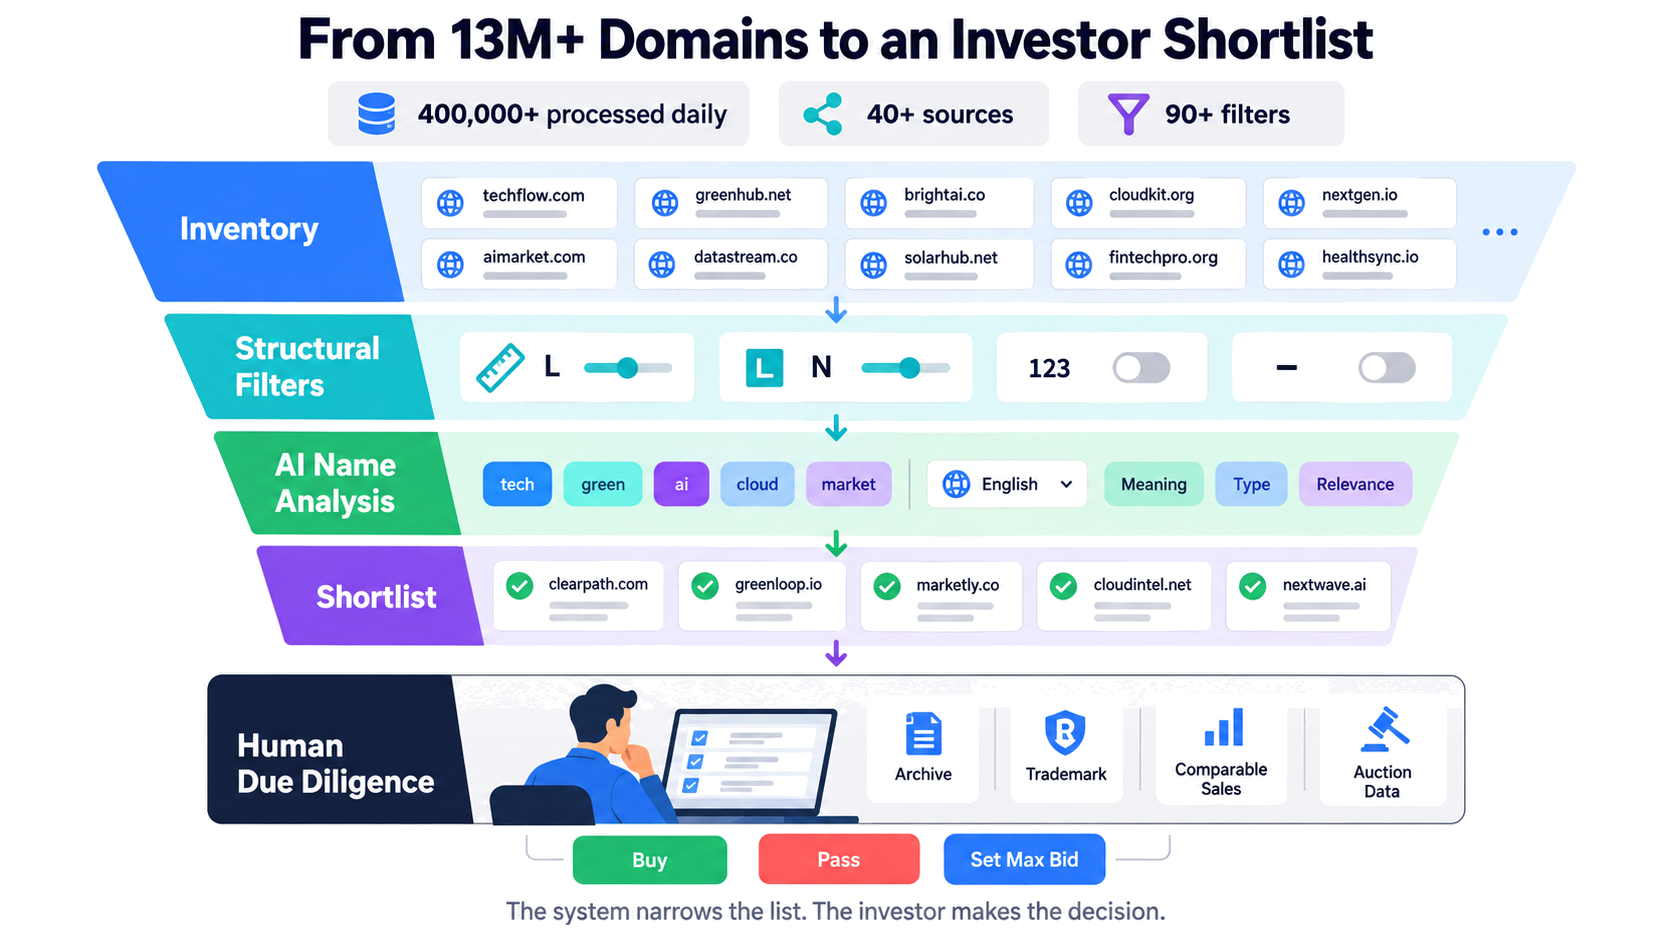
当我们的数据库超过 1300 万个过期与拍卖域名,每天从 40 多个来源处理超过 40 万个域名时,这个盲点更难忽视。Karma.Domains 已支持 90 多个过滤器,并整合 Ahrefs、Semrush、Moz、Majestic、Similarweb、Wayback Machine 等来源的可用数据。投资者可以细致筛选历史和 SEO 信号,但仍得一个个阅读成千上万个名字。
于是我们为每个 domainer 最先会问的问题建了一层新能力:这个名字值不值得再看一眼?
我不想再要一个 appraisal 分数
最显眼的产品想法是一个「投资质量」数字。我很早就否决了它。
域名没有脱离买家、市场、出售周期和策略的普适价值。专做短缩写的投资者,看到的资产不同于搭建本地服务域名组合的人。一句自然的荷兰语短语,对只懂英语的模型可能毫无意义。一个强的 geo-service 名称对获客运营有用,对 brandable 市场却可能无关。
单一分数会掩盖这些前提。更糟的是,它会让主观模型输出看起来像精确结果。
Karma.Domains 已有 Brand Score,我们把它保持独立。新分析暴露投资者可能想用来筛选的证据:结构、词语、语言、名称类型、行业,以及可能的 exact-match 意图。策略由投资者自己提供。
我在这里的看法相当明确:appraisal 不是 discovery 阶段该用的抽象。Discovery 应缩小候选堆,同时保留名称留下来的理由。
我们差点做得太多
我们最初的产品愿景大得多,包括面向投资者的视图、项目、收件箱、交易管道、监控,以及更多 workflow 功能。
这些想法大多仍可能有用。但它们也很容易让人花几个月做另一套产品,却还没证明投资者想要底层分析本身。
我们收缩了范围。首发版本要活在人们已经在用的搜索与报告体验里:给现有域名记录加字段,给现有列表加过滤器,给现有报告加可读拆解。同样的数据也通过 Public API 和 MCP 提供。
这个决定塑造了功能形态。我们在做更好的库存初筛,而不是替代投资者的组合管理系统。
第一层是事实
域名名称的一些属性不需要语言模型。
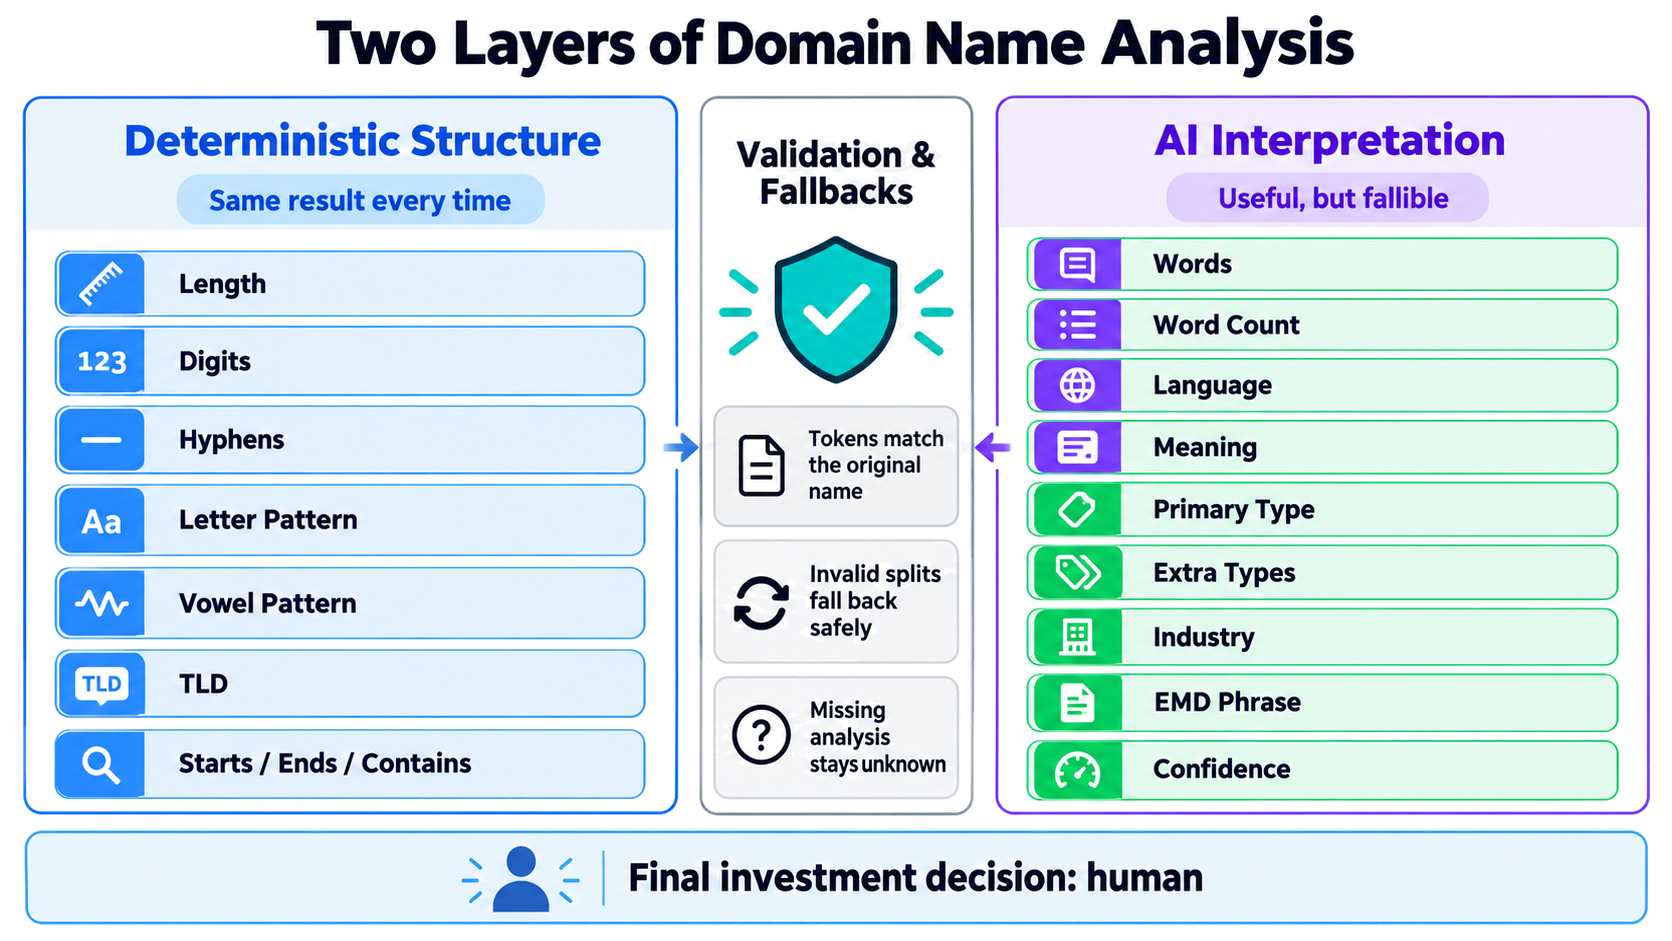
对二级域,Karma.Domains 会计算:
- 字符长度;
- 数字和连字符数量;
- 是否存在数字或连字符;
- 字母模式;
- 元音与辅音模式;
- 名称开头、结尾或任意位置的文本;
- TLD。
字母模式用 L 表示字母,N 表示数字,H 表示连字符,X 表示其他字符。元音模式用 V 表示元音,C 表示其他拉丁字母,再加上 N、H 和 X。
以 solar7.com 为例。字母模式是 LLLLLN,元音模式是 CVCVCN。模型不必「理解」这个名字,也能给出这两个结果。
当资产形状重要时,模式特别有用。找四字母名的投资者可以筛 LLLL。研究可发音五字母组合的人,可以用 CVCVC 一类元音模式,再叠加语言或名称类型过滤。
这些字段可预期。明天跑同一个过滤器,结构结果不会因为模型换了一种解读而改变。
词数结果变成了 AI 问题
词数听起来像又一个事实。其实不是——至少对没有空格的域名不是。
在说一个名字包含两个词之前,必须先决定一词在哪里结束、下一词从哪里开始。Eightshapes 大概是「eight shapes」。混杂语言、姓氏和缩写的字符串,可能有多种合理切分。一个编造品牌看起来像两个熟悉片段,但原本读法可能是一个新造词。
因此词数过滤器属于系统的 AI 辅助部分。它依赖分词,而分词依赖含义。
这个小小的认识改变了架构。我们不再把每个看起来像数字的字段都当确定性字段。
第二层解释名称
模型只收到域名和 TLD。分类时看不到外链指标、拍卖热度、流量估计或 KarmaScore。我们希望结果描述这个字符串本身,而不是拿报告别处的信号事后合理化。
分析尝试识别:
- 名称中的词语;
- 每个词可能的语言;
- 简短含义;
- 一个主类型,例如 dictionary word、descriptive phrase、personal name 或 brandable;
- 适用时的附加类型,包括 geographic、acronym 和 EMD;
- 一个或多个宽泛行业;
- 当名称像 exact-match domain 时的商业短语;
- 总体置信度。
我们使用 17 个宽泛行业类别,故意粗粒度。「Software」或「real estate」有助于缩小大列表;模型从六个字母编造极其具体的商业计划则不会。
名称类型同样克制。主类型必须唯一。不能因为模型想留余地,就把一个名字同时判成清晰的 descriptive phrase 和 coined brandable。Geographic、acronym 和 EMD 作为附加属性,因为它们回答不同问题。
纸面上这很直白。第一轮测试并不是。
模型对糟糕切分很自信
最常见的错误是词语切分。
模型会把像 eightshapes 这样明显的复合词原样粘在一起。对另一个名字,又可能切成 cop + salive,尽管第二个 token 毫无意义。多语言字符串自有麻烦。像 vuelostime 这样的名字会引出互相竞争的西语和英语读法,模型可能在两者间跳转,却不承认歧义。
语言检测带来另一类错误。早期版本从 TLD 推断语言,把拉丁字符当成英语证据,或把地名当成语言。缩写有时在没有证据时被展开。当一个词与多个市场只有弱关联时,行业标签会膨胀。
EMD 分类在两端摇摆。窄提示漏掉有用的商业短语;更宽的提示几乎把任何描述性组合都叫成 exact-match domain。
我们试过多个模型家族。有的返回残缺或截断的结构化数据。更快的模型往往把行业撒到弱关联上。有一个模型在测试批次上语言学分析明显更好,但对我们需要的量级来说太慢也太贵。
提高 temperature 没有帮助。这些是系统性错误,不是创造力不够。
有一个改动确实改善了难名:先让模型形成总体含义,再最终确定词切分。在 thegeoffcapesfoundation 上,语义上下文帮助得到 the / geoff / capes / foundation。它没有解决每个多语言或歧义案例,但给了分词更好的起点。
测试集开始讨好我们
有一段时间,我们把几个难域名及其正确解释作为示例放进提示。下一次评估看起来好很多。
好得过头了。
我们反复测试其中一些相同域名。提示实质上已经被给了答案。它能复现这些案例,却学不到可迁移到新库存的规则。
我们去掉域名特定示例,改写成通用指令。分数下降了。这很有用,因为更低的结果更诚实。
这大概是项目里最重要的开发教训。当测试集泄漏进提示时,提示可以看起来极好。域名名称很容易掩盖这个错误,因为每个麻烦字符串都像值得加进示例的特例。
之后,我们在未见过的名字上评判改动,特别关注多语言字符串、长复合词、人名、缩写,以及可有多种切分的短语。
生产控制比提示更重要
我们继续改进提示,但提示工作最终进入收益递减。生产侧防护对功能可信度贡献更大。
后端检查每个 token 都能拼回原名。模型不能加字母、丢字符,或悄悄「纠正」拼写。若切分未通过校验,系统回退到更安全的表示。
模式只允许一个主类型,避免该字段出现矛盾答案。缺失分析保持 unknown。我们不会把未处理或失败的分类变成虚假的「no」。界面上,AI 衍生过滤器和分类面板会提示结果可能不准确。
这个做法承认一个不舒服的事实:有些名字有歧义,模型有时会错。控制措施防止奇怪答案变成损坏结构或虚假确定性。
投资者仍可用相邻过滤器找到被漏掉的候选。系统绝不该让可疑推断消失在自信分数背后。
我会这样用新过滤器的四种方式
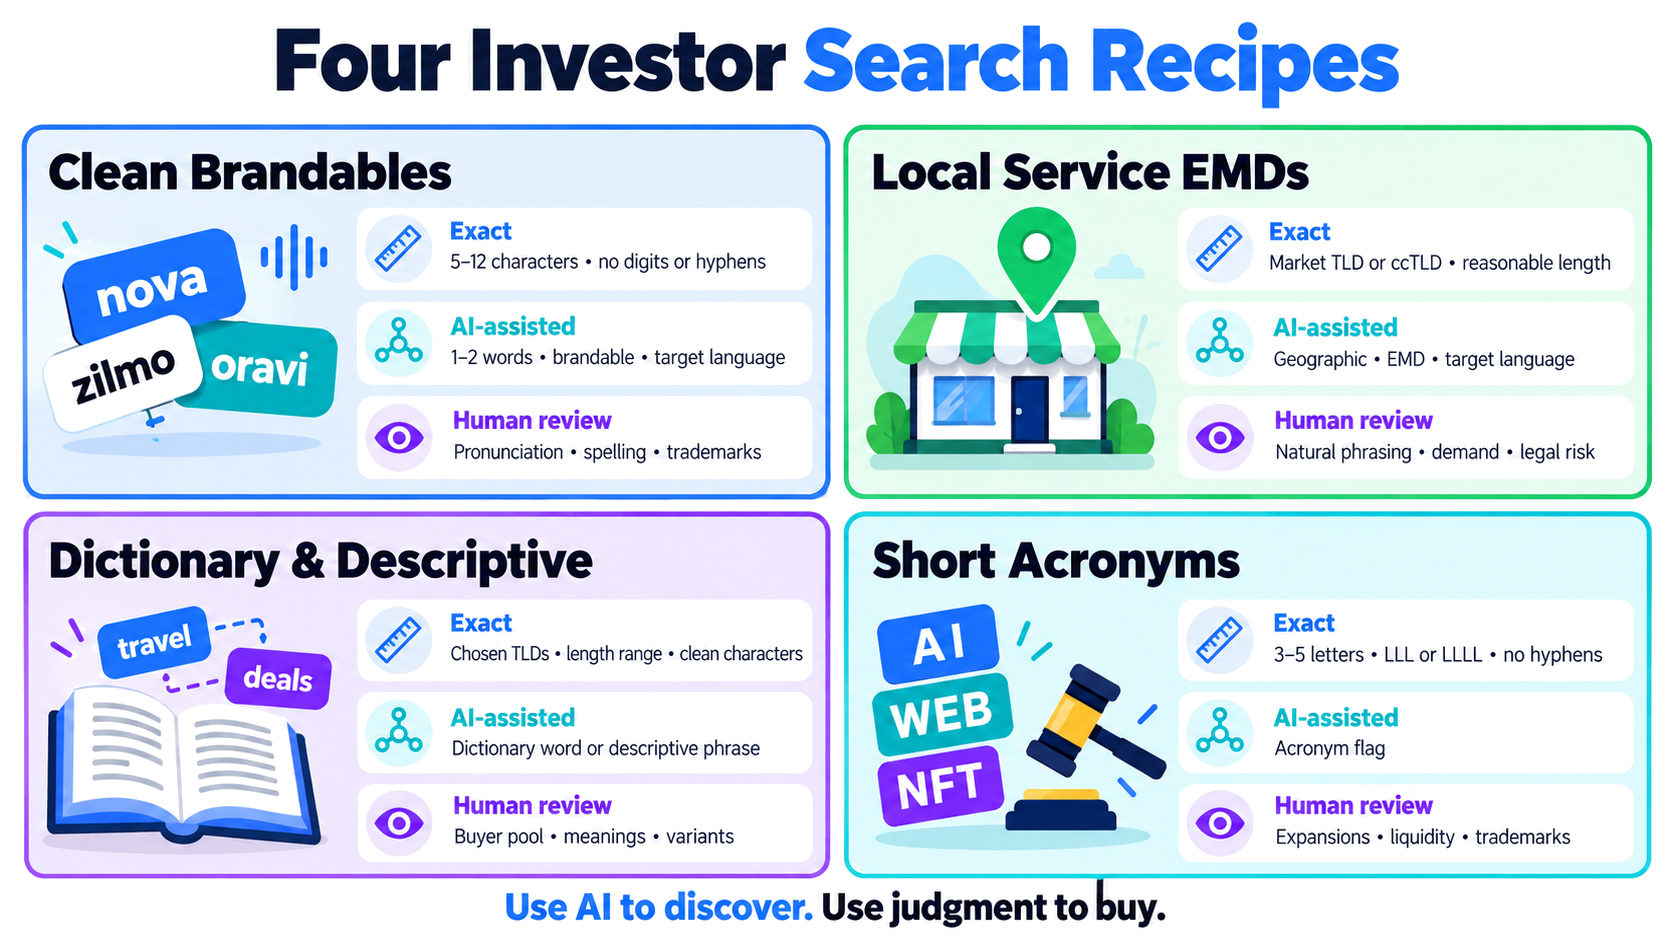
当精确结构与语义分类一起工作时,实用价值才会出现。这里是四个起步配方。区间是示例,不是普适购买规则。
| 策略 | 结构过滤器 | AI 辅助过滤器 | 人工复核 |
|---|---|---|---|
| 干净 brandable | 5–12 个字符,无数字或连字符,选定 TLD | 一或两个词,brandable,目标语言,相关行业 | 发音、拼写、电台测试、可比成交、商标 |
| 本地服务 EMD | 市场 TLD 或 ccTLD,合理长度,必需的地理或服务片段 | Geographic、EMD、目标语言、服务行业 | 自然措辞、真实搜索行为、本地需求、法律风险 |
| 词典与描述性名称 | 选定 TLD、长度范围、无多余字符 | Dictionary word 或 descriptive phrase、语言、行业 | 买家池、歧义义项、复数形式、拼写变体 |
| 短缩写 | 三到五个字母,如 LLL 或 LLLL 模式,无连字符 | Acronym 标记及可用语言上下文 | 合理展开、现有组织、流动性、商标 |
干净 brandable
我会从模型读不错的东西开始:TLD、长度、数字、连字符和模式。然后再加一两个语义约束,例如 brandable 加 software。
若列表太小,先放宽语义字段,再动定义策略的结构规则。标错行业可能藏起好名字。19 个字符的域名不会因为分类器喜欢它,就变成六字母 brandable。
本地服务名称
Geo-service 组合更受益于语义过滤,因为短语顺序和语言很重要。先搜 geographic 与 EMD 标记,再看报告里实际的分词和含义。
模型能识别城市和服务存在。它不能告诉你本地客户会不会自然说出这个短语、搜索需求是否有商业价值,或市场是否已经饱和。
词典词与描述性短语
语言在这里是有用的 discovery 过滤器,尤其跨 ccTLD。但也值得怀疑。短词可能存在于多种语言,专有名词常像词典词。
在接受类型前,我会先看报告里的彩色词语拆解。视觉切分比表格里的裸标签更容易抓住可疑解释。
缩写
对短缩写,结构筛选做大部分工作。AI 标记有助于把可能的首字母与普通短词分开,但它不可能知道每个组织、产品或小众缩写。
对这种策略,假阳性成本低;商标错误成本高。把 AI 阈值放宽,把法律与最终用户核查做严。
报告如何支持决策
Karma.Domains 报告中的 Domain name 标签页分别展示两层。
Structure 部分包含测量:长度、数字、连字符、字母模式和元音模式。Classification 部分显示提议的词切分、含义、类型、语言、行业、EMD 短语、词数和置信度。
我们还用通过校验的词切分显示可读的 CamelCase 版本。复制名称仍得到原始小写域名。格式化版本是为了让列表更好扫读,不是为了改变资产。
Brand Score 为方便出现在同一区域,但仍是独立信号。名称分析不会把它并进一个新的总分数。
如果你每月只看几十个域名,这些大多可能不必。你可以自己读名字。当原始列表有成千上万候选,或多人必须一致执行同一组合论点时,过滤器才真正有用。
同样的字段也能在浏览器外使用
我们把功能建进现有搜索层,因此名称字段可通过网页界面、Karma.Domains Public API 和 Karma.Domains MCP 服务器 使用。
在网页应用中,投资者可以把新字段与拍卖来源、当前价格、结束时间、TLD、历史和 SEO 过滤器组合。
API 支持在私有仪表盘、表格流水线或组合 workflow 中做可重复搜索。投资者可以把论点存成查询参数,对着新库存运行,而不必每次重建界面。
MCP 把同一搜索开放给 ChatGPT、Claude 和其他兼容助手。请求可以是对话式的:
找没有数字或连字符的短
.com拍卖名。保留被分类为 software 或 finance 中 brandable 的一到两个英文词名称。显示名称拆解和拍卖详情。
下一条消息可以调整论点:
保留结构规则,去掉 finance,并纳入少于十个字符的 descriptive phrases。
自然语言让迭代更容易。真正做搜索的仍是底层过滤器。
自动化止步之处
名称分析不估计售价、不预测 sell-through rate、也不批准购买。它不能替代商标调研、母语判断、可比成交分析,或对归档与外链画像的仔细查看。
它也不知道你的持有成本、偏好市场、对流动性不足的容忍度,或接触潜在买家的渠道。这些变量往往比报告里多一个信号更重要。
我偏好的 workflow 很简单。用确定性过滤器定义资产形状;用 AI 字段探索含义与商业语境;打开幸存下来的那一小批报告;再在出价前检查历史、链接、法律风险、可比成交和当前拍卖条件。
当它把 1 万个名字变成 40 个值得读的名字时,这个功能就值了。选出四个值得买的,仍是投资者的工作。