
Dois domínios podem ter métricas de SEO parecidas e potencial de investimento completamente diferente. Criamos a análise de nomes de domínio no Karma.Domains para ajudar investidoras e investidores a separar esses casos antes da parte manual e cara do due diligence.
Sumário
- Sumário
- Eu não queria mais um score de appraisal
- Quase construímos demais
- A primeira camada contém fatos
- A contagem de palavras virou um problema de IA
- A segunda camada interpreta o nome
- O modelo estava confiante em divisões ruins
- Nosso conjunto de teste começou a nos bajular
- Controles de produção importaram mais que o prompt
- Quatro formas como eu usaria os novos filtros
- Como o relatório apoia a decisão
- Os mesmos campos funcionam fora do navegador
- Onde a automação para
Enquanto revisava listas de leilão e de domínios expirados no Karma.Domains, eu esbarrava sempre na mesma lacuna. Nossos relatórios podiam me contar muito sobre o passado de um domínio: o que havia no site antes, quais temas apareciam no arquivo, se o perfil de backlinks mostrava risco óbvio e quais sinais de SEO estavam disponíveis.
O relatório dizia bem menos sobre o nome em si.
Essa distinção importa para quem investe em domínios. Um nome comercial limpo de duas palavras e uma junção desajeitada de fragmentos podem ficar lado a lado com métricas de autoridade semelhantes. Um pode ser fácil de pronunciar, fácil de lembrar e útil para vários tipos de compradores. O outro pode não ter nenhum usuário final plausível.
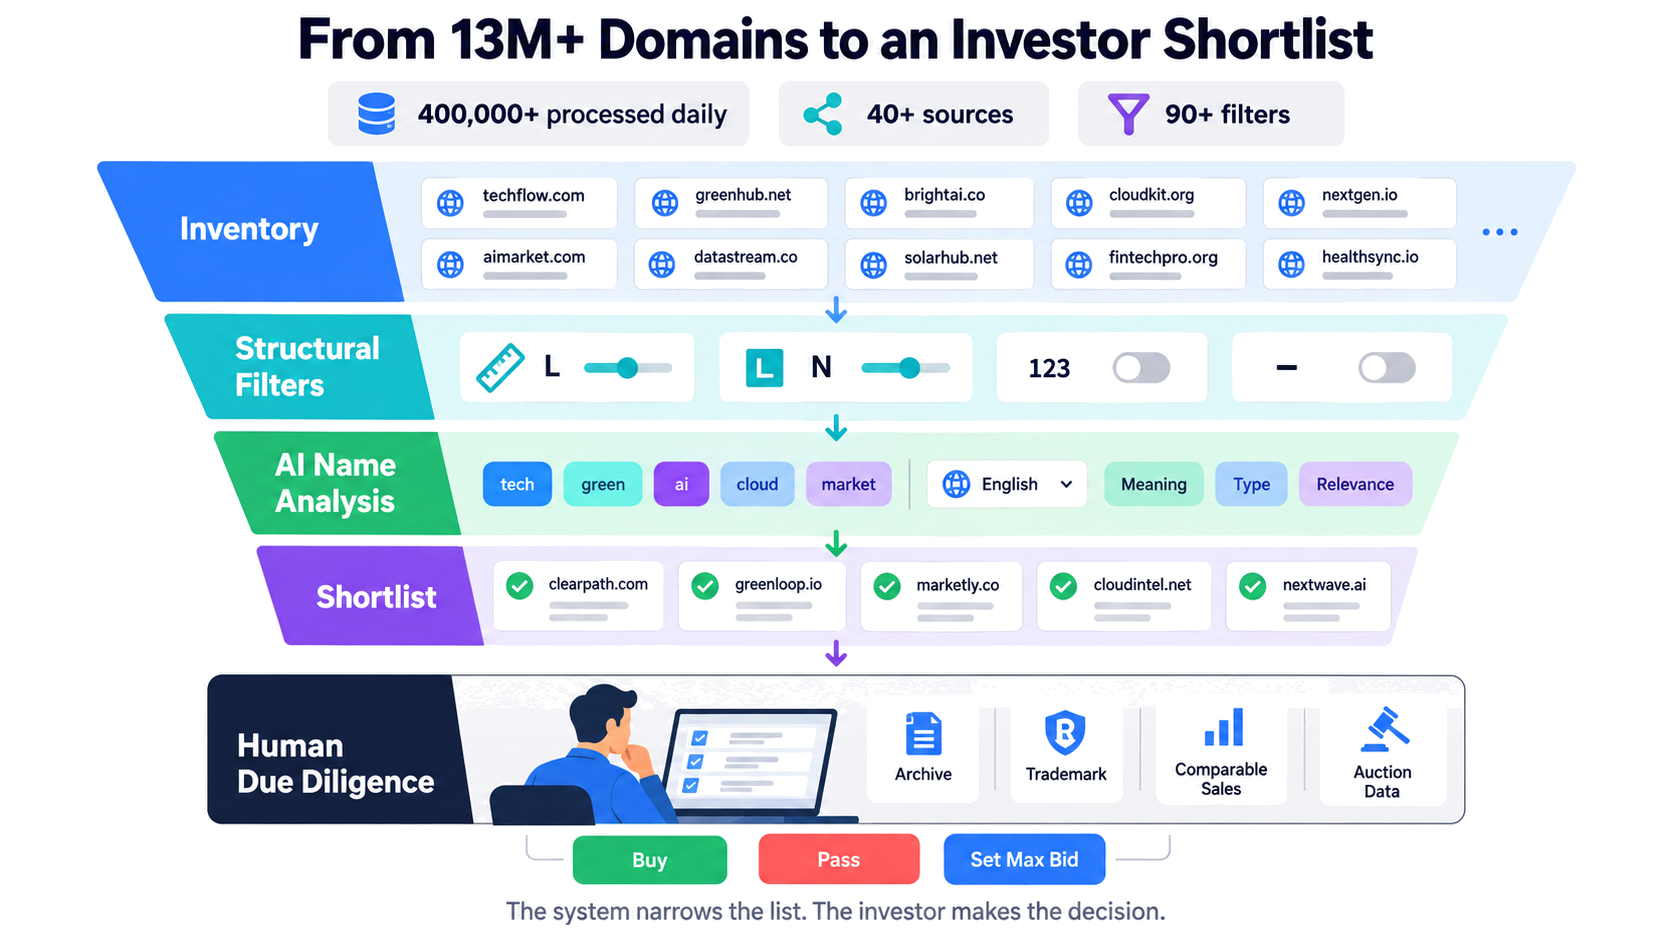
Quando nossa base passou de 13 milhões de domínios expirados e em leilão, com mais de 400 mil domínios processados por dia a partir de 40+ fontes, esse ponto cego ficou mais difícil de ignorar. O Karma.Domains já suportava 90+ filtros e combinava dados disponíveis de Ahrefs, Semrush, Moz, Majestic, Similarweb, Wayback Machine e outras fontes. Era possível filtrar histórico e sinais de SEO com detalhe. Ainda assim, era preciso ler milhares de nomes um a um.
Então construímos uma nova camada para a pergunta que toda domainer faz primeiro: o nome vale um olhar mais atento?
Eu não queria mais um score de appraisal
A ideia óbvia de produto era um único número de «qualidade de investimento». Eu a rejeitei cedo.
Um domínio não tem valor universal fora de um comprador, um mercado, um horizonte de venda e uma estratégia. Quem se especializa em acrônimos curtos vê um ativo diferente de quem monta um portfólio de domínios de serviços locais. Uma frase natural em holandês pode parecer sem sentido para um modelo só em inglês. Um nome geo-service forte pode ser útil para geração de leads e irrelevante para um marketplace de brandables.
Um único score esconderia essas premissas. Pior: faria uma saída subjetiva do modelo parecer precisa.
O Karma.Domains já tem um Brand Score, e mantivemos separado. A nova análise expõe as evidências pelas quais se pode filtrar: estrutura, palavras, idioma, tipo de nome, setor e possível intenção exact-match. A estratégia vem da investidora ou do investidor.
Minha opinião aqui é bem firme: appraisal é a abstração errada para a fase de discovery. Discovery deve reduzir a pilha e preservar as razões pelas quais um nome sobreviveu.
Quase construímos demais
Nossa primeira visão de produto era bem maior. Incluía views específicas para investidores, projetos, uma inbox, um pipeline de deals, monitoramento e várias outras funções de workflow.
A maior parte dessas ideias ainda pode ser útil. Elas também eram uma boa forma de gastar meses construindo um produto separado antes de provar que investidoras e investidores queriam a análise de base.
Cortamos o escopo. A primeira versão deveria viver dentro da experiência de busca e relatório que as pessoas já usavam. Adicionar campos ao registro de domínio existente, filtros à lista existente e um detalhamento legível ao relatório existente. Os mesmos dados também estariam disponíveis via Public API e MCP.
Essa decisão moldou a feature. Estávamos construindo uma melhor primeira passagem pelo inventário, não um substituto do sistema de portfólio de uma investidora.
A primeira camada contém fatos
Algumas propriedades de um nome de domínio não precisam de um modelo de linguagem.
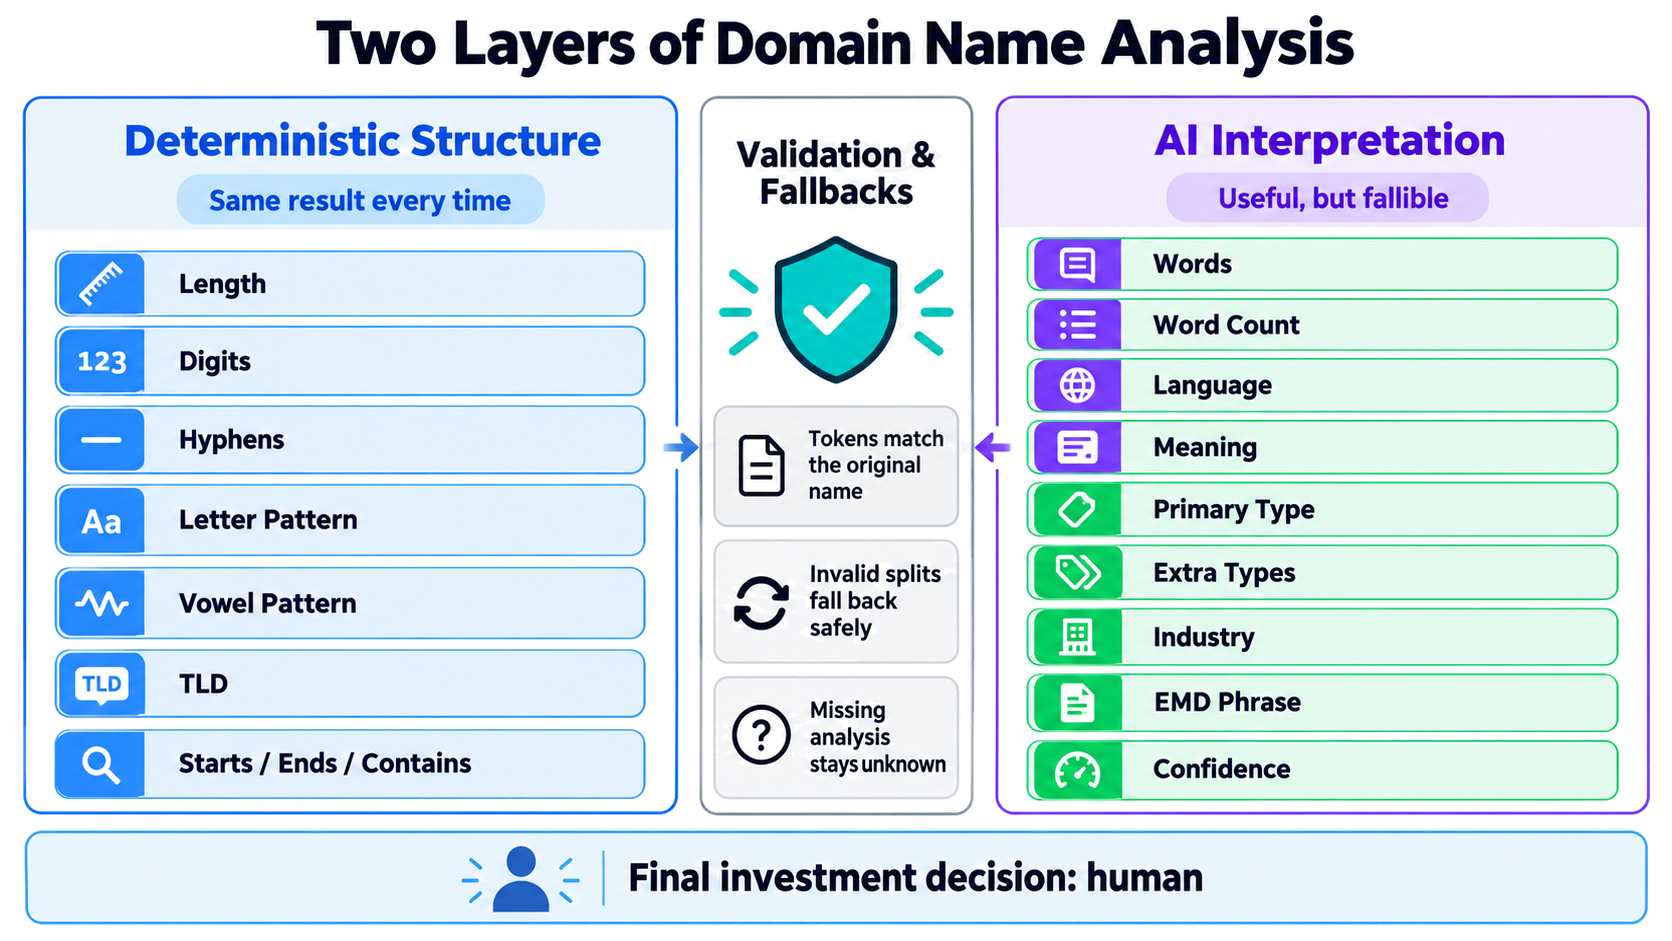
Para o domínio de segundo nível, o Karma.Domains calcula:
- comprimento em caracteres;
- contagem de dígitos e hífens;
- se há dígitos ou hífens;
- um padrão de letras;
- um padrão de vogais e consoantes;
- texto no início, no fim ou em qualquer parte do nome;
- o TLD.
O padrão de letras usa L para letra, N para número, H para hífen e X para outro caractere. O padrão de vogais usa V para vogal, C para outra letra latina, mais N, H e X.
Pegue solar7.com como exemplo simples. Seu padrão de letras é LLLLLN. Seu padrão de vogais é CVCVCN. Nenhum modelo precisa «entender» o nome para produzir qualquer um desses resultados.
Padrões são especialmente úteis quando a forma do ativo importa. Quem procura nomes de quatro letras pode filtrar por LLLL. Quem pesquisa combinações pronunciáveis de cinco letras pode trabalhar com padrões de vogais como CVCVC e depois aplicar um filtro de idioma ou tipo de nome.
Esses campos são previsíveis. Rode o mesmo filtro amanhã e o resultado estrutural não mudará porque um modelo interpretou o nome de outro jeito.
A contagem de palavras virou um problema de IA
Contagem de palavras parece mais um fato. Não é — pelo menos não para um domínio sem espaços.
Antes de dizer que um nome contém duas palavras, precisamos decidir onde uma termina e a seguinte começa. Eightshapes provavelmente significa «eight shapes». Uma string que mistura idiomas, um sobrenome e uma abreviação pode admitir várias divisões razoáveis. Uma marca inventada pode parecer dois fragmentos familiares mesmo quando a leitura pretendida é uma única palavra cunhada.
É por isso que o filtro de contagem de palavras pertence à parte assistida por IA do sistema. Depende de tokenização, e tokenização depende de significado.
Essa pequena percepção mudou a arquitetura. Paramos de tratar como determinístico todo campo que parecia numérico.
A segunda camada interpreta o nome
O modelo recebe o nome de domínio e o TLD. Ao classificar o nome, ele não vê métricas de backlinks, popularidade de leilão, estimativas de tráfego nem KarmaScore. Queríamos que o resultado descrevesse a string, não que racionalizasse sinais de outras partes do relatório.
A análise tenta identificar:
- as palavras dentro do nome;
- o idioma provável de cada palavra;
- um significado curto;
- um tipo primário, como dictionary word, descriptive phrase, personal name ou brandable;
- tipos adicionais quando aplicável, incluindo geographic, acronym e EMD;
- um ou mais setores amplos;
- uma frase comercial quando o nome parece um exact-match domain;
- um nível geral de confiança.
Usamos 17 categorias setoriais amplas. Elas são deliberadamente grosseiras. «Software» ou «real estate» ajudam a estreitar uma lista grande. Um modelo inventando um plano de negócios extremamente específico a partir de seis letras, não.
A mesma contenção vale para tipos de nome. Um tipo primário precisa ser singular. Um nome não pode ser ao mesmo tempo uma descriptive phrase clara e um brandable cunhado só porque o modelo quer se proteger. Geographic, acronym e EMD funcionam como atributos adicionais porque respondem a outras perguntas.
No papel, isso parecia direto. Os primeiros testes não foram.
O modelo estava confiante em divisões ruins
O erro mais comum era a segmentação de palavras.
Um modelo deixava colado um composto óbvio como eightshapes. Em outro nome, produzia uma divisão equivalente a cop + salive, embora o segundo token não fizesse sentido. Strings multilíngues causavam seus próprios problemas. Um nome como vuelostime convida a leituras concorrentes em espanhol e inglês, e o modelo podia saltar entre elas sem admitir a ambiguidade.
A detecção de idioma criou outra classe de erros. Versões iniciais inferiam um idioma a partir do TLD, tratavam caracteres latinos como prova de inglês ou confundiam um topônimo com um idioma. Acrônimos às vezes eram expandidos sem evidência. Rótulos de setor se multiplicavam quando uma palavra tinha associação fraca com vários mercados.
A classificação EMD oscilava nas duas direções. Um prompt estreito perdia frases comerciais úteis. Um mais amplo começou a chamar exact-match domain quase qualquer combinação descritiva.
Testamos várias famílias de modelos. Algumas devolviam dados estruturados malformados ou truncados. Modelos mais rápidos tendiam a espalhar setores por associações fracas. Um modelo produziu análise linguística bem melhor num lote de teste, mas era lento e caro demais para o volume que precisávamos processar.
Aumentar a temperature não ajudou. Eram erros sistemáticos, não falta de criatividade.
Uma mudança melhorou nomes difíceis: pedir ao modelo que formasse primeiro um significado geral antes de fechar a divisão em palavras. Em thegeoffcapesfoundation, o contexto semântico ajudou a chegar a the / geoff / capes / foundation. Não resolveu todo caso multilíngue ou ambíguo, mas deu à tokenização um ponto de partida melhor.
Nosso conjunto de teste começou a nos bajular
Em certo momento, adicionamos ao prompt vários domínios difíceis e suas interpretações corretas como exemplos. A avaliação seguinte parecia bem melhor.
Bom demais.
Estávamos testando repetidamente alguns dos mesmos domínios. O prompt tinha, na prática, recebido as respostas. Podia reproduzir esses casos sem aprender uma regra transferível para inventário novo.
Removemos os exemplos específicos de domínio e os reescrevemos como instruções gerais. As pontuações caíram. Foi útil, porque o resultado mais baixo era honesto.
Essa foi provavelmente a lição de desenvolvimento mais importante do projeto. Um prompt pode parecer excelente quando o conjunto de teste vaza para dentro dele. Nomes de domínio tornam esse erro fácil de deixar passar, porque cada string problemática parece um caso especial que merece ser adicionado como exemplo.
Depois disso, avaliamos mudanças em nomes não vistos, com atenção extra a strings multilíngues, compostos longos, nomes pessoais, acrônimos e frases que podem ser segmentadas de mais de uma forma.
Controles de produção importaram mais que o prompt
Continuamos melhorando o prompt, mas o trabalho nele acabou batendo em retornos decrescentes. As salvaguardas de produção fizeram mais para tornar a feature confiável.
O backend verifica que cada token possa ser juntado de volta ao nome original. O modelo não pode adicionar uma letra, remover um caractere ou «corrigir» a ortografia em silêncio. Se a divisão falha na validação, o sistema volta a uma representação mais segura.
O schema permite um tipo primário, o que evita respostas contraditórias nesse campo. Análise ausente permanece unknown. Não convertemos uma classificação não processada ou falha em um falso «no». Na interface, filtros derivados de IA e o painel de classificação carregam o aviso de que o resultado pode ser impreciso.
Essa abordagem aceita um fato desconfortável: alguns nomes são ambíguos, e o modelo às vezes erra. Os controles impedem que uma resposta estranha se torne estrutura corrompida ou falsa certeza.
Uma investidora ainda pode achar um candidato esquecido com filtros vizinhos. O sistema nunca deve fazer uma inferência duvidosa desaparecer atrás de um score confiante.
Quatro formas como eu usaria os novos filtros
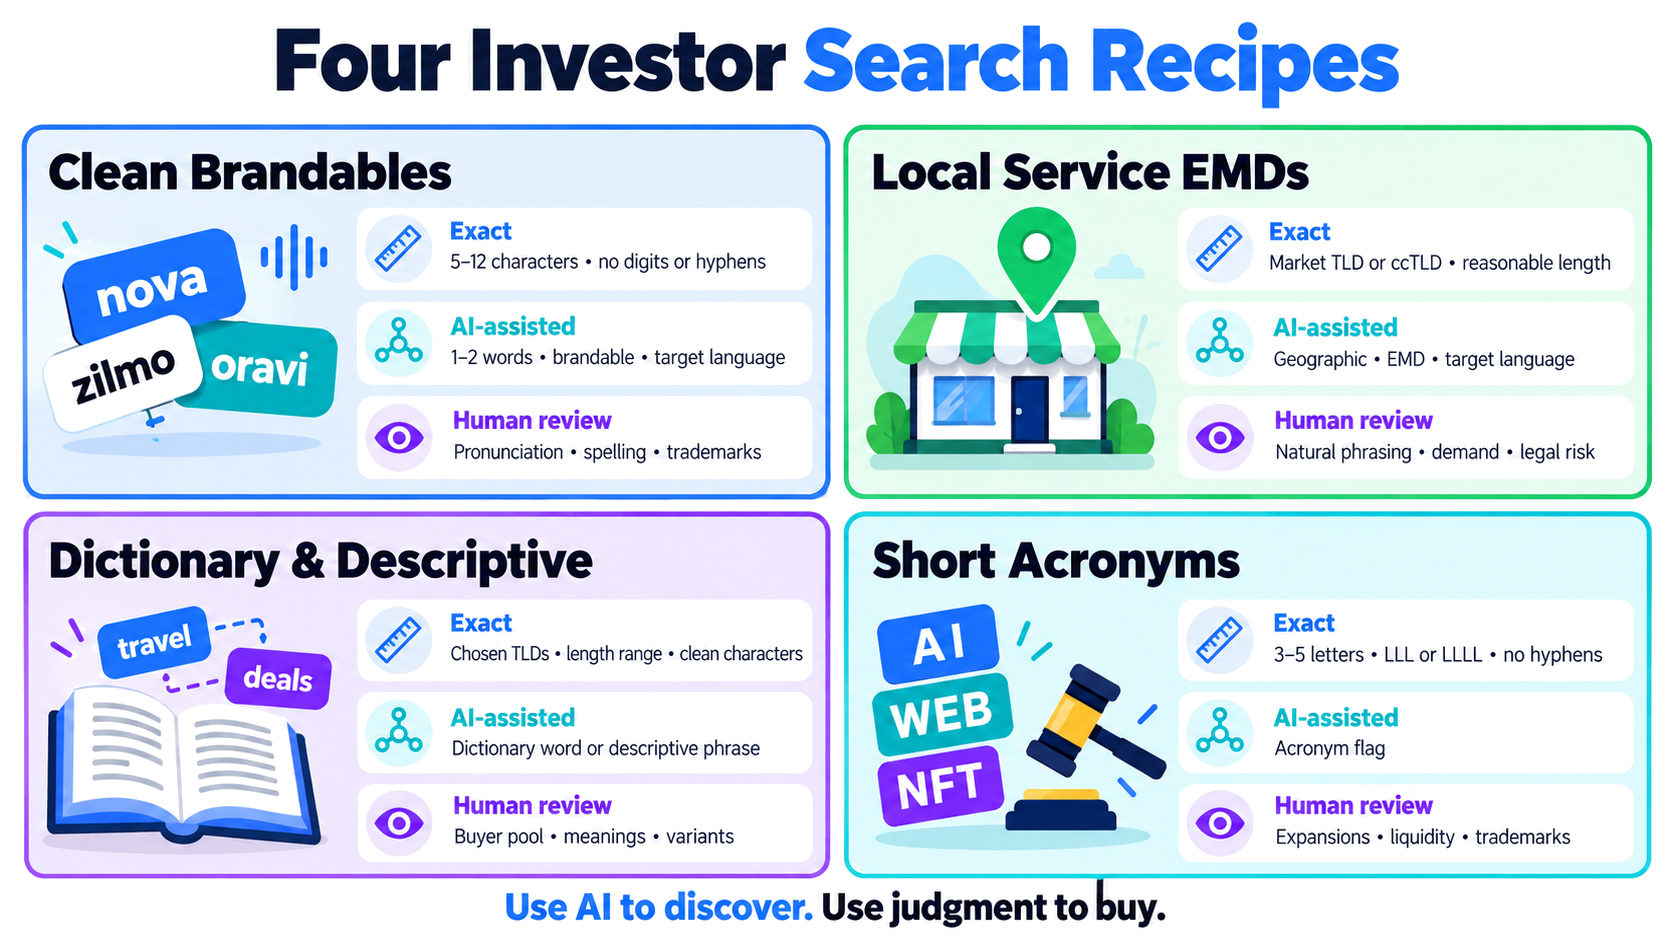
O valor prático aparece quando estrutura exata e classificação semântica trabalham juntas. Aqui vão quatro receitas iniciais. As faixas são exemplos, não regras universais de compra.
| Estratégia | Filtros estruturais | Filtros assistidos por IA | Revisão manual |
|---|---|---|---|
| Brandables limpos | 5–12 caracteres, sem dígitos ou hífens, TLDs selecionados | Uma ou duas palavras, brandable, idioma-alvo, setor relevante | Pronúncia, ortografia, radio test, vendas comparáveis, marcas |
| EMDs de serviço local | TLD de mercado ou ccTLD, comprimento razoável, fragmento geo ou de serviço exigido | Geographic, EMD, idioma-alvo, setor de serviço | Formulação natural, comportamento real de busca, demanda local, risco jurídico |
| Nomes de dicionário e descritivos | TLDs escolhidos, faixa de comprimento, sem caracteres indesejados | Dictionary word ou descriptive phrase, idioma, setor | Pool de compradores, significados alternativos, forma plural, variantes ortográficas |
| Acrônimos curtos | Três a cinco letras, padrões como LLL ou LLLL, sem hífens | Flag de acronym e contexto linguístico quando disponível | Expansões plausíveis, organizações existentes, liquidez, marcas |
Brandables limpos
Eu começaria pelo que o modelo não pode ler errado: TLD, comprimento, dígitos, hífens e padrão. Depois adicionaria uma ou duas restrições semânticas, como brandable mais software.
Se a lista ficar pequena demais, afrouxe o campo semântico antes das regras estruturais que definem a estratégia. Um setor mal rotulado pode esconder um bom nome. Um domínio de 19 caracteres não vira um brandable de seis letras porque o classificador gostou dele.
Nomes de serviços locais
Combinações geo-service se beneficiam mais de filtros semânticos porque ordem e idioma da frase importam. Busque as flags geographic e EMD e depois revise a tokenização e o significado reais no relatório.
Um modelo pode reconhecer que há uma cidade e um serviço. Não pode dizer se uma cliente local diria a frase naturalmente, se a demanda de busca é comercialmente útil ou se o mercado já está saturado.
Palavras de dicionário e frases descritivas
Idioma é um filtro útil de discovery aqui, especialmente entre ccTLDs. Também merece ceticismo. Palavras curtas podem existir em vários idiomas, e nomes próprios costumam se parecer com palavras de dicionário.
Antes de aceitar o tipo, eu inspecionaria o detalhamento colorido de palavras no relatório. A divisão visual torna uma interpretação duvidosa mais fácil de pegar do que um rótulo solto numa tabela.
Acrônimos
A passagem estrutural faz a maior parte do trabalho com acrônimos curtos. A flag de IA ajuda a separar iniciais prováveis de palavras curtas comuns, mas não conhece cada organização, produto ou abreviação de nicho.
Para essa estratégia, falsos positivos são baratos. Erros de marca não são. Mantenha o limiar de IA amplo e as checagens jurídicas e de usuário final rigorosas.
Como o relatório apoia a decisão
A aba Domain name num relatório do Karma.Domains mostra as duas camadas separadamente.
A seção Structure contém as medições: comprimento, dígitos, hífens, padrão de letras e padrão de vogais. A seção Classification mostra a divisão de palavras proposta, significado, tipo, idiomas, setores, frase EMD, contagem de palavras e confiança.
Também usamos a divisão validada para exibir uma versão CamelCase legível do domínio. Copiar o nome ainda entrega o domínio original em minúsculas. A versão formatada existe para facilitar a varredura de uma lista, não para alterar o ativo.
Brand Score aparece na mesma área por conveniência, mas continua sendo seu próprio sinal. A análise do nome não o absorve num novo número mestre.
Se você revisa só algumas dezenas de domínios por mês, boa parte disso pode ser desnecessária. Você mesma pode ler os nomes. Os filtros ficam úteis quando a lista bruta tem milhares de candidatos ou quando várias pessoas precisam aplicar a mesma tese de portfólio de forma consistente.
Os mesmos campos funcionam fora do navegador
Construímos a feature na camada de busca existente, então os campos de nome estão disponíveis pela interface web, pela Public API do Karma.Domains e pelo servidor MCP do Karma.Domains.
No app web, uma investidora pode combinar os novos campos com fonte de leilão, preço atual, horário de término, TLD, histórico e filtros de SEO.
A API suporta buscas repetíveis dentro de um dashboard privado, pipeline de planilha ou workflow de portfólio. É possível guardar uma tese como parâmetros de consulta e rodá-la contra inventário novo sem remontar a tela toda vez.
O MCP expõe a mesma busca para ChatGPT, Claude e outros assistentes compatíveis. Um pedido pode ser conversacional:
Encontre nomes
.comcurtos em leilão, sem dígitos ou hífens. Mantenha nomes em inglês de uma ou duas palavras classificados como brandable em software ou finance. Mostre o detalhamento do nome e os detalhes do leilão.
A mensagem seguinte pode ajustar a tese:
Mantenha as regras estruturais, remova finance e inclua descriptive phrases com menos de dez caracteres.
Linguagem natural facilita a iteração. Os filtros subjacentes ainda fazem a busca de verdade.
Onde a automação para
A análise do nome não estima preço de venda, não prevê taxa de sell-through nem aprova uma compra. Não substitui pesquisa de marcas, julgamento de falante nativa, análise de vendas comparáveis nem um olhar atento ao arquivo e ao perfil de backlinks.
Também não conhece seu custo de holding, marketplaces preferidos, tolerância à iliquidez ou acesso a compradores prováveis. Essas variáveis muitas vezes pesam mais do que um sinal a mais num relatório.
Meu workflow preferido é simples. Use filtros determinísticos para definir a forma do ativo. Adicione campos de IA para explorar significado e contexto comercial. Abra os relatórios do pequeno grupo que sobra. Depois confira histórico, links, risco jurídico, vendas comparáveis e condições atuais do leilão antes de dar um lance.
A feature ganha seu lugar quando transforma 10 mil nomes em 40 que valem a leitura. Escolher os quatro que valem a compra continua sendo o trabalho da investidora.