
สองโดเมนอาจมีเมตริก SEO ใกล้เคียงกัน แต่ศักยภาพการลงทุนต่างกันโดยสิ้นเชิง เราสร้างการวิเคราะห์ชื่อโดเมนใน Karma.Domains เพื่อช่วยให้นักลงทุนแยกกรณีเหล่านี้ก่อนส่วน due diligence ที่แพงและทำด้วยมือจะเริ่มต้น
สารบัญ
- สารบัญ
- ฉันไม่ต้องการคะแนน appraisal อีกอัน
- เราเกือบสร้างมากเกินไป
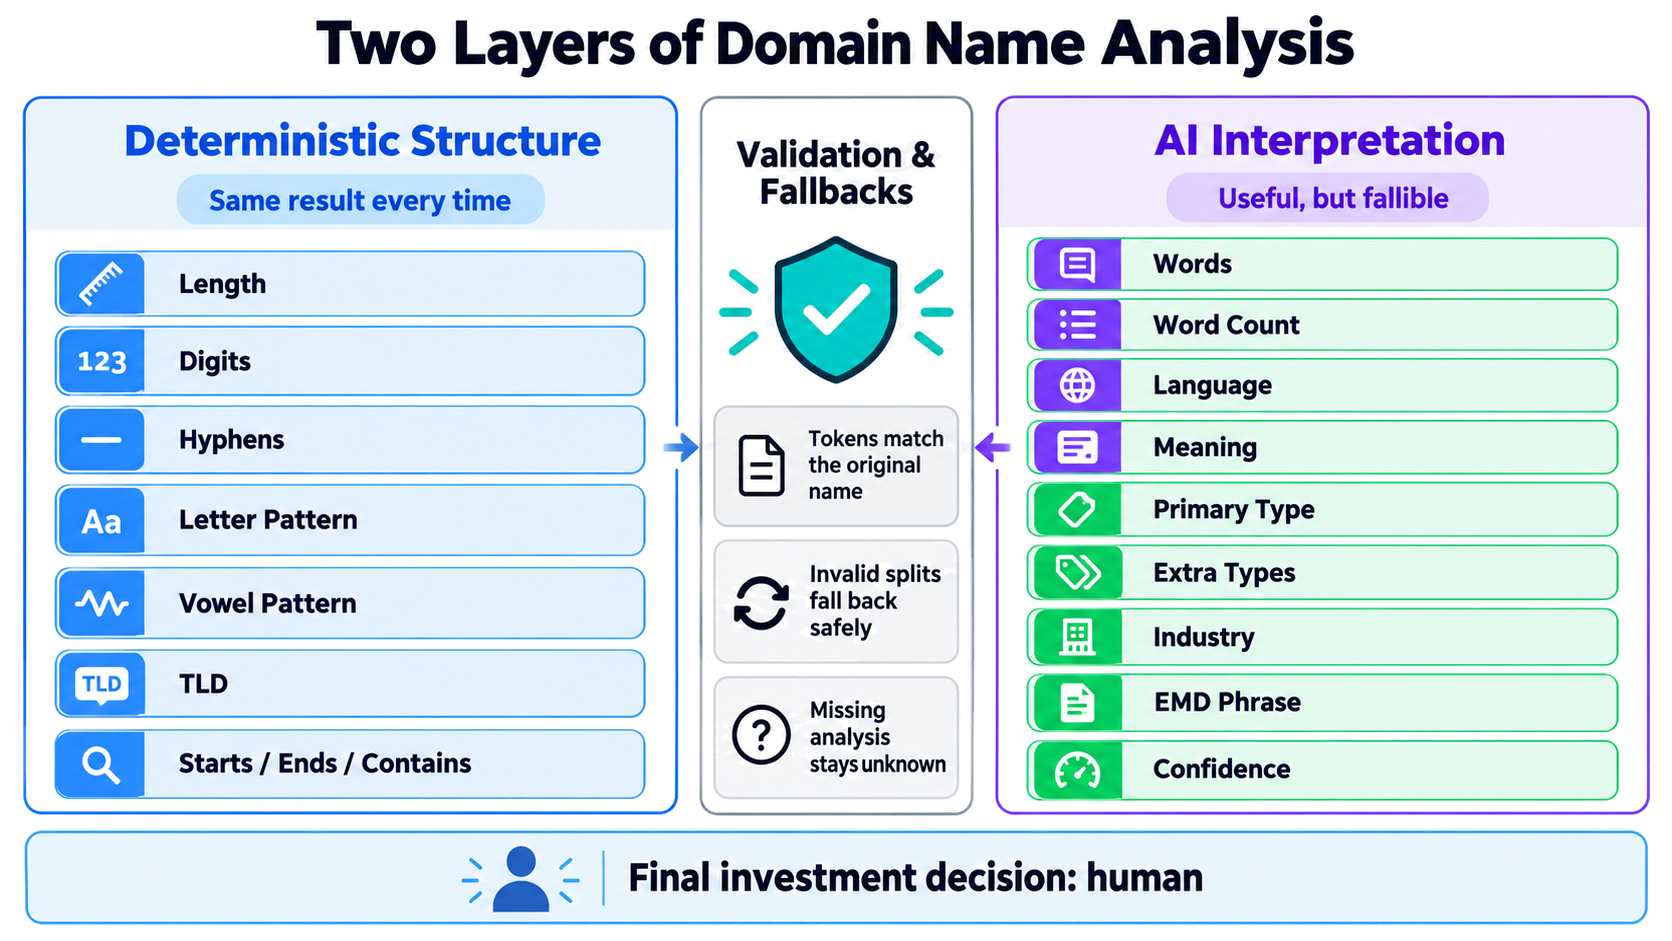
- ชั้นแรกเก็บข้อเท็จจริง
- การนับคำกลายเป็นปัญหาของ AI
- ชั้นที่สองตีความชื่อ
- โมเดลมั่นใจกับการตัดที่แย่
- ชุดทดสอบเริ่มประจบเรา
- การควบคุมในโปรดักชันสำคัญกว่าพรอมต์
- สี่วิธีที่ฉันจะใช้ตัวกรองใหม่
- รายงานสนับสนุนการตัดสินใจอย่างไร
- ฟิลด์เดียวกันใช้ได้ข้างนอกเบราว์เซอร์
- จุดที่ระบบอัตโนมัติหยุด
ตอนที่ฉันไล่ดูรายการประมูลและโดเมนหมดอายุใน Karma.Domains ฉันเจอช่องว่างเดิมซ้ำแล้วซ้ำเล่า รายงานของเราบอกเรื่องอดีตของโดเมนได้มาก: เคยมีอะไรบนไซต์ หัวข้อไหนปรากฏในคลังเก็บ ประวัติแบ็คลิงก์มีความเสี่ยงชัดหรือไม่ และมีสัญญาณ SEO อะไรให้ใช้
แต่รายงานพูดถึงตัวชื่อเองน้อยกว่ามาก
ความต่างนี้สำคัญกับนักลงทุนโดเมน ชื่อเชิงพาณิชย์สองคำที่สะอาดกับสายตัวอักษรชิ้นส่วนที่เกะกะอาจอยู่ข้างกันด้วยเมตริกอำนาจใกล้เคียงกัน อันหนึ่งอาจออกเสียงง่าย จำง่าย และมีประโยชน์กับผู้ซื้อหลายประเภท อีกอันอาจไม่มีผู้ใช้ปลายทางที่สมเหตุสมผลเลย
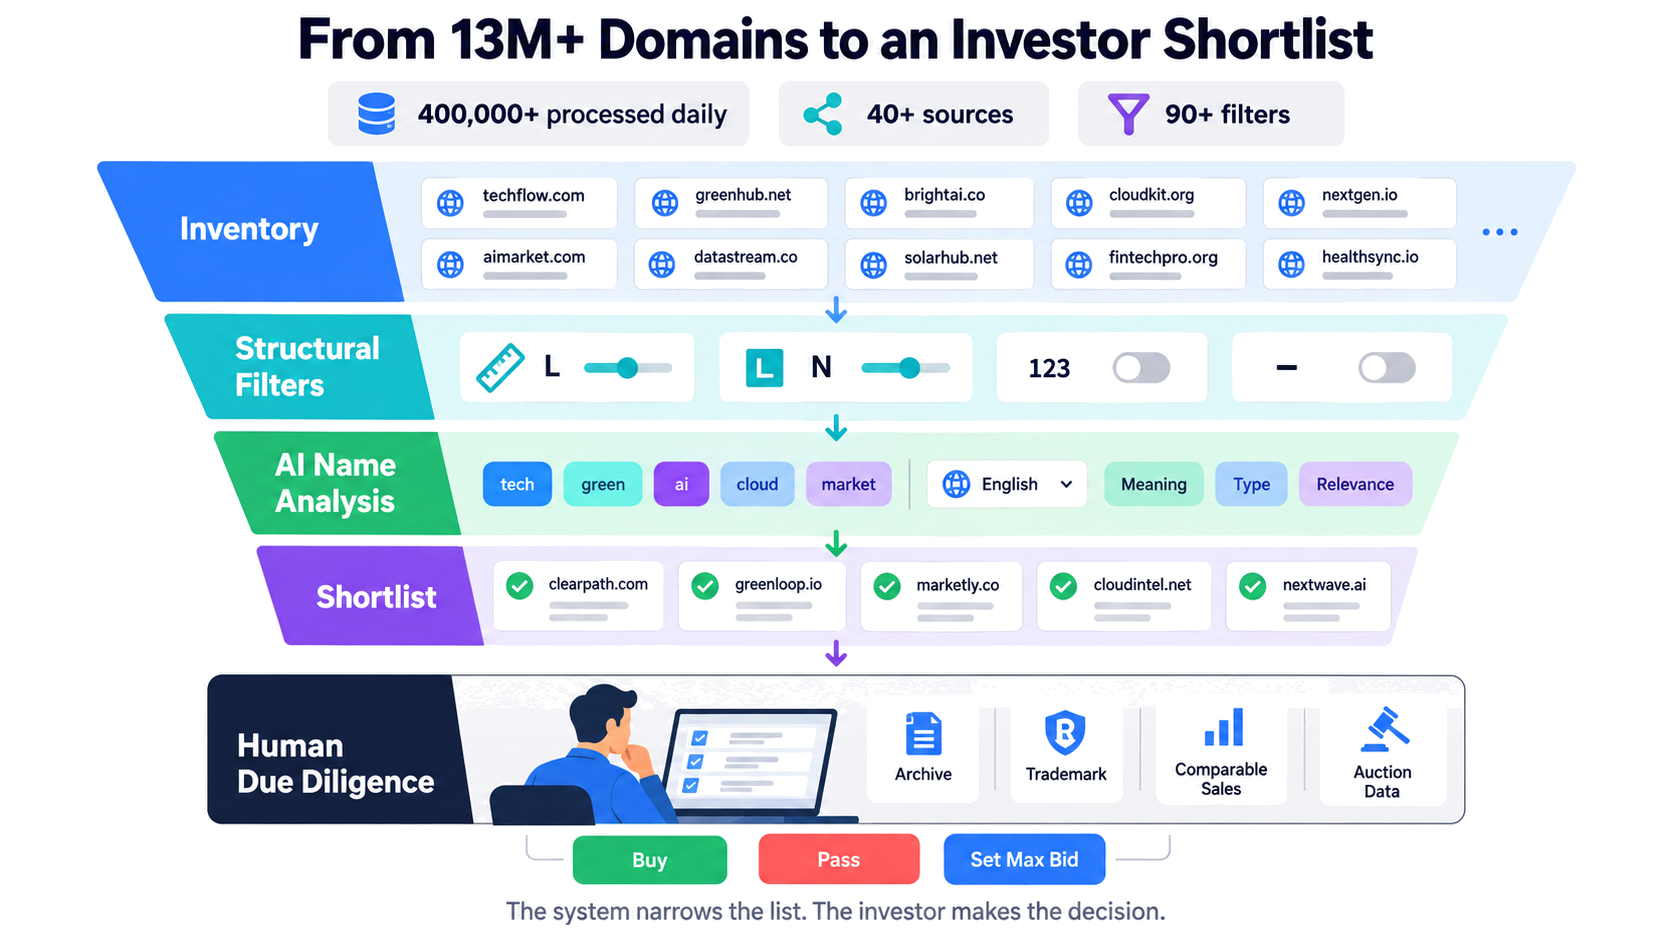
เมื่อฐานข้อมูลของเราโตเกิน 13 ล้านโดเมนหมดอายุและโดเมนประมูล โดยประมวลผลมากกว่า 400,000 โดเมนต่อวันจากแหล่งกว่า 40 แห่ง จุดบอดนี้ยิ่งมองข้ามยากขึ้น Karma.Domains รองรับตัวกรองกว่า 90 รายการอยู่แล้ว และรวมข้อมูลที่มีจาก Ahrefs, Semrush, Moz, Majestic, Similarweb, Wayback Machine และแหล่งอื่น นักลงทุนคัดประวัติและสัญญาณ SEO ได้ละเอียด แต่ยังต้องอ่านชื่อทีละชื่อเป็นพัน ๆ ชื่ออยู่ดี
เราจึงสร้างชั้นใหม่สำหรับคำถามที่โดเมนเนอร์ทุกคนถามก่อน: ชื่อนี้คุ้มที่จะดูใกล้ขึ้นไหม?
ฉันไม่ต้องการคะแนน appraisal อีกอัน
ไอเดียผลิตภัณฑ์ที่ชัดที่สุดคือตัวเลขเดียวของ «คุณภาพการลงทุน» ฉันปฏิเสธตั้งแต่ต้น
โดเมนไม่มีมูลค่าสากลนอกเหนือจากผู้ซื้อ ตลาด ขอบฟ้าการขาย และกลยุทธ์ นักลงทุนที่เชี่ยวชาญอักษรย่อสั้น ๆ มองสินทรัพย์ต่างจากคนที่สร้างพอร์ตโดเมนบริการท้องถิ่น วลีธรรมชาติในภาษาดัตช์อาจดูไร้ความหมายกับโมเดลที่รู้แค่อังกฤษ ชื่อ geo-service ที่แข็งแรงอาจมีประโยชน์กับผู้ทำ lead generation แต่ไม่เกี่ยวอะไรกับตลาด brandable
คะแนนเดียวจะซ่อนสมมติฐานเหล่านี้ แย่กว่านั้น มันจะทำให้ผลลัพธ์โมเดลที่เป็นอัตวิสัยดูเหมือนแม่นยำ
Karma.Domains มี Brand Score อยู่แล้ว และเราแยกมันไว้ การวิเคราะห์ใหม่เปิดหลักฐานที่นักลงทุนอาจอยากกรอง: โครงสร้าง คำ ภาษา ประเภทชื่อ อุตสาหกรรม และเจตนา exact-match ที่เป็นไปได้ กลยุทธ์มาจากนักลงทุนเอง
ความเห็นของฉันตรงนี้ค่อนข้างชัด: appraisal คือ abstraction ที่ผิดสำหรับขั้น discovery Discovery ควรลดกองลง ขณะที่ยังเก็บเหตุผลที่ชื่อรอดมาได้
เราเกือบสร้างมากเกินไป
วิสัยทัศน์ผลิตภัณฑ์แรกของเรากว้างกว่ามาก รวมมุมมองเฉพาะนักลงทุน โปรเจกต์ inbox ท่อดีล การเฝ้าติดตาม และฟีเจอร์ workflow อื่นอีกหลายอย่าง
ไอเดียพวกนั้นส่วนใหญ่ยังอาจมีประโยชน์ แต่ก็เป็นวิธีดี ๆ ที่จะใช้เวลาหลายเดือนสร้างผลิตภัณฑ์แยก ก่อนจะพิสูจน์ว่านักลงทุนต้องการการวิเคราะห์พื้นฐานจริง
เราตัดขอบเขตลง รีลีสแรกต้องอยู่ในประสบการณ์ค้นหาและรายงานที่คนใช้อยู่แล้ว เพิ่มฟิลด์ในเรคคอร์ดโดเมนที่มีอยู่ ตัวกรองในรายการที่มีอยู่ และการแยกอ่านง่ายในรายงานที่มีอยู่ ข้อมูลชุดเดียวกันจะใช้ผ่าน Public API และ MCP ได้ด้วย
การตัดสินใจนั้นกำหนดรูปฟีเจอร์ เรากำลังสร้างการคัดรอบแรกที่ดีขึ้นผ่านสินค้าคงคลัง ไม่ใช่ตัวแทนระบบพอร์ตของนักลงทุน
ชั้นแรกเก็บข้อเท็จจริง
คุณสมบัติบางอย่างของชื่อโดเมนไม่ต้องการโมเดลภาษา
สำหรับโดเมนระดับที่สอง Karma.Domains คำนวณ:
- ความยาวตัวอักษร;
- จำนวนตัวเลขและยัติภังค์;
- มีตัวเลขหรือยัติภังค์หรือไม่;
- แพทเทิร์นตัวอักษร;
- แพทเทิร์นสระและพยัญชนะ;
- ข้อความที่ต้น ท้าย หรือที่ใดก็ได้ในชื่อ;
- TLD
แพทเทิร์นตัวอักษรใช้ L สำหรับตัวอักษร N สำหรับตัวเลข H สำหรับยัติภังค์ และ X สำหรับตัวอื่น แพทเทิร์นสระใช้ V สำหรับสระ C สำหรับตัวอักษรละตินอื่น รวมถึง N, H และ X
ยกตัวอย่างง่าย ๆ อย่าง solar7.com แพทเทิร์นตัวอักษรคือ LLLLLN แพทเทิร์นสระคือ CVCVCN โมเดลไม่ต้อง «เข้าใจ» ชื่อเพื่อให้ได้ผลลัพธ์อย่างใดอย่างหนึ่ง
แพทเทิร์นมีประโยชน์เป็นพิเศษเมื่อรูปของสินทรัพย์สำคัญ นักลงทุนที่หาชื่อสี่ตัวอักษรสามารถกรอง LLLL คนที่ค้นหาชุดห้าตัวอักษรที่ออกเสียงได้สามารถใช้แพทเทิร์นสระอย่าง CVCVC แล้วค่อยใส่ตัวกรองภาษาหรือประเภทชื่อ
ฟิลด์เหล่านี้คาดเดาได้ รันตัวกรองเดิมพรุ่งนี้ ผลเชิงโครงสร้างจะไม่เปลี่ยนเพียงเพราะโมเดลตีความชื่อต่างไป
การนับคำกลายเป็นปัญหาของ AI
การนับคำฟังดูเหมือนข้อเท็จจริงอีกอย่าง แต่ไม่ใช่ อย่างน้อยก็ไม่ใช่กับโดเมนที่ไม่มีช่องว่าง
ก่อนจะบอกว่าชื่อมีสองคำ เราต้องตัดสินว่าคำหนึ่งจบและคำถัดไปเริ่มที่ไหน Eightshapes น่าจะหมายถึง «eight shapes» สตริงที่ผสมภาษา นามสกุล และตัวย่ออาจรองรับการตัดหลายแบบที่สมเหตุสมผล แบรนด์ที่แต่งขึ้นอาจดูเหมือนสองชิ้นส่วนที่คุ้นเคย แม้การอ่านที่ตั้งใจจะเป็นคำเดียวที่สร้างขึ้น
นี่คือเหตุผลที่ตัวกรองนับคำอยู่ในส่วนที่ AI ช่วยของระบบ มันพึ่ง tokenization และ tokenization พึ่งความหมาย
ความตระหนักเล็ก ๆ นี้เปลี่ยนสถาปัตยกรรม เราเลิกมองทุกฟิลด์ที่ดูเป็นตัวเลขว่าเป็น deterministic
ชั้นที่สองตีความชื่อ
โมเดลได้รับชื่อโดเมนและ TLD ขณะจัดประเภทชื่อ มันไม่เห็นเมตริกแบ็คลิงก์ ความนิยมในการประมูล ประมาณการทราฟฟิก หรือ KarmaScore เราต้องการให้ผลลัพธ์อธิบายสตริง ไม่ใช่ไปหาเหตุผลให้สัญญาณจากส่วนอื่นของรายงาน
การวิเคราะห์พยายามระบุ:
- คำที่อยู่ในชื่อ;
- ภาษาที่เป็นไปได้ของแต่ละคำ;
- ความหมายสั้น ๆ;
- ประเภทหลักหนึ่งอย่าง เช่น dictionary word, descriptive phrase, personal name หรือ brandable;
- ประเภทเพิ่มเติมเมื่อเหมาะสม รวม geographic, acronym และ EMD;
- อุตสาหกรรมกว้างหนึ่งหรือหลายอย่าง;
- วลีเชิงพาณิชย์เมื่อชื่อดูเหมือน exact-match domain;
- ระดับความมั่นใจโดยรวม
เราใช้หมวดอุตสาหกรรมกว้าง 17 หมวด จงใจหยาบ «Software» หรือ «real estate» ช่วยบีบรายการใหญ่ได้ โมเดลที่แต่งแผนธุรกิจเฉพาะเจาะจงมากจากตัวอักษรหกตัว ไม่ช่วย
ความยับยั้งชั่งใจเดียวกันใช้กับประเภทชื่อ ประเภทหลักต้องมีอันเดียว ชื่อจะเป็นทั้ง descriptive phrase ที่ชัดและ brandable ที่แต่งขึ้นพร้อมกันเพียงเพราะโมเดลอยากกันความเสี่ยงไม่ได้ Geographic, acronym และ EMD ทำงานเป็นแอตทริบิวต์เพิ่ม เพราะตอบคำถามต่างกัน
บนกระดาษดูตรงไปตรงมา การทดสอบแรกไม่เป็นเช่นนั้น
โมเดลมั่นใจกับการตัดที่แย่
ข้อผิดพลาดที่พบบ่อยที่สุดคือการแบ่งคำ
โมเดลอาจปล่อย compound ที่ชัดอย่าง eightshapes ให้ติดกัน ในชื่ออื่นมันสร้างการตัดแบบ cop + salive ทั้งที่โทเคนที่สองไม่มีความหมาย สตริงหลายภาษาสร้างปัญหาของตัวเอง ชื่ออย่าง vuelostime ชวนให้อ่านแบบสเปนและอังกฤษแข่งกัน และโมเดลอาจกระโดดไปมาระหว่างทั้งสองโดยไม่ยอมรับความคลุมเครือ
การตรวจภาษาสร้างคลาสข้อผิดพลาดอีกชุด เวอร์ชันแรกอนุมานภาษาจาก TLD มองตัวอักษรละตินเป็นหลักฐานของอังกฤษ หรือสับสนชื่อสถานที่กับภาษา อักษรย่อบางครั้งถูกขยายโดยไม่มีหลักฐาน ป้ายอุตสาหกรรมทวีคูณเมื่อคำมีความเชื่อมโยงอ่อนกับหลายตลาด
การจัดประเภท EMD ส่ายไปทั้งสองทาง พรอมต์แคบพลาดวลีเชิงพาณิชย์ที่มีประโยชน์ พรอมต์กว้างขึ้นเริ่มเรียกเกือบทุกชุดคำเชิงบรรยายว่า exact-match domain
เราลองหลายตระกูลโมเดล บางตัวคืนข้อมูลมีโครงสร้างที่เสียหรือถูกตัด โมเดลที่เร็วกว่ามักกระจายอุตสาหกรรมตามความเชื่อมโยงอ่อน โมเดลหนึ่งวิเคราะห์ภาษาได้ดีกว่าชัดเจนในชุดทดสอบ แต่ช้าและแพงเกินสำหรับปริมาณที่ต้องประมวลผล
การเพิ่ม temperature ไม่ช่วย นี่คือข้อผิดพลาดเชิงระบบ ไม่ใช่การขาดความคิดสร้างสรรค์
การเปลี่ยนแปลงหนึ่งอย่างช่วยชื่อที่ยาก: ให้โมเดลสร้างความหมายทั่วไปก่อน ค่อยปิดการตัดคำ บน thegeoffcapesfoundation บริบทเชิงความหมายช่วยให้ได้ the / geoff / capes / foundation มันไม่ได้แก้ทุกกรณีหลายภาษาหรือคลุมเครือ แต่ให้จุดเริ่มต้นที่ดีกว่ากับ tokenization
ชุดทดสอบเริ่มประจบเรา
ช่วงหนึ่งเราใส่โดเมนที่ยากหลายชื่อและคำตอบที่ถูกต้องลงในพรอมต์เป็นตัวอย่าง การประเมินรอบถัดไปดูดีขึ้นมาก
ดีเกินไป
เรากำลังทดสอบโดเมนชุดเดิมซ้ำ ๆ พรอมต์ได้รับคำตอบไปแล้วโดยพฤตินัย มันสามารถทำซ้ำกรณีเหล่านั้นโดยไม่เรียนรู้กฎที่ถ่ายโอนไปยังสินค้าคงคลังใหม่ได้
เราเอาตัวอย่างเฉพาะโดเมนออก แล้วเขียนใหม่เป็นคำสั่งทั่วไป คะแนนตกลง นั่นมีประโยชน์ เพราะผลที่ต่ำกว่านั้นซื่อสัตย์
นี่อาจเป็นบทเรียนการพัฒนาที่สำคัญที่สุดของโปรเจกต์ พรอมต์อาจดูยอดเยี่ยมเมื่อชุดทดสอบรั่วเข้าไปข้างใน ชื่อโดเมนทำให้พลาดข้อผิดพลาดนี้ได้ง่าย เพราะทุกสตริงที่ยุ่งยากรู้สึกเหมือนเคสพิเศษที่ควรใส่เป็นตัวอย่าง
หลังจากนั้นเราตัดสินการเปลี่ยนแปลงจากชื่อที่ไม่เคยเห็น โดยให้ความสนใจพิเศษกับสตริงหลายภาษา compound ยาว ชื่อบุคคล อักษรย่อ และวลีที่ตัดได้หลายทาง
การควบคุมในโปรดักชันสำคัญกว่าพรอมต์
เราปรับปรุงพรอมต์ต่อไป แต่งานพรอมต์ในที่สุดก็เจอผลตอบแทนที่ลดลง มาตรการป้องกันในโปรดักชันทำให้ฟีเจอร์น่าเชื่อถือมากกว่า
แบ็กเอนด์ตรวจว่าทุกโทเคนสามารถต่อกลับเป็นชื่อเดิมได้ โมเดลเพิ่มตัวอักษร ตัดตัวอักษร หรือ «แก้» การสะกดเงียบ ๆ ไม่ได้ หากการตัดไม่ผ่านการตรวจสอบ ระบบจะถอยกลับไปใช้การแทนค่าที่ปลอดภัยกว่า
สคีมาอนุญาตประเภทหลักเพียงอันเดียว ซึ่งกันคำตอบขัดแย้งในฟิลด์นั้น การวิเคราะห์ที่หายไปยังคงเป็น unknown เราไม่แปลงการจัดประเภทที่ยังไม่ประมวลผลหรือล้มเหลวเป็น «no» ปลอม ในอินเทอร์เฟซ ตัวกรองจาก AI และแผงจัดประเภทมีคำเตือนว่าผลอาจไม่แม่นยำ
แนวทางนี้ยอมรับข้อเท็จจริงที่ไม่สบายใจ: บางชื่อคลุมเครือ และโมเดลจะผิดบ้าง การควบคุมกันไม่ให้คำตอบแปลกกลายเป็นโครงสร้างเสียหรือความมั่นใจปลอม
นักลงทุนยังหาผู้สมัครที่พลาดไปได้ด้วยตัวกรองข้างเคียง ระบบไม่ควรทำให้การอนุมานที่น่าสงสัยหายไปหลังคะแนนที่มั่นใจ
สี่วิธีที่ฉันจะใช้ตัวกรองใหม่
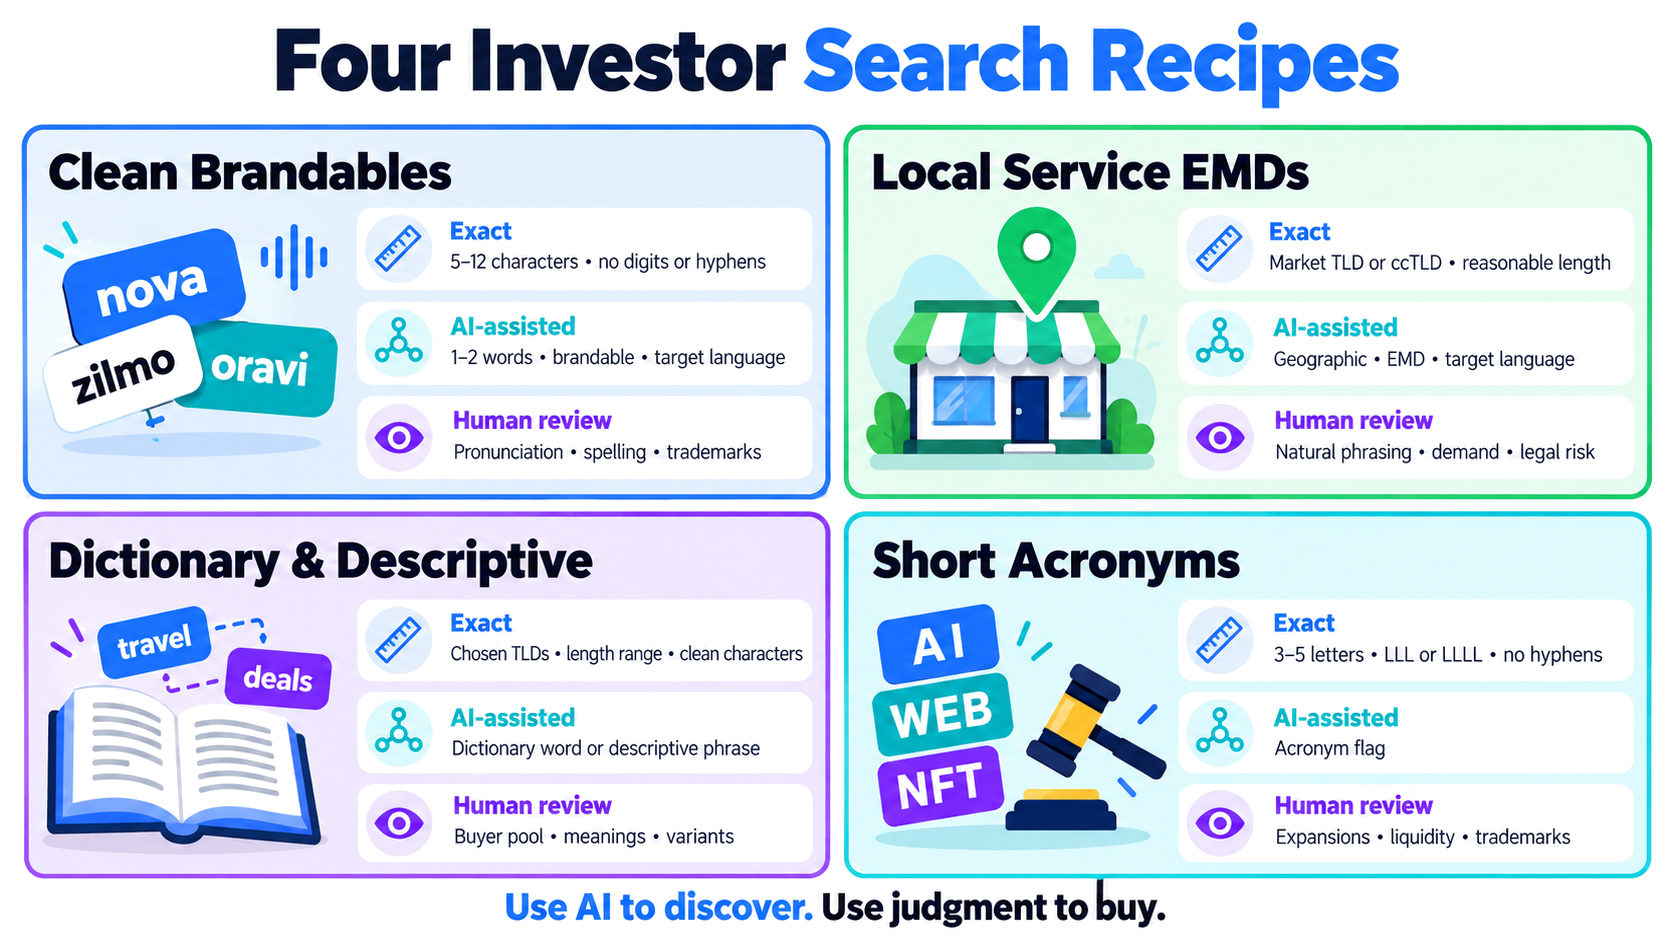
คุณค่าเชิงปฏิบัติปรากฏเมื่อโครงสร้างที่แม่นและการจัดประเภทเชิงความหมายทำงานร่วมกัน นี่คือสูตรเริ่มต้นสี่แบบ ช่วงตัวเลขเป็นตัวอย่าง ไม่ใช่กฎซื้อสากล
| กลยุทธ์ | ตัวกรองเชิงโครงสร้าง | ตัวกรองที่ AI ช่วย | ตรวจทานด้วยมือ |
|---|---|---|---|
| Brandable สะอาด | 5–12 ตัวอักษร ไม่มีตัวเลขหรือยัติภังค์ TLD ที่เลือก | หนึ่งหรือสองคำ brandable ภาษาเป้าหมาย อุตสาหกรรมที่เกี่ยวข้อง | การออกเสียง การสะกด radio test ยอดขายเทียบเคียง เครื่องหมายการค้า |
| EMD บริการท้องถิ่น | TLD ตลาดหรือ ccTLD ความยาวสมเหตุสมผล ชิ้นส่วน geo หรือบริการที่ต้องการ | Geographic, EMD ภาษาเป้าหมาย อุตสาหกรรมบริการ | วลีธรรมชาติ พฤติกรรมการค้นหาจริง อุปสงค์ท้องถิ่น ความเสี่ยงทางกฎหมาย |
| ชื่อพจนานุกรมและเชิงบรรยาย | TLD ที่เลือก ช่วงความยาว ไม่มีตัวอักษรไม่พึงประสงค์ | Dictionary word หรือ descriptive phrase ภาษา อุตสาหกรรม | กลุ่มผู้ซื้อ ความหมายทางเลือก รูปพหูพจน์ รูปแบบการสะกด |
| อักษรย่อสั้น | สามถึงห้าตัวอักษร แพทเทิร์นอย่าง LLL หรือ LLLL ไม่มียัติภังค์ | ธง acronym และบริบทภาษาเมื่อมี | การขยายที่สมเหตุสมผล องค์กรที่มีอยู่ สภาพคล่อง เครื่องหมายการค้า |
Brandable สะอาด
ฉันจะเริ่มจากสิ่งที่โมเดลอ่านผิดไม่ได้: TLD ความยาว ตัวเลข ยัติภังค์ และแพทเทิร์น แล้วค่อยเพิ่มข้อจำกัดเชิงความหมายหนึ่งหรือสองอย่าง เช่น brandable บวก software
ถ้ารายการเล็กเกินไป ให้ผ่อนฟิลด์เชิงความหมายก่อนกฎโครงสร้างที่กำหนดกลยุทธ์ อุตสาหกรรมติดป้ายผิดอาจซ่อนชื่อดี โดเมน 19 ตัวอักษรจะไม่กลายเป็น brandable หกตัวเพียงเพราะตัวจัดประเภทชอบมัน
ชื่อบริการท้องถิ่น
ชุด geo-service ได้ประโยชน์จากตัวกรองเชิงความหมายมากกว่า เพราะลำดับและภาษาของวลีสำคัญ ค้นหาธง geographic และ EMD แล้วตรวจ tokenization กับความหมายจริงในรายงาน
โมเดลอาจรู้ว่ามีเมืองและบริการ มันบอกไม่ได้ว่าลูกค้าท้องถิ่นจะพูดวลีนี้ตามธรรมชาติหรือไม่ ว่าอุปสงค์การค้นหาคุ้มค่าเชิงพาณิชย์หรือไม่ หรือว่าตลาดอิ่มตัวแล้วหรือยัง
คำพจนานุกรมและวลีเชิงบรรยาย
ภาษาเป็นตัวกรอง discovery ที่มีประโยชน์ที่นี่ โดยเฉพาะข้าม ccTLD แต่ก็ควรสงสัย คำสั้นอาจมีในหลายภาษา และชื่อเฉพาะมักคล้ายคำพจนานุกรม
ก่อนรับประเภท ฉันจะดูการแยกคำสีในรายงาน การตัดแบบมองเห็นได้ทำให้จับการตีความที่น่าสงสัยง่ายกว่าป้ายเปล่าในตาราง
อักษรย่อ
รอบโครงสร้างทำงานส่วนใหญ่กับอักษรย่อสั้น ธง AI ช่วยแยกอักษรย่อที่เป็นไปได้จากคำสั้นธรรมดา แต่ไม่รู้ทุกองค์กร ผลิตภัณฑ์ หรือตัวย่อเฉพาะกลุ่ม
สำหรับกลยุทธ์นี้ false positive ราคาถูก ความผิดพลาดเรื่องเครื่องหมายการค้าไม่ใช่ เก็บเกณฑ์ AI กว้าง และทำให้การตรวจกฎหมายกับผู้ใช้ปลายทางเข้มงวด
รายงานสนับสนุนการตัดสินใจอย่างไร
แท็บ Domain name ในรายงาน Karma.Domains แสดงทั้งสองชั้นแยกกัน
ส่วน Structure มีการวัด: ความยาว ตัวเลข ยัติภังค์ แพทเทิร์นตัวอักษร และแพทเทิร์นสระ ส่วน Classification แสดงการตัดคำที่เสนอ ความหมาย ประเภท ภาษา อุตสาหกรรม วลี EMD จำนวนคำ และความมั่นใจ
เรายังใช้การตัดคำที่ผ่านการตรวจสอบเพื่อแสดงเวอร์ชัน CamelCase ที่อ่านง่ายของโดเมน การคัดลอกชื่อยังได้โดเมนตัวพิมพ์เล็กเดิม เวอร์ชันจัดรูปแบบมีไว้ให้สแกนรายการง่ายขึ้น ไม่ใช่เพื่อเปลี่ยนสินทรัพย์
Brand Score อยู่ในบริเวณเดียวกันเพื่อความสะดวก แต่ยังเป็นสัญญาณของตัวเอง การวิเคราะห์ชื่อไม่ได้ดูดมันเข้าไปในตัวเลขหลักใหม่
ถ้าคุณตรวจโดเมนเพียงไม่กี่สิบชื่อต่อเดือน ส่วนใหญ่ของสิ่งนี้อาจไม่จำเป็น คุณอ่านชื่อเองได้ ตัวกรองมีประโยชน์เมื่อรายการดิบมีผู้สมัครเป็นพัน หรือเมื่อหลายคนต้องใช้ทฤษฎีพอร์ตเดียวกันอย่างสม่ำเสมอ
ฟิลด์เดียวกันใช้ได้ข้างนอกเบราว์เซอร์
เราสร้างฟีเจอร์เข้าชั้นค้นหาที่มีอยู่ ดังนั้นฟิลด์ชื่อใช้ได้ผ่านเว็บอินเทอร์เฟซ Public API ของ Karma.Domains และเซิร์ฟเวอร์ MCP ของ Karma.Domains
ในเว็บแอป นักลงทุนรวมฟิลด์ใหม่กับแหล่งประมูล ราคาปัจจุบัน เวลาสิ้นสุด TLD ประวัติ และตัวกรอง SEO ได้
API รองรับการค้นหาที่ทำซ้ำได้ในแดชบอร์ดส่วนตัว ท่อสเปรดชีต หรือ workflow พอร์ต นักลงทุนเก็บทฤษฎีเป็นพารามิเตอร์คิวรี แล้วรันกับสินค้าคงคลังใหม่โดยไม่ต้องประกอบหน้าจอใหม่ทุกครั้ง
MCP เปิดการค้นหาเดียวกันให้ ChatGPT, Claude และผู้ช่วยที่เข้ากันได้อื่น คำขออาจเป็นการสนทนา:
หาชื่อประมูล
.comสั้น ๆ ที่ไม่มีตัวเลขหรือยัติภังค์ คงชื่ออังกฤษหนึ่งหรือสองคำที่จัดเป็น brandable ใน software หรือ finance แสดงการแยกชื่อและรายละเอียดประมูล
ข้อความถัดไปปรับทฤษฎีได้:
คงกฎโครงสร้าง เอา finance ออก และรวม descriptive phrase ที่สั้นกว่าสิบตัวอักษร
ภาษากลธรรมชาติทำให้วนซ้ำง่ายขึ้น แต่ตัวกรองข้างล่างยังเป็นผู้ทำการค้นหาจริง
จุดที่ระบบอัตโนมัติหยุด
การวิเคราะห์ชื่อไม่ประมาณราคาขาย ไม่ทำนายอัตรา sell-through และไม่อนุมัติการซื้อ มันไม่แทนที่การตรวจเครื่องหมายการค้า การตัดสินของเจ้าของภาษา การวิเคราะห์ยอดขายเทียบเคียง หรือการดูคลังเก็บและประวัติแบ็คลิงก์อย่างใกล้ชิด
มันก็ไม่รู้ต้นทุนถือครองของคุณ ตลาดที่ชอบ ความทนต่อสภาพคล่องต่ำ หรือการเข้าถึงผู้ซื้อที่เป็นไปได้ ตัวแปรเหล่านี้มักสำคัญกว่าสัญญาณพิเศษหนึ่งอย่างในรายงาน
workflow ที่ฉันชอบเรียบง่าย ใช้ตัวกรอง deterministic กำหนดรูปสินทรัพย์ เพิ่มฟิลด์ AI เพื่อสำรวจความหมายและบริบทเชิงพาณิชย์ เปิดรายงานของกลุ่มเล็กที่รอด แล้วตรวจประวัติ ลิงก์ ความเสี่ยงทางกฎหมาย ยอดขายเทียบเคียง และเงื่อนไขประมูลปัจจุบันก่อนวางบิด
ฟีเจอร์มีที่ยืนเมื่อเปลี่ยน 10,000 ชื่อให้เหลือ 40 ชื่อที่คุ้มอ่าน การเลือกสี่ชื่อที่คุ้มซื้อยังเป็นงานของนักลงทุน