
Twee domeinen kunnen vergelijkbare SEO-metrics hebben en toch een heel ander investeringspotentieel. We bouwden domeinnaamanalyse in Karma.Domains om investeerders die gevallen te laten scheiden voordat het dure, handmatige deel van due diligence begint.
Inhoudsopgave
- Inhoudsopgave
- Ik wilde geen nieuwe appraisal-score
- We bouwden bijna te veel
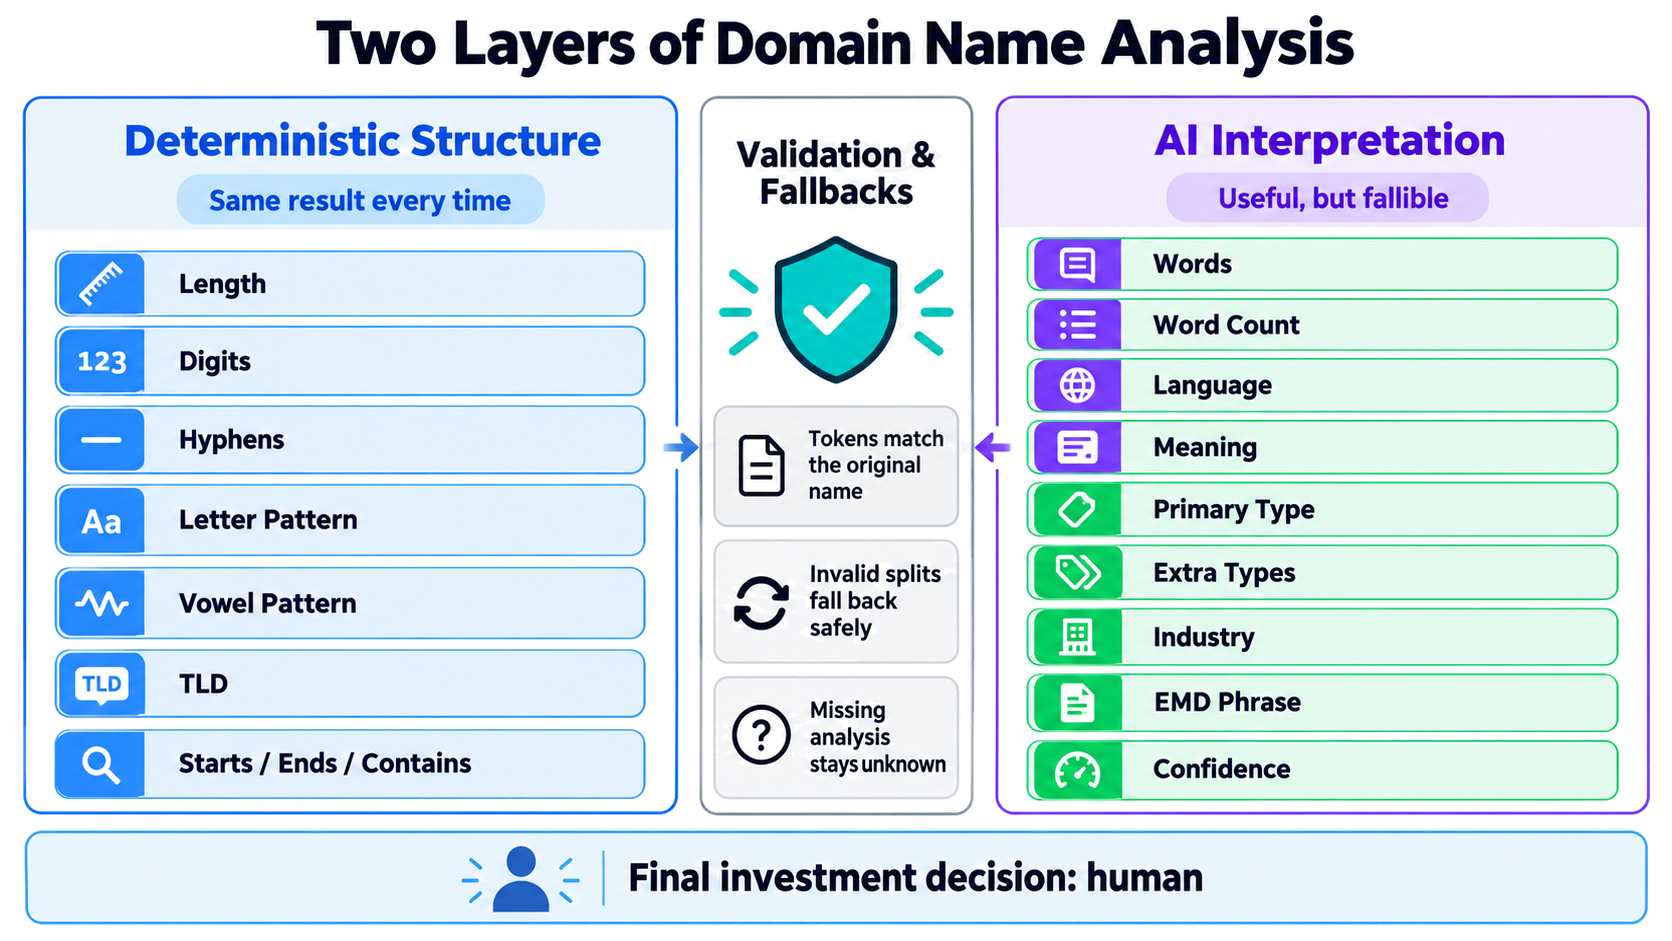
- De eerste laag bevat feiten
- Woordtelling bleek een AI-probleem
- De tweede laag interpreteert de naam
- Het model was zelfverzekerd over slechte splits
- Onze testset begon ons te vleien
- Productiecontroles telden meer dan de prompt
- Vier manieren waarop ik de nieuwe filters zou gebruiken
- Hoe het report de beslissing ondersteunt
- Dezelfde velden werken buiten de browser
- Waar de automatisering stopt
Terwijl ik veiling- en expired-domainlijsten in Karma.Domains doorkeek, liep ik steeds tegen dezelfde leemte aan. Onze reports konden me veel vertellen over het verleden van een domein: wat er vroeger op de site stond, welke onderwerpen in het archief voorkwamen, of het backlinkprofiel duidelijk risico toonde, en welke SEO-signalen beschikbaar waren.
Over de naam zelf zei het report veel minder.
Dat onderscheid telt voor een domeininvesteerder. Een schone tweewoordige commerciële naam en een onhandige aaneenschakeling van fragmenten kunnen naast elkaar staan met vergelijkbare authority-metrics. De ene is makkelijk uit te spreken, makkelijk te onthouden en nuttig voor verschillende soorten kopers. De andere heeft misschien helemaal geen plausibele eindgebruiker.
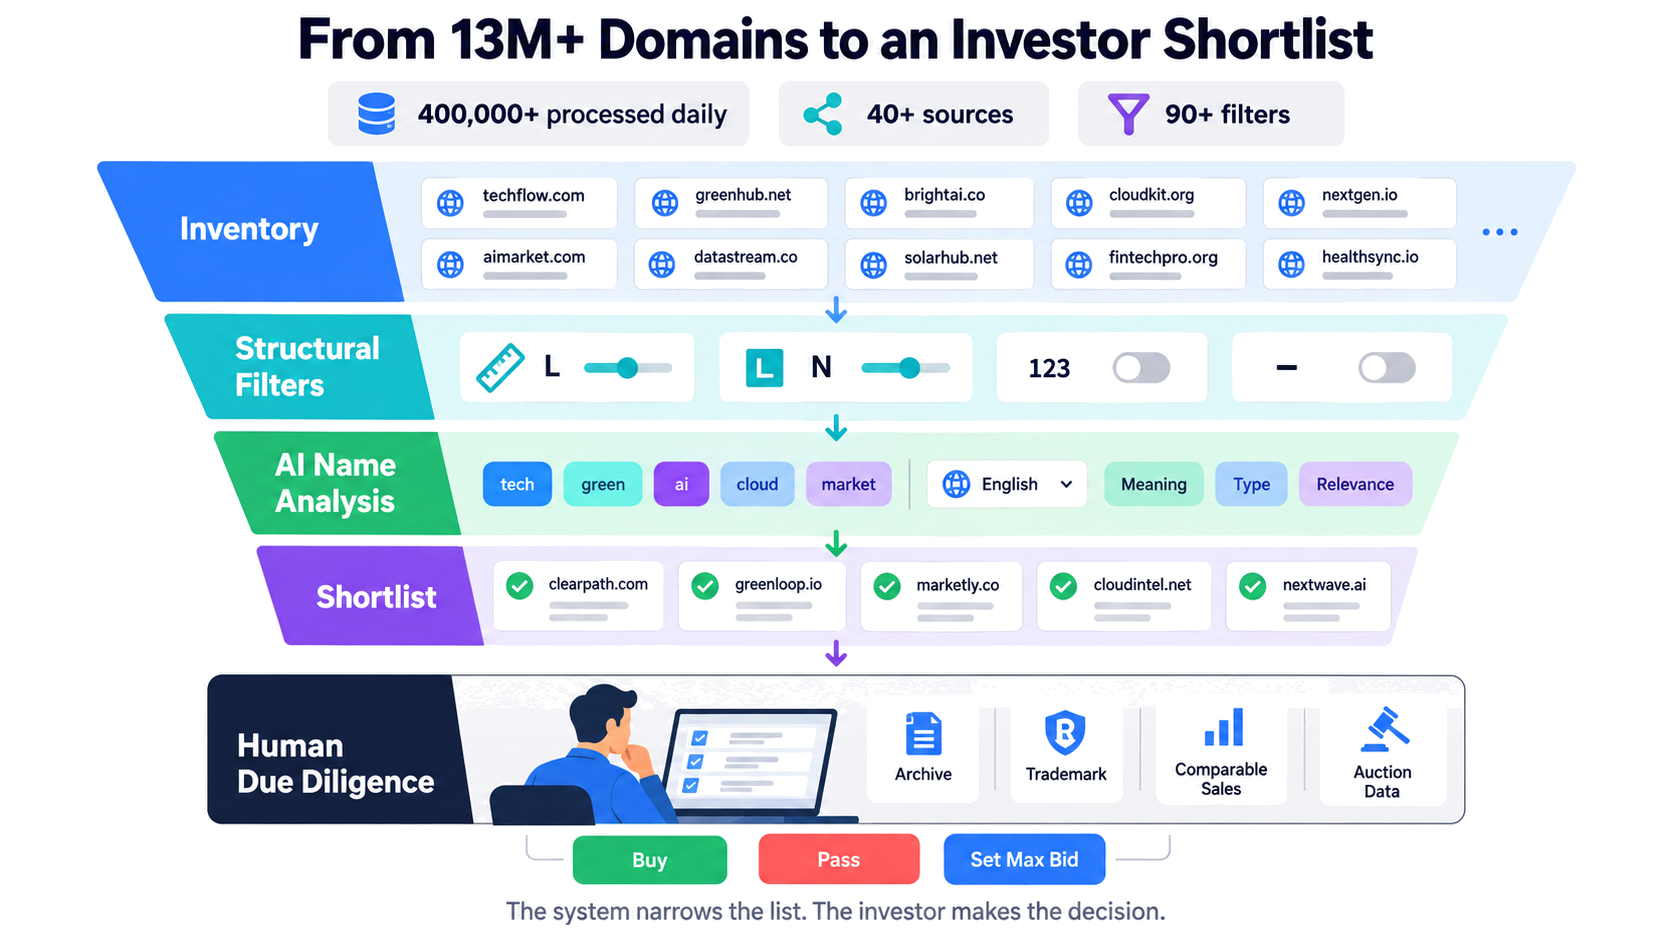
Toen onze database de grens van 13 miljoen expired- en veilingdomeinen passeerde, met meer dan 400.000 domeinen per dag uit 40+ bronnen, werd die blinde vlek moeilijker te negeren. Karma.Domains ondersteunde al 90+ filters en combineerde beschikbare data van Ahrefs, Semrush, Moz, Majestic, Similarweb, de Wayback Machine en andere bronnen. Investeerders konden geschiedenis en SEO-signalen gedetailleerd screenen. Duizenden namen moesten ze nog steeds één voor één lezen.
Dus bouwden we een nieuwe laag voor de vraag die elke domainer eerst stelt: is de naam een nadere blik waard?
Ik wilde geen nieuwe appraisal-score
Het voor de hand liggende productidee was één getal voor „investeringskwaliteit”. Ik wees het vroeg af.
Een domein heeft geen universele waarde buiten een koper, een markt, een verkoophorizon en een strategie. Een investeerder die zich specialiseert in korte acroniemen ziet een ander asset dan iemand die een portfolio van lokale servicedomeinen opbouwt. Een natuurlijke zin in het Nederlands kan zinloos lijken voor een model dat alleen Engels kent. Een sterke geo-servicenaam kan nuttig zijn voor leadgeneratie en irrelevant voor een brandable-marketplace.
Eén score zou die aannames verbergen. Erger nog: het zou een subjectieve modeluitkomst precies laten lijken.
Karma.Domains heeft al een Brand Score, en die hielden we apart. De nieuwe analyse legt het bewijs bloot waarop je wilt filteren: structuur, woorden, taal, naamtype, branche en mogelijke exact-match-intentie. De strategie levert de investeerder.
Mijn mening hier is vrij stellig: appraisal is de verkeerde abstractie voor de discoveryfase. Discovery moet de stapel verkleinen en tegelijk de redenen bewaren waarom een naam overbleef.
We bouwden bijna te veel
Onze eerste productvisie was veel groter. Die omvatte investeerder-specifieke views, projecten, een inbox, een dealpipeline, monitoring en nog meer workflowfuncties.
De meeste van die ideeën kunnen nog steeds nuttig zijn. Ze waren ook een goede manier om maanden aan een apart product te besteden voordat bewezen was dat investeerders de onderliggende analyse wilden.
We sneden de scope terug. De eerste release zou leven in de zoek- en report-ervaring die mensen al gebruikten. Velden bij het bestaande domeinrecord, filters bij de bestaande lijst, een leesbare uitsplitsing bij het bestaande report. Dezelfde data ook via Public API en MCP.
Die beslissing vormde de feature. We bouwden een betere eerste pass door inventaris – geen vervanging van een portfoliosysteem.
De eerste laag bevat feiten
Sommige eigenschappen van een domeinnaam hebben geen taalmodel nodig.
Voor het second-level domain berekent Karma.Domains:
- tekenlengte;
- aantal cijfers en koppeltekens;
- of cijfers of koppeltekens aanwezig zijn;
- een letterpatroon;
- een klinker- en medeklinkerpatroon;
- tekst aan het begin, einde of ergens in de naam;
- de TLD.
Het letterpatroon gebruikt L voor een letter, N voor een cijfer, H voor een koppelteken en X voor een ander teken. Het klinkerpatroon gebruikt V voor een klinker, C voor een andere Latijnse letter, plus N, H en X.
Neem solar7.com als eenvoudig voorbeeld. Het letterpatroon is LLLLLN. Het klinkerpatroon is CVCVCN. Geen model hoeft de naam te „begrijpen” om een van beide resultaten te leveren.
Patronen zijn vooral nuttig wanneer de vorm van het asset telt. Wie vierletterige namen zoekt, kan op LLLL filteren. Wie uitspreekbare vijflettercombinaties onderzoekt, kan met klinkerpatronen zoals CVCVC werken en daarna een taal- of naamtypefilter toepassen.
Deze velden zijn voorspelbaar. Voer morgen dezelfde filter uit – het structurele resultaat verandert niet omdat een model de naam anders interpreteerde.
Woordtelling bleek een AI-probleem
Woordtelling klinkt als nog een feit. Dat is het niet – in ieder geval niet voor een domein zonder spaties.
Voordat we kunnen zeggen dat een naam twee woorden bevat, moeten we beslissen waar het ene eindigt en het volgende begint. Eightshapes betekent waarschijnlijk „eight shapes”. Een string die talen, een achternaam en een afkorting mengt, kan meerdere redelijke splitsen toelaten. Een verzonnen merk kan op twee bekende fragmenten lijken, terwijl de bedoelde lezing één bedacht woord is.
Daarom hoort de woordtellingsfilter bij het AI-ondersteunde deel van het systeem. Die hangt af van tokenisatie, en tokenisatie hangt af van betekenis.
Dat kleine inzicht veranderde de architectuur. We stopten ermee elk veld dat numeriek leek als deterministisch te behandelen.
De tweede laag interpreteert de naam
Het model ontvangt de domeinnaam en TLD. Tijdens classificatie ziet het geen backlinkmetrics, veilingpopulariteit, traffic-schattingen of KarmaScore. We wilden dat het resultaat de string beschrijft, niet signalen uit andere delen van het report rationaliseert.
De analyse probeert te identificeren:
- de woorden in de naam;
- de waarschijnlijke taal van elk woord;
- een korte betekenis;
- één primair type, zoals dictionary word, descriptive phrase, personal name of brandable;
- aanvullende types waar van toepassing, waaronder geographic, acronym en EMD;
- één of meer brede branches;
- een commerciële frase wanneer de naam een exact-match domain lijkt;
- een algeheel confidenceniveau.
We gebruiken 17 brede branchecategorieën. Ze zijn bewust grof. „Software” of „real estate” helpen een grote lijst te vernauwen. Een model dat uit zes letters een uiterst specifiek businessplan verzint, niet.
Dezelfde terughoudendheid geldt voor naamtypes. Een primair type moet enkelvoudig zijn. Een naam kan niet tegelijk een duidelijke descriptive phrase en een coined brandable zijn alleen omdat het model wil afdekken. Geographic, acronym en EMD werken als extra attributen omdat ze andere vragen beantwoorden.
Op papier leek dit rechttoe rechtaan. De eerste tests waren dat niet.
Het model was zelfverzekerd over slechte splits
De meest voorkomende fout was woordsegmentatie.
Een model liet een voor de hand liggende compound zoals eightshapes aan elkaar zitten. Bij een andere naam produceerde het een split als cop + salive, terwijl het tweede token geen zin had. Meertalige strings zorgden voor eigen problemen. Een naam als vuelostime nodigt uit tot concurrerende Spaanse en Engelse lezingen, en het model kon ertussen springen zonder de ambiguïteit toe te geven.
Taaldetectie creëerde een andere foutklasse. Vroege versies leidden een taal af uit de TLD, behandelden Latijnse tekens als bewijs voor Engels, of verwarden een plaatsnaam met een taal. Acroniemen werden soms zonder bewijs uitgebreid. Branchelabels vermenigvuldigden zich wanneer een woord een zwakke associatie met meerdere markten had.
EMD-classificatie schommelde beide kanten op. Een smalle prompt miste nuttige commerciële frasen. Een bredere noemde bijna elke descriptive combinatie een exact-match domain.
We probeerden meerdere modelfamilies. Sommige gaven kapotte of afgekapte gestructureerde data terug. Snellere modellen strooiden branches over zwakke associaties. Eén model leverde merkbaar betere linguïstische analyse op een testbatch, maar was te traag en te duur voor het volume dat we moesten verwerken.
Temperatuur verhogen hielp niet. Dit waren systematische fouten, geen gebrek aan creativiteit.
Eén verandering verbeterde moeilijke namen wel: het model eerst een algemene betekenis laten vormen voordat de woordsplit wordt afgerond. Bij thegeoffcapesfoundation hielp semantiek tot the / geoff / capes / foundation. Dat loste niet elk meertalig of ambigu geval op, maar gaf tokenisatie een beter startpunt.
Onze testset begon ons te vleien
Op een gegeven moment voegden we enkele moeilijke domeinen en hun juiste interpretaties als voorbeelden aan de prompt toe. De volgende evaluatie zag er veel beter uit.
Te veel beter.
We testten herhaaldelijk dezelfde domeinen. De prompt had effectief de antwoorden gekregen. Hij kon die gevallen reproduceren zonder een regel te leren die overdraagt naar nieuwe inventaris.
We verwijderden de domeinspecifieke voorbeelden en herschreven ze als algemene instructies. De scores daalden. Dat was nuttig, omdat het lagere resultaat eerlijk was.
Dit was waarschijnlijk de belangrijkste ontwikkelingsles van het project. Een prompt kan uitstekend lijken wanneer de testset erin lekt. Domeinnamen maken die fout makkelijk te missen, omdat elke lastige string voelt als een speciaal geval dat als voorbeeld verdient.
Daarna beoordeelden we wijzigingen op ongeziene namen, met extra aandacht voor meertalige strings, lange compounds, persoonsnamen, acroniemen en frasen die op meer dan één manier gesegmenteerd kunnen worden.
Productiecontroles telden meer dan de prompt
We bleven de prompt verbeteren, maar promptwerk stuitte uiteindelijk op afnemende meeropbrengst. De productiewaarborgen droegen meer bij aan de betrouwbaarheid van de feature.
De backend controleert dat elk token weer tot de oorspronkelijke naam kan worden samengevoegd. Het model mag geen letter toevoegen, geen teken weglaten of spelling stil „corrigeren”. Faalt de validatie van de split, dan valt het systeem terug op een veiligere representatie.
Het schema staat één primary type toe, wat tegenstrijdige antwoorden in dat veld voorkomt. Ontbrekende analyse blijft unknown. We zetten een onverwerkte of mislukte classificatie niet om in een vals „no”. In de interface dragen AI-filters en het classificatiepaneel de waarschuwing dat het resultaat onnauwkeurig kan zijn.
Deze aanpak accepteert een ongemakkelijk feit: sommige namen zijn ambigu, en het model zit er soms naast. De controles voorkomen dat een vreemd antwoord corrupte structuur of valse zekerheid wordt.
Een investeerder kan een over het hoofd gezien kandidaat nog steeds vinden via aangrenzende filters. Het systeem mag een twijfelachtige inferentie nooit laten verdwijnen achter een zelfverzekerde score.
Vier manieren waarop ik de nieuwe filters zou gebruiken
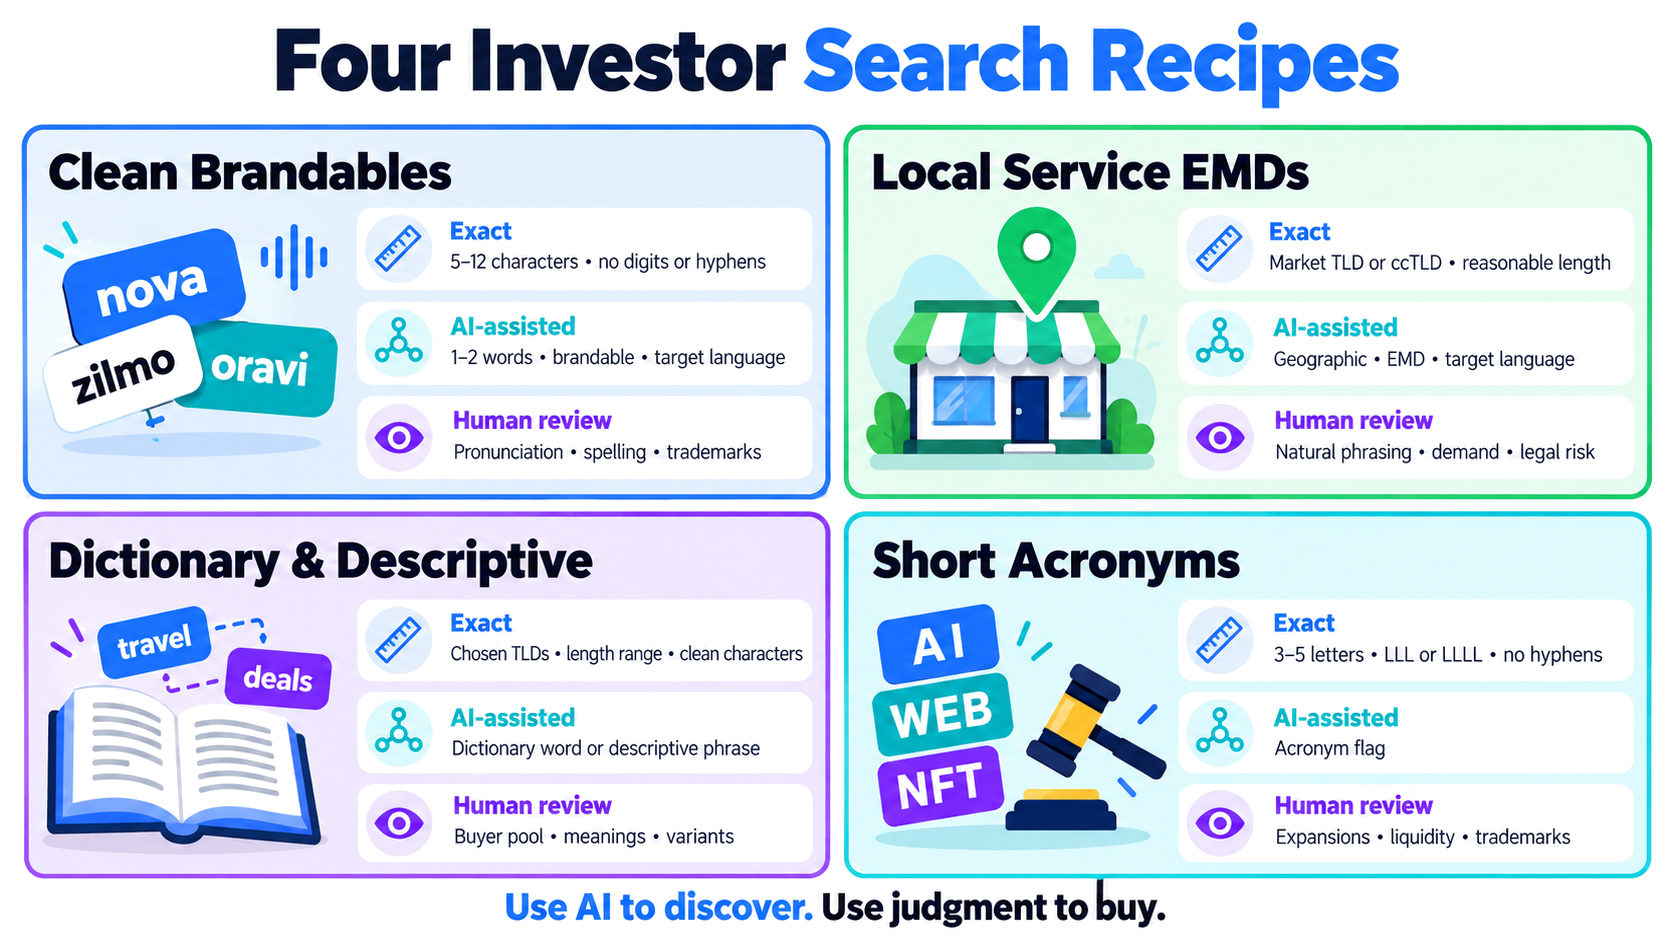
De praktische waarde verschijnt wanneer exacte structuur en semantische classificatie samenwerken. Hier zijn vier startrecepten. De bereiken zijn voorbeelden, geen universele koopregels.
| Strategie | Structurele filters | AI-ondersteunde filters | Handmatige review |
|---|---|---|---|
| Schone brandables | 5–12 tekens, geen cijfers of koppeltekens, geselecteerde TLD’s | Eén of twee woorden, brandable, doeltaal, relevante branche | Uitspraak, spelling, radiotest, vergelijkbare verkopen, merkrechten |
| Lokale service-EMD’s | Markt-TLD of ccTLD, redelijke lengte, vereist geo- of servicefragment | Geographic, EMD, doeltaal, servicebranche | Natuurlijke formulering, echt zoekgedrag, lokale vraag, juridisch risico |
| Woordenboek- en descriptive namen | Gekozen TLD’s, lengtebereik, geen ongewenste tekens | Dictionary word of descriptive phrase, taal, branche | Koperspool, alternatieve betekenissen, meervoudsvorm, spellingsvarianten |
| Korte acroniemen | Drie tot vijf letters, patronen zoals LLL of LLLL, geen koppeltekens | Acronym-flag en taalcontext waar beschikbaar | Plausibele uitbreidingen, bestaande organisaties, liquiditeit, merkrechten |
Schone brandables
Ik zou beginnen met wat het model niet verkeerd kan lezen: TLD, lengte, cijfers, koppeltekens en patroon. Daarna zou ik één of twee semantische constraints toevoegen, zoals brandable plus software.
Wordt de lijst te klein, versoepel dan eerst het semantische veld vóór de structurele regels die de strategie definiëren. Een verkeerd gelabelde branche kan een goede naam verbergen. Een domein van 19 tekens wordt geen zesletterig brandable omdat de classifier het leuk vindt.
Lokale servicenamen
Geo-servicecombinaties profiteren meer van semantische filters omdat volgorde en taal van de frase ertoe doen. Zoek op geographic- en EMD-flags en bekijk daarna de echte tokenisatie en betekenis in het report.
Een model kan herkennen dat een stad en een service aanwezig zijn. Het kan niet zeggen of een lokale klant de frase natuurlijk zou uitspreken, of de zoekvraag commercieel nuttig is, of de markt al verzadigd is.
Woordenboekwoorden en descriptive phrases
Taal is hier een nuttige discoveryfilter, vooral over ccTLD’s heen. Die verdient ook scepsis. Korte woorden bestaan in meerdere talen, en eigennamen lijken vaak op woordenboekwoorden.
Voordat ik het type accepteer, zou ik de gekleurde woorduitsplitsing in het report bekijken. De visuele split maakt een twijfelachtige interpretatie makkelijker te vangen dan een kaal label in een tabel.
Acroniemen
De structurele pass doet het meeste werk voor korte acroniemen. De AI-flag helpt waarschijnlijke initialen te scheiden van gewone korte woorden, maar kent niet elke organisatie, product of nicheafkorting.
Voor deze strategie zijn false positives goedkoop. Merkfouten zijn dat niet. Houd de AI-drempel breed en de juridische en eindgebruikerscontroles streng.
Hoe het report de beslissing ondersteunt
Het tabblad Domain name in een Karma.Domains-report toont beide lagen apart.
De sectie Structure bevat de metingen: lengte, cijfers, koppeltekens, letterpatroon en klinkerpatroon. De sectie Classification toont de voorgestelde woordsplit, betekenis, type, talen, branches, EMD-frase, woordtelling en confidence.
We gebruiken de gevalideerde woordsplit ook om een leesbare CamelCase-versie van het domein te tonen. Kopiëren geeft nog steeds het oorspronkelijke lowercase-domein. De geformatteerde versie maakt een lijst makkelijker te scannen – ze verandert het asset niet.
Brand Score staat voor het gemak in hetzelfde gebied, maar blijft een eigen signaal. De naamanalyse neemt het niet op in een nieuw mastercijfer.
Als je slechts enkele tientallen domeinen per maand bekijkt, is veel hiervan misschien overbodig. Je kunt de namen zelf lezen. De filters worden nuttig wanneer de ruwe lijst duizenden kandidaten bevat of wanneer meerdere mensen dezelfde portfoliothese consistent moeten toepassen.
Dezelfde velden werken buiten de browser
We bouwden de feature in de bestaande zoeklaag, dus de naamvelden zijn beschikbaar via de webinterface, de Karma.Domains Public API en de Karma.Domains MCP-server.
In de webapp kan een investeerder de nieuwe velden combineren met veilingsbron, huidige prijs, eindtijd, TLD, geschiedenis en SEO-filters.
De API ondersteunt herhaalbare zoekopdrachten in een privé-dashboard, spreadsheetpipeline of portfolioworkflow. Je kunt een these als queryparameters opslaan en tegen nieuwe inventaris laten lopen zonder het scherm steeds opnieuw op te bouwen.
MCP opent dezelfde zoekfunctie voor ChatGPT, Claude en andere compatibele assistenten. Een verzoek kan gesprekachtig zijn:
Zoek korte
.com-veilingnamen zonder cijfers of koppeltekens. Houd een- of tweewoordige Engelse namen die als brandable in software of finance zijn geclassificeerd. Toon de naamuitsplitsing en veilingdetails.
Het volgende bericht kan de these bijstellen:
Houd de structurele regels, verwijder finance, en neem descriptive phrases onder tien tekens op.
Natuurlijke taal maakt iteratie makkelijker. De onderliggende filters doen nog steeds de echte zoekopdracht.
Waar de automatisering stopt
De naamanalyse schat geen verkoopprijs, voorspelt geen sell-through rate en keurt geen aankoop goed. Ze vervangt geen merkonderzoek, moedertaaloordeel, analyse van vergelijkbare verkopen of een nauwkeurige blik op archief en backlinkprofiel.
Ze kent ook niet je holdingkosten, voorkeursmarktplaatsen, tolerantie voor illiquiditeit of toegang tot waarschijnlijke kopers. Die variabelen wegen vaak zwaarder dan één extra signaal in een report.
Mijn voorkeursworkflow is eenvoudig. Gebruik deterministische filters om de vorm van het asset te definiëren. Voeg AI-velden toe om betekenis en commerciële context te verkennen. Open de reports van de kleine groep die overblijft. Controleer daarna geschiedenis, links, juridisch risico, vergelijkbare verkopen en actuele veilingsvoorwaarden voordat je een bod zet.
De feature verdient haar plek wanneer ze 10.000 namen omzet in 40 die het waard zijn om te lezen. De vier die het waard zijn om te kopen kiezen, blijft het werk van de investeerder.