
Два домени можуть мати схожі SEO-метрики й зовсім різний інвестиційний потенціал. Ми зробили аналіз доменних імен у Karma.Domains, щоб допомогти інвесторам розділяти такі випадки до дорогої ручної частини due diligence.
Зміст
- Зміст
- Я не хотіла ще один appraisal-скор
- Ми майже побудували занадто багато
- Перший шар містить факти
- Підрахунок слів виявився задачею для AI
- Другий шар інтерпретує ім’я
- Модель упевнено робила погані розбиття
- Наш тестовий набір почав нам лестити
- Продакшен-контроли виявилися важливішими за промпт
- Чотири способи, як я використала б нові фільтри
- Як звіт підтримує рішення
- Ті самі поля працюють поза браузером
- Де закінчується автоматизація
Переглядаючи списки аукціонів і expired-доменів у Karma.Domains, я знову й знову натрапляла на ту саму прогалину. Наші звіти багато розповідали про минуле домену: що раніше було на сайті, які теми з’являлися в архіві, чи є в беклінк-профілі очевидний ризик і які SEO-сигнали доступні.
Про саме ім’я звіт казав набагато менше.
Для доменного інвестора це важливе розрізнення. Чисте двословне комерційне ім’я й незграбна склейка фрагментів можуть стояти поруч із схожими метриками авторитетності. Одне легко вимовити, легко запам’ятати, і воно корисне різним типам покупців. У іншого може не бути взагалі жодного правдоподібного кінцевого користувача.
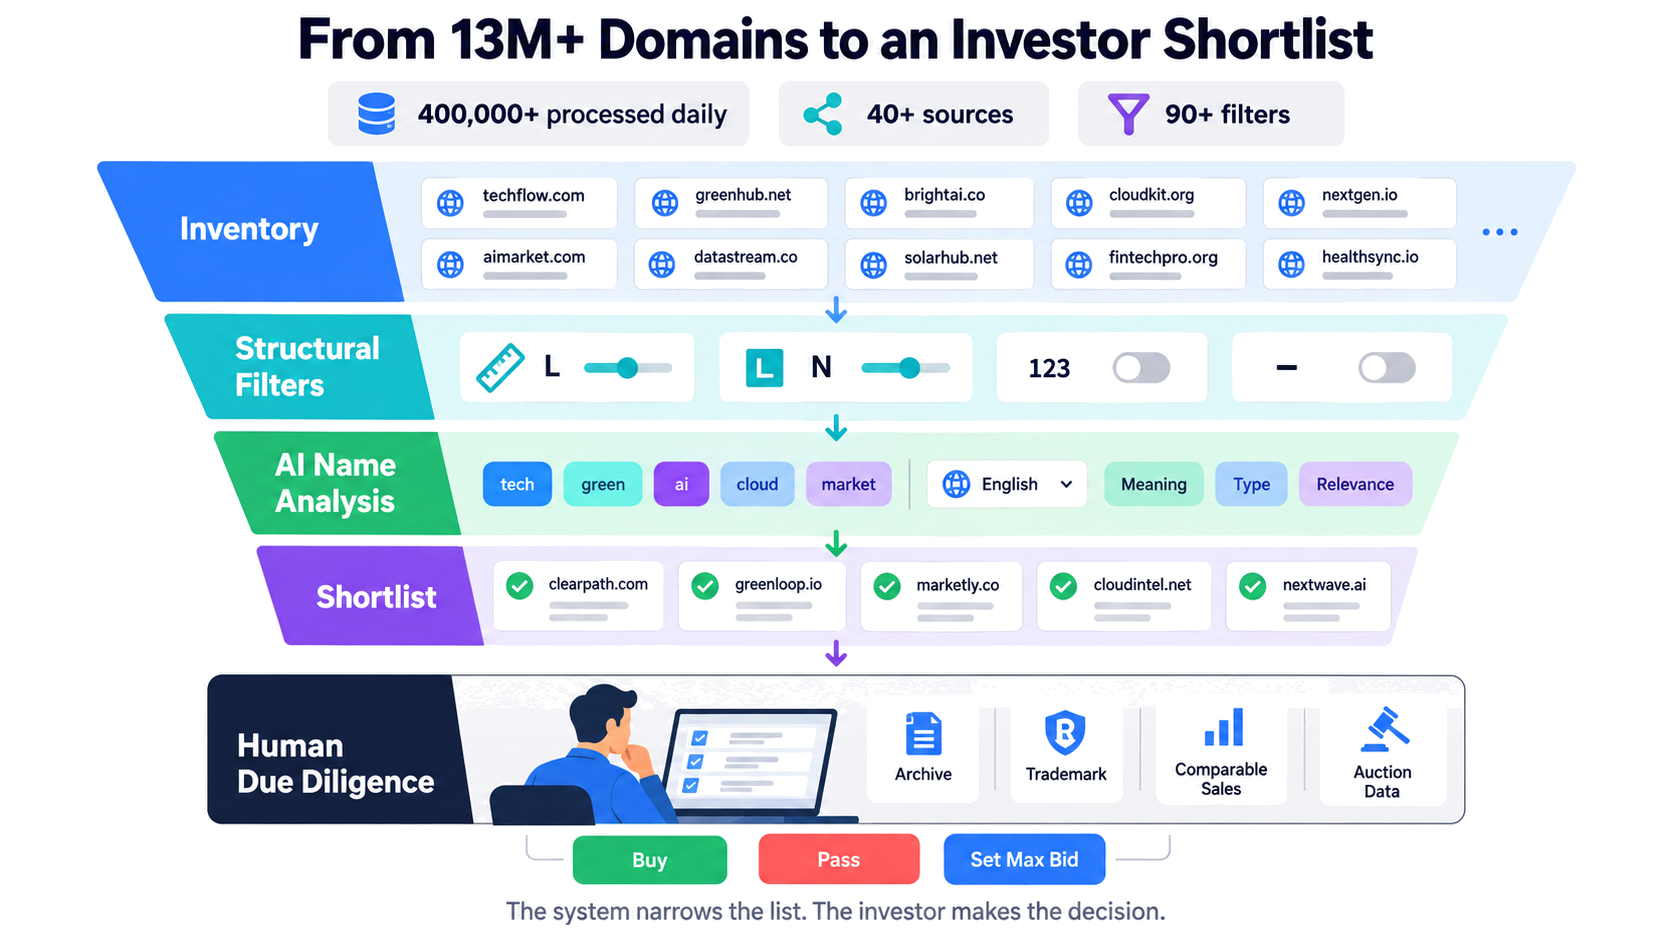
Коли наша база виросла понад 13 мільйонів expired- і аукціонних доменів, а щодня оброблялося понад 400 000 доменів із 40+ джерел, цю сліпу зону стало важче ігнорувати. Karma.Domains уже підтримував 90+ фільтрів і об’єднував доступні дані Ahrefs, Semrush, Moz, Majestic, Similarweb, Wayback Machine та інших джерел. Інвестори могли детально просіювати історію й SEO-сигнали. Але тисячі імен усе одно доводилося читати одне за одним.
Тому ми побудували новий шар під питання, яке кожен domainer ставить першим: чи варте ім’я уважнішого погляду?
Я не хотіла ще один appraisal-скор
Очевидна продуктова ідея — одне число «інвестиційної якості». Я відхилила її на ранньому етапі.
У домену немає універсальної цінності поза покупцем, ринком, горизонтом продажу й стратегією. Інвестор, який спеціалізується на коротких акронімах, бачить інший актив, ніж той, хто збирає портфель локальних сервісних доменів. Природна фраза нідерландською може виглядати безглуздою для моделі, налаштованої лише на англійську. Сильне geo-service ім’я корисне оператору лідогенерації й непотрібне для маркетплейсу брендованих імен.
Один скор приховав би ці припущення. Гірше того, він зробив би суб’єктивний висновок моделі схожим на точну величину.
У Karma.Domains уже є Brand Score, і ми залишили його окремо. Новий аналіз показує докази, за якими інвестор може фільтрувати: структуру, слова, мову, тип імені, галузь і можливий exact-match інтент. Стратегію задає сам інвестор.
Моя думка тут досить жорстка: appraisal — неправильна абстракція для стадії discovery. Discovery має зменшувати купу, зберігаючи причини, через які ім’я залишилося у вибірці.
Ми майже побудували занадто багато
Перше продуктове бачення було набагато ширшим. У ньому були інвесторські представлення, проєкти, inbox, deal pipeline, моніторинг і ще кілька workflow-функцій.
Більшість цих ідей усе ще може бути корисною. Але це також був хороший спосіб витратити місяці на окремий продукт до того, як довести, що інвесторам потрібен сам аналіз.
Ми звузили scope. Перший реліз мав жити всередині вже звичного пошуку й звіту. Додати поля в існуючу картку домену, фільтри в існуючий список і читабельну розбивку в існуючий звіт. Ті самі дані — через Public API і MCP.
Це рішення визначило фічу. Ми будували кращий перший прохід по інвентарю, а не заміну портфельній системі інвестора.
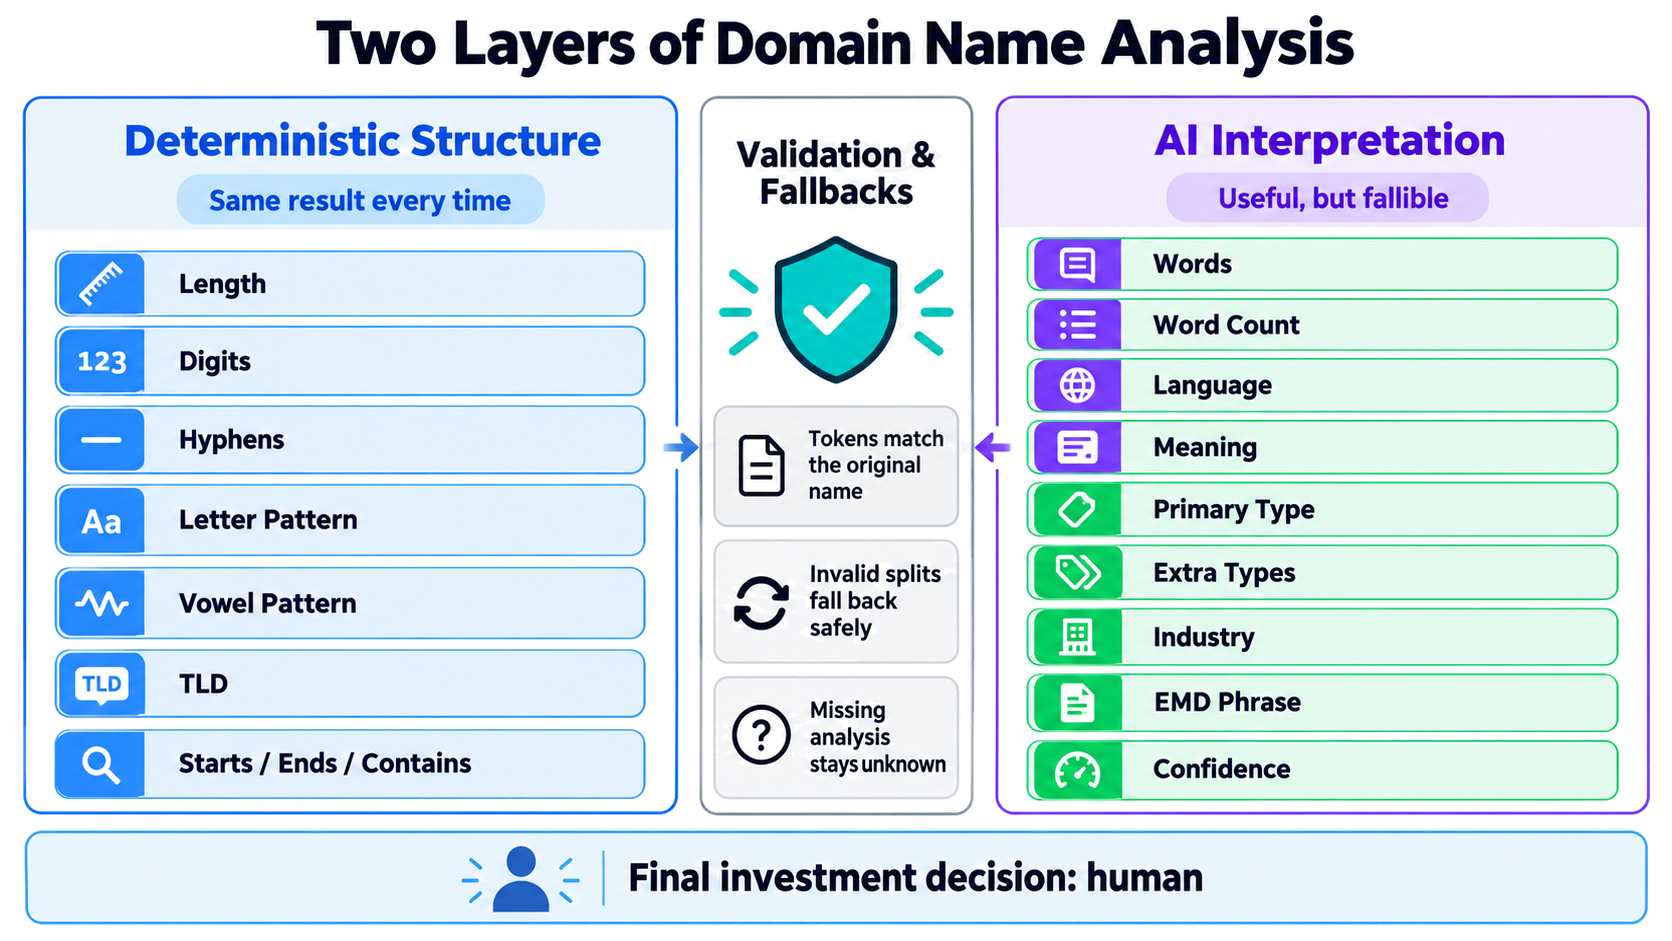
Перший шар містить факти
Деякі властивості доменного імені не потребують мовної моделі.
Для домену другого рівня Karma.Domains рахує:
- довжину в символах;
- кількість цифр і дефісів;
- наявність цифр або дефісів;
- літерний патерн;
- патерн голосних і приголосних;
- текст на початку, в кінці або в будь-якій частині імені;
- TLD.
У літерному патерні L — літера, N — цифра, H — дефіс, X — інший символ. У патерні голосних V — голосна, C — інша латинська літера, плюс N, H і X.
Візьмімо простий приклад — solar7.com. Літерний патерн: LLLLLN. Патерн голосних: CVCVCN. Моделі не потрібно «розуміти» ім’я, щоб отримати будь-який із цих результатів.
Патерни особливо корисні, коли важлива форма активу. Інвестор, який шукає чотирилітерні імена, може фільтрувати за LLLL. Той, хто досліджує вимовні п’ятилітерні комбінації, може працювати з патернами голосних на кшталт CVCVC, а потім додати фільтр за мовою або типом імені.
Ці поля передбачувані. Запустіть той самий фільтр завтра — структурний результат не зміниться через те, що модель інакше інтерпретувала ім’я.
Підрахунок слів виявився задачею для AI
Підрахунок слів звучить як ще один факт. Це не так — принаймні не для домену без пробілів.
Перш ніж сказати, що в імені два слова, потрібно вирішити, де закінчується одне й починається наступне. Eightshapes, ймовірно, означає «eight shapes». Рядок, де змішані мови, прізвище й абревіатура, може допускати кілька розумних розбиттів. Вигаданий бренд може виглядати як два знайомі фрагменти, навіть якщо задумувалося одне придумане слово.
Тому фільтр за кількістю слів належить до AI-assisted частини системи. Він залежить від токенізації, а токенізація залежить від сенсу.
Це невелике спостереження змінило архітектуру. Ми перестали вважати кожне «схоже на число» поле детермінованим.
Другий шар інтерпретує ім’я
Модель отримує доменне ім’я й TLD. Під час класифікації вона не бачить метрик беклінків, популярності на аукціоні, оцінок трафіку чи KarmaScore. Ми хотіли, щоб результат описував рядок, а не раціоналізував сигнали з інших частин звіту.
Аналіз намагається визначити:
- слова всередині імені;
- ймовірну мову кожного слова;
- короткий сенс;
- один основний тип: dictionary word, descriptive phrase, personal name або brandable;
- додаткові типи, де це доречно: geographic, acronym і EMD;
- одну або кілька широких галузей;
- комерційну фразу, якщо ім’я схоже на exact-match domain;
- загальний рівень упевненості.
Ми використовуємо 17 широких галузевих категорій. Вони навмисно грубі. «Software» або «real estate» допомагають звузити великий список. Модель, яка з шести літер вигадує надто конкретний бізнес-план, — ні.
Та сама стриманість стосується типів імен. Основний тип має бути один. Ім’я не може водночас бути явною descriptive phrase і coined brandable лише тому, що модель хоче підстрахуватися. Geographic, acronym і EMD працюють як додаткові атрибути, бо відповідають на інші питання.
На папері це виглядало просто. Перші тести — ні.
Модель упевнено робила погані розбиття
Найчастіша помилка — сегментація слів.
Модель залишала очевидний компаунд на кшталт eightshapes злитим. На іншому імені видавала розбиття в дусі cop + salive, хоча другий токен не мав сенсу. Багатомовні рядки створювали свою проблему. Ім’я на кшталт vuelostime провокує конкуруючі іспанські й англійські прочитання, і модель могла стрибати між ними, не визнаючи неоднозначність.
Детекція мови дала інший клас помилок. Ранні версії виводили мову з TLD, вважали латинські символи доказом англійської або плутали топонім із мовою. Акроніми іноді розкривалися без підстав. Галузеві мітки розмножувалися, коли в слова був слабкий зв’язок одразу з кількома ринками.
Класифікація EMD хиталася в обидва боки. Вузький промпт пропускав корисні комерційні фрази. Ширший починав називати exact-match domain майже будь-яку описову комбінацію.
Ми пробували кілька сімейств моделей. Деякі повертали зіпсовані або обрізані структуровані дані. Швидші моделі частіше розмазували галузі за слабкими асоціаціями. Одна модель помітно краще робила лінгвістичний аналіз на тестовому батчі, але була занадто повільною й дорогою для потрібного нам обсягу.
Підвищення temperature не допомогло. Це були системні помилки, а не брак креативності.
Одна зміна справді покращила складні імена: спочатку попросити модель сформувати загальний сенс, а вже потім фіналізувати розбиття на слова. На thegeoffcapesfoundation семантичний контекст допоміг дійти до the / geoff / capes / foundation. Це не розв’язало кожен багатомовний чи неоднозначний випадок, але дало токенізації кращу точку старту.
Наш тестовий набір почав нам лестити
У якийсь момент ми додали в промпт кілька складних доменів і їхні правильні інтерпретації як приклади. Наступна оцінка виглядала набагато краще.
Занадто краще.
Ми знову й знову тестували частину тих самих доменів. Промпту по суті вже дали відповіді. Він міг відтворювати ці випадки, не вивчивши правило, яке переноситься на новий інвентар.
Ми прибрали доменно-специфічні приклади й переписали їх як загальні інструкції. Оцінки впали. Це було корисно: нижчий результат був чесним.
Ймовірно, це найважливіший урок розробки в проєкті. Промпт може виглядати чудово, коли тестовий набір у нього протікає. З доменними іменами цю помилку легко не помітити: кожен проблемний рядок здається особливим випадком, який варто додати як приклад.
Після цього ми оцінювали зміни на небачених іменах, приділяючи особливу увагу багатомовним рядкам, довгим компаундам, особистим іменам, акронімам і фразам, які можна сегментувати кількома способами.
Продакшен-контроли виявилися важливішими за промпт
Ми продовжували покращувати промпт, але в якийсь момент уперлися в спадну віддачу. Більше для довіри до фічі зробили продакшен-захисти.
Бекенд перевіряє, що кожен токен можна знову склеїти в початкове ім’я. Модель не може додати літеру, викинути символ або тихо «виправити» написання. Якщо розбиття не проходить валідацію, система відкочується до безпечнішого представлення.
Схема допускає лише один primary type — це не дає суперечливих відповідей у цьому полі. Відсутній аналіз залишається unknown. Ми не перетворюємо необроблену або провалену класифікацію на хибне «no». В інтерфейсі AI-фільтри й панель класифікації несуть попередження, що результат може бути неточним.
Цей підхід приймає незручний факт: деякі імена неоднозначні, і модель іноді помиляється. Контролі не дають дивній відповіді перетворитися на пошкоджену структуру або хибну впевненість.
Інвестор усе ще може знайти пропущеного кандидата сусідніми фільтрами. Система ніколи не повинна ховати сумнівний висновок за впевненим скором.
Чотири способи, як я використала б нові фільтри
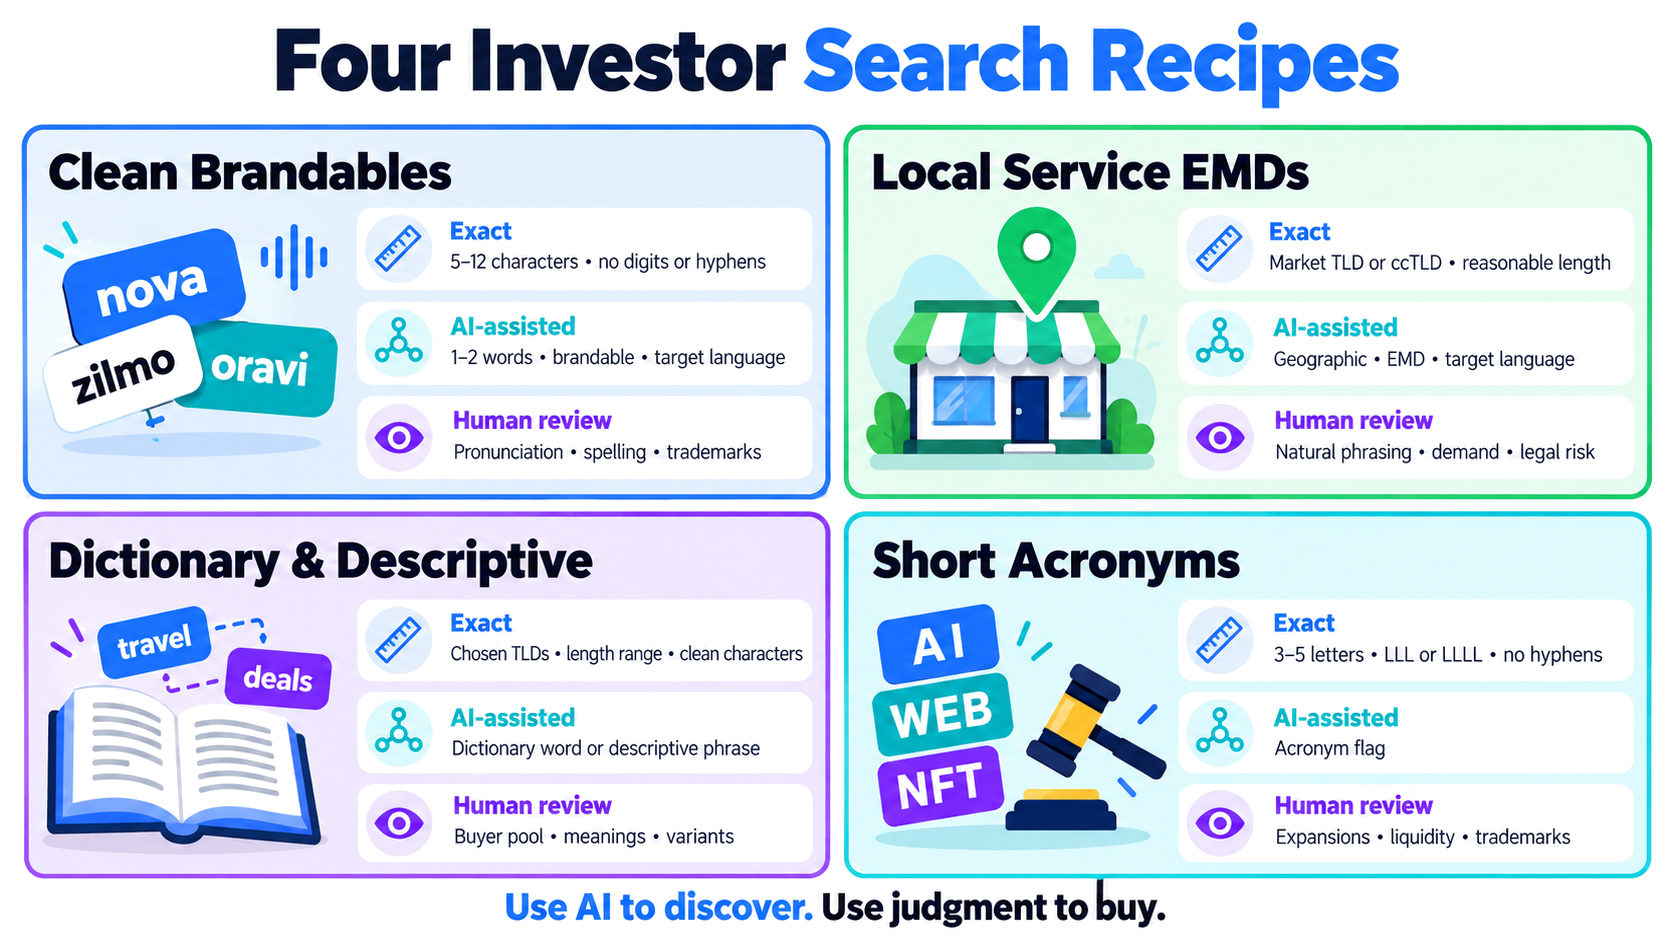
Практична цінність з’являється, коли точна структура й семантична класифікація працюють разом. Ось чотири стартові рецепти. Діапазони — приклади, а не універсальні правила купівлі.
| Стратегія | Структурні фільтри | AI-assisted фільтри | Ручна перевірка |
|---|---|---|---|
| Чисті brandables | 5–12 символів, без цифр і дефісів, обрані TLD | Одне або два слова, brandable, цільова мова, релевантна галузь | Вимова, написання, radio test, порівнянні продажі, торговельні марки |
| Локальні сервісні EMD | Ринковий TLD або ccTLD, розумна довжина, потрібний geo- або service-фрагмент | Geographic, EMD, цільова мова, сервісна галузь | Природність фрази, реальна пошукова поведінка, локальний попит, юридичний ризик |
| Словникові й описові імена | Обрані TLD, діапазон довжини, без небажаних символів | Dictionary word або descriptive phrase, мова, галузь | Пул покупців, альтернативні значення, множина, варіанти написання |
| Короткі акроніми | Три–п’ять літер, патерни на кшталт LLL або LLLL, без дефісів | Прапор acronym і мовний контекст, де доступний | Правдоподібні розшифровки, існуючі організації, ліквідність, торговельні марки |
Чисті brandables
Я б почала із того, що модель не може прочитати неправильно: TLD, довжина, цифри, дефіси й патерн. Потім додала б одне-два семантичні обмеження — наприклад, brandable плюс software.
Якщо список стає занадто малим, послаблюйте семантичне поле раніше структурних правил, які визначають стратегію. Неправильно розмічена галузь може сховати добре ім’я. Домен із 19 символів не стає шестилітерним brandable лише тому, що класифікатору він подобається.
Локальні сервісні імена
Geo-service комбінації більше виграють від семантичних фільтрів, бо важливі порядок і мова фрази. Шукайте прапорці geographic і EMD, потім дивіться фактичну токенізацію й значення у звіті.
Модель може розпізнати, що в імені є місто й послуга. Вона не скаже, чи вимовив би локальний клієнт цю фразу природно, чи пошуковий попит комерційно корисний і чи ринок уже не перенасичений.
Словникові слова й описові фрази
Мова тут корисний discovery-фільтр, особливо по ccTLD. Але до неї варто ставитися скептично. Короткі слова існують у кількох мовах, а власні імена часто схожі на словникові.
Перш ніж прийняти тип, я б подивилася на кольорову розбивку слів у звіті. Візуальне розбиття робить сумнівну інтерпретацію помітнішою, ніж гола мітка в таблиці.
Акроніми
Для коротких акронімів основну роботу робить структурний прохід. AI-прапор допомагає відокремити ймовірні ініціали від звичайних коротких слів, але він не знає кожну організацію, продукт чи нішеву абревіатуру.
У цій стратегії хибні спрацьовування дешеві. Помилки з торговельними марками — ні. Тримайте AI-поріг широким, а юридичні й end-user перевірки — суворими.
Як звіт підтримує рішення
Вкладка Domain name у звіті Karma.Domains показує обидва шари окремо.
Секція Structure містить вимірювання: довжина, цифри, дефіси, літерний патерн і патерн голосних. Секція Classification показує запропоноване розбиття на слова, сенс, тип, мови, галузі, EMD-фразу, кількість слів і впевненість.
Ми також використовуємо валідоване розбиття, щоб показати читабельну CamelCase-версію домену. Під час копіювання імені ви як і раніше отримуєте початковий lowercase-домен. Форматована версія потрібна, щоб список було легше сканувати, а не щоб змінювати актив.
Brand Score поруч для зручності, але залишається окремим сигналом. Аналіз імені не втягує його в новий «головний» скор.
Якщо ви переглядаєте лише кілька десятків доменів на місяць, багато з цього може бути зайвим. Імена можна читати самому. Фільтри стають корисні, коли в сирому списку тисячі кандидатів або коли кілька людей мають послідовно застосовувати ту саму портфельну тезу.
Ті самі поля працюють поза браузером
Ми вбудували фічу в існуючий пошуковий шар, тому поля імені доступні через вебінтерфейс, Public API Karma.Domains і MCP-сервер Karma.Domains.
У вебдодатку інвестор може комбінувати нові поля з джерелом аукціону, поточною ціною, часом закінчення, TLD, історією й SEO-фільтрами.
API підтримує повторювані пошуки всередині приватного дашборда, spreadsheet-пайплайну або портфельного workflow. Інвестор може зберегти тезу як параметри запиту й проганяти її по новому інвентарю, не збираючи екран заново щоразу.
MCP відкриває той самий пошук для ChatGPT, Claude та інших сумісних асистентів. Запит може бути розмовним:
Знайди короткі аукціонні
.comбез цифр і дефісів. Залиш одно- або двословні англійські імена, класифіковані як brandable у software або finance. Покажи розбивку імені й деталі аукціону.
Наступне повідомлення може скоригувати тезу:
Збережи структурні правила, прибери finance і додай descriptive phrases коротші за десять символів.
Природна мова спрощує ітерацію. Реальний пошук як і раніше роблять нижчі фільтри.
Де закінчується автоматизація
Аналіз імені не оцінює ціну продажу, не передбачає sell-through rate і не схвалює купівлю. Він не замінює перевірку торговельних марок, судження носія мови, аналіз порівнянних продажів або уважний погляд на архів і беклінк-профіль.
Він також не знає вашу вартість утримання, улюблені маркетплейси, толерантність до неліквідності чи доступ до ймовірних покупців. Ці змінні часто важливіші за ще один сигнал у звіті.
Мій улюблений workflow простий. Детермінованими фільтрами задайте форму активу. AI-полями дослідіть сенс і комерційний контекст. Відкрийте звіти по невеликій групі, що залишилася. Потім перевірте історію, посилання, юридичний ризик, порівнянні продажі й поточні умови аукціону — і лише потім ставте ставку.
Фіча виправдовує себе, коли перетворює 10 000 імен на 40, які варто прочитати. Обрати чотири, які варто купити, як і раніше робота інвестора.